키 복원 실패. 남아 있는 텍스트가 암호문 단독 해독에는 너무 짧다
2026년 9월, 네 구절 중 세 구절, 모두 969개의 글리프를 여기서 전사했다. 암호 시는 운을 맞춘 2행 연구 20행이며, 행 길이와 운이 모두 프랑스어 음절 문자, 즉 발음된 음절 하나에 글리프 하나를 가리킨다. 기호가 이만큼 많은 음절 문자는 하나의 키만 텍스트에 들어맞으려면 대략 800–2,000개의 글리프가 필요한데, 남아 있는 말뭉치 전체가 약 1,200개다. 크립으로 시험할 수 있었던 알려진 평문은 모두 실패했고, 키는 복원되지 않았다. 발표된 해독은 없으며, Sektu의 2017년 구조 분석이 주요한 선행 작업이다. 남은 일에는 이 프로젝트 바깥의 자료가 필요하다. Debosnys가 베낀 원문, 또는 그의 문서 가운데 있는 키 시트다.
01 이미 알려져 있던 것
흔한 요약이 말하는 것보다 많다. 2017년 Sektu 블로그를 쓰는 Brian은 말뭉치 전체(425종 1,188개 글리프)를 전사하고, 작은 문법으로 글리프를 하위 글리프로 분해했으며, 그것들이 프랑스어 음절이고 물결표는 비음화를 나타낸다고 제안했다. 그 전사는 발표되지 않았다. 이 프로젝트의 추적표 이전 판은 글리프의 체계적 구성을 새로운 관찰인 것처럼 제시했는데, 그것은 Sektu의 관찰이었으며 여기서 그의 공으로 밝힌다.
그 밖에 공개된 단서가 두 가지 있었다. Matthew Brown은 2021년, Debosnys가 남긴 평문 “시”가 거의 모두 베낀 것이며 대부분 토머스 무어의 것임을 보였는데, 이는 암호화된 텍스트도 베낀 것일 수 있음을 시사했다. 그리고 Nick Pelling은 2015년, 9번 구절에 평문 머리글자 H. D. D. L. M. F.가 있고 각 글자 아래의 점이 생략된 글자 수를 센다는 것을 알아챘다. Henry, Deletnack, Debosnys, 그리고 7, 7, 6글자로 된 세 단어다.
02 확립된 것
“monographe verse”는 운을 맞춘 2행 연구 20행이다
각 행의 마지막 글리프는 짝을 지어 반복된다. 2행 연구 10개 중 9개에서 동일하고, 열 번째 쌍은 바탕이 같고 십자의 위치만 다르다. 2행 연구의 경계를 넘어서는(2행과 3행, 4행과 5행 등) 9개 중 하나도 일치하지 않는다. 임의의 두 글리프가 5분의 1의 확률로 일치한다 해도, 10개 중 9개가 우연히 일치할 확률은 100만분의 4 정도다. 이것은 프랑스어 2행 연구 운문의 평탄한 AABB 각운이며, 첫 2행 연구의 운이 아홉 번째에서 소리처럼 되돌아온다.
글리프 하나는 프랑스어 음절 하나다
동일한 마지막 글리프가 운을 담고 있다면, 글리프는 소리를 나타낸다. 어떤 크기의 소리인지는 시를 실제 운문의 279단위 표본과 비교해 정한다.
| 단위 | 행당 | 279개 중 종류 수 | 최빈값 |
|---|---|---|---|
| Debosnys 글리프 | 13.9 | 111 | 9.0% |
| 프랑스어 음절 | 13.5 | 166 | 3.8% |
| 영어 음절 | 10.2 | 172 | 4.5% |
| 프랑스어 단어 | 8.6 | 174 | 4.7% |
| 프랑스어 글자 | 37.4 | 26 | 14.7% |
행 길이에 맞는 것은 음절뿐이고, 언어는 운이 결정한다. 실제 운을 맞춘 2행 연구에서 마지막 음절의 철자가 동일한 비율은 프랑스어 운문에서 61%지만 무어의 영어에서는 31%에 불과하다. 영어 음절이라면 10개 중 9개의 동일한 어미가 나올 확률은 1만분의 3 정도다. 따라서 평문은 프랑스어일 가능성이 가장 크다. Debosnys가 베낀 것으로 알려진 것은 거의 모두 영어였는데도 말이다.
텍스트는 언어처럼 행동한다. 반복되는 글리프 쌍이 같은 글리프를 뒤섞은 것보다 두 배 많이 나온다. 단순한 음절 문자에 맞지 않는 세부가 두 가지 있다. 점 찍힌 X는 9%로 단일 음절이라기에는 너무 잦고, 다섯 번 겹쳐 나오는데, 두 부분으로 된 하나의 기호일지도 모른다.
세 구절, 하나의 문자
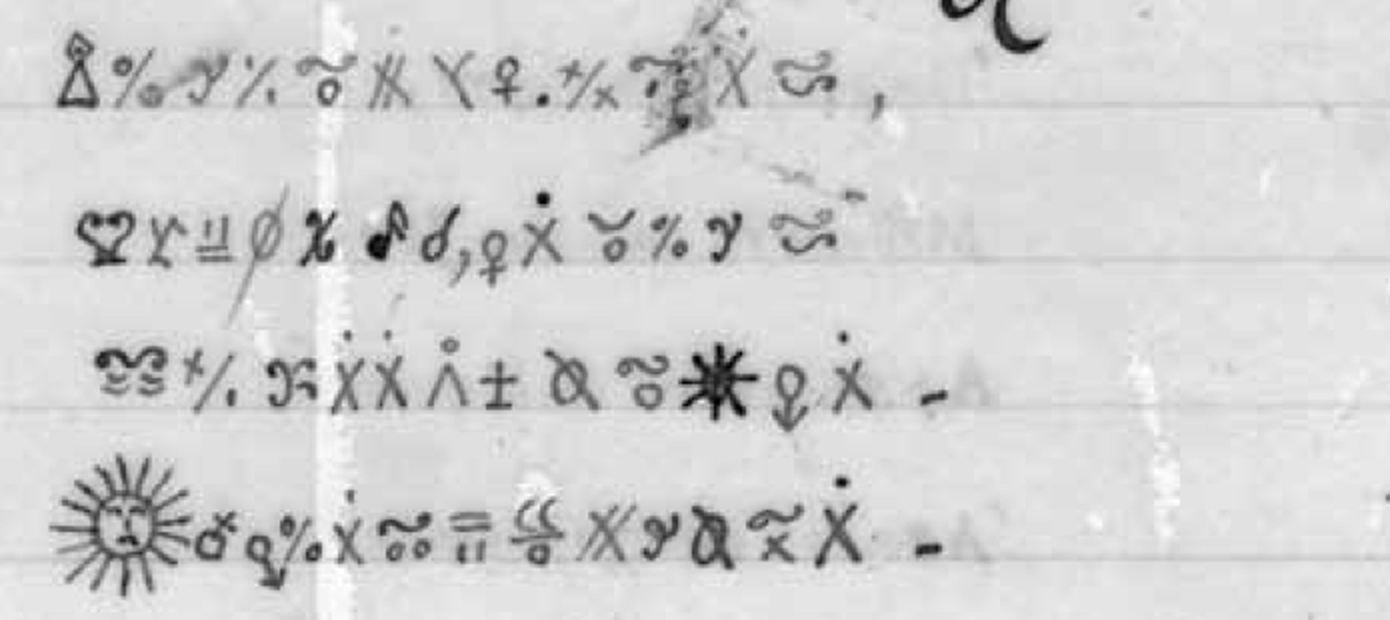
스캔본에서 글리프 하나하나 전사했다. 20행 시(279), 10번 쪽의 암호 네 행(99), 산문 구절 9번(597), 모두 333종 969개 글리프다. 구절들은 글리프 목록을 공유하며(시의 글리프 111종 중 47종이 9번에 다시 나오고, 시의 58%를 차지한다), 점 찍힌 X가 양쪽에서 9.0%와 8.2%로 가장 많다. 약점은 동일성 판단, 즉 비슷한 두 복합 글리프가 같은 기호인가 하는 것이다. 전사 파일에 각 판단을 기록했으며, 가장 읽기 어려운 행은 물 얼룩 아래에 있다.
03 배제된 것
여기서 한 모든 탐색은 먼저 심어 둔 텍스트(같은 방식으로 인코딩하고 잡음을 넣은 실제 프랑스어)에서 실행해, 적중이 있다면 찾아낼 것임을 보였다. 실제 탐색에서는 하나도 나오지 않았다.
10번의 암호 네 행은 그 아래에 쓰인 프랑스어 시를 인코딩한 것이 아니다
뻔한 크립이다. 약 93개의 글리프가, 첫 8행이 약 93음절인 평문 시 위에 있고, 둘 다 물음표로 끝난다. 글리프를 음절에 정렬하고 각 글리프가 얼마나 일관되게 대응하는지 채점하면, 실제 짝은 58점으로 무작위 프랑스어 운문(중앙값 59)과 같다. 같은 시를 심어 둔 인코딩은 86–88점으로, 대조 실험 최댓값 80을 넘는다. 이 행들은 9번의 끝일 가능성이 더 크다.
프랑스 시의 2행 연구 창 7,821개에서 일치 없음
28권(라신, 코르네유, 몰리에르, 볼테르, 부알로, 셰니에, 위고, 뮈세, 고티에, 보들레르, 베를렌)을 운을 맞춘 2행 연구로 된 모든 20행 창으로 잘라 시와 한 행씩 정렬했다. 실제 창 하나를 심어 둔 인코딩은 큰 차이로 7,821개 중 1위를 차지한다. 시의 최고 일치 결과들은 튀는 값 없이 매끄러운 꼬리를 이룬다. 시 아래에 베껴 쓴 베르길리우스의 시구에서 착안한, Delille의 아이네이스 운문 번역에 대해서도 마찬가지다.
무어도, Stoddart도, 그 자신의 영어 필사본도 아니다
무어의 시 전집, Lalla Rookh, Stoddart, Debosnys 자신의 평문 시에 대해 행 길이 분포와 2행 연구 구조를 비교했다. 7천 개 창에서 최고 적합도가 우연 수준이며, 무어의 2행 연구 행은 3–4음절 짧다.
글리프는 글자를 쌓은 것이 아니다
각 글리프의 구성 표시를 어떤 순서의 글자로 보고 키를 탐색하면, 프랑스어든 영어든 실제 글리프 순서는 같은 글리프를 뒤섞은 것보다 나은 점수를 내지 못한다.
04 여기서 멈추는 이유
암호문 단독 공격에는 키를 확정할 만큼 충분한 텍스트가 필요하다. 치환 암호의 경우 그 문턱은 유일성 거리, 즉 키의 정보량을 언어의 기호당 중복도로 나눈 값이다. 프랑스어 운문 음절은 바이그램 모델에서 각각 7.7비트를 담는다. 600–9,000개의 음절 목록에서 뽑은 333종 글리프의 키는 3,100–4,400비트를 담는다. 완벽한 모델과 완벽한 전사가 있다 해도 문턱은 약 800–2,000 글리프가 된다. 남아 있는 말뭉치 전체가 약 1,200개다.
실험 결과도 일치한다. 실제 프랑스어 운문을 깨끗한 음절 문자(음절 하나에 글리프 하나, 잡음 없음)로 인코딩하고, 115만 음절로 학습한 음절 언어 모델로 공략했다.
| 글리프 | 글리프 종류 | 복원된 텍스트 | 가장 흔한 음절로 추측하기 |
|---|---|---|---|
| 1,000 | 364 | 0.0% | 3.2% |
| 5,000 | 944 | 5.4% | 3.3% |
| 20,000 | 1,810 | 4.3% | 2.9% |
Debosnys의 길이에서 솔버는 아무것도 복원하지 못한다. 더 강한 솔버라면 훨씬 긴 텍스트에서 더 나은 성과를 내겠지만, 어떤 솔버도 정보 한계를 넘을 수는 없다. 운이 가리키듯 Debosnys가 음절 문자로 썼다면, 키를 복원할 수 있는 것은 크립뿐이다.
05 해답으로 이어질 수 있는 것
- 그의 문서. Essex County Historical Society가 원본을 소장하고 있다. 그 안에 시의 평문 사본, 초고, 또는 키 시트가 있다면 곧바로 키를 얻을 수 있을 것이다.
- 원문. 시나 9번이 그의 평문 시처럼 베낀 것이라면, 원본을 찾는 것이 일의 전부다. 탐색 도구는 만들어져 시험까지 끝났다. 아직 다루지 않은 가장 유력한 영역은 1860–70년대의 프랑스 대중가요와 운문이다.
- Sektu의 전사. 말뭉치 전체에 대한 독립적인 전사가 있으면, 모든 시험을 약하게 만드는 글리프 동일성 판단 문제를 해결할 수 있을 것이다.