没有复原出密钥;现存文本太短,无法做唯密文求解
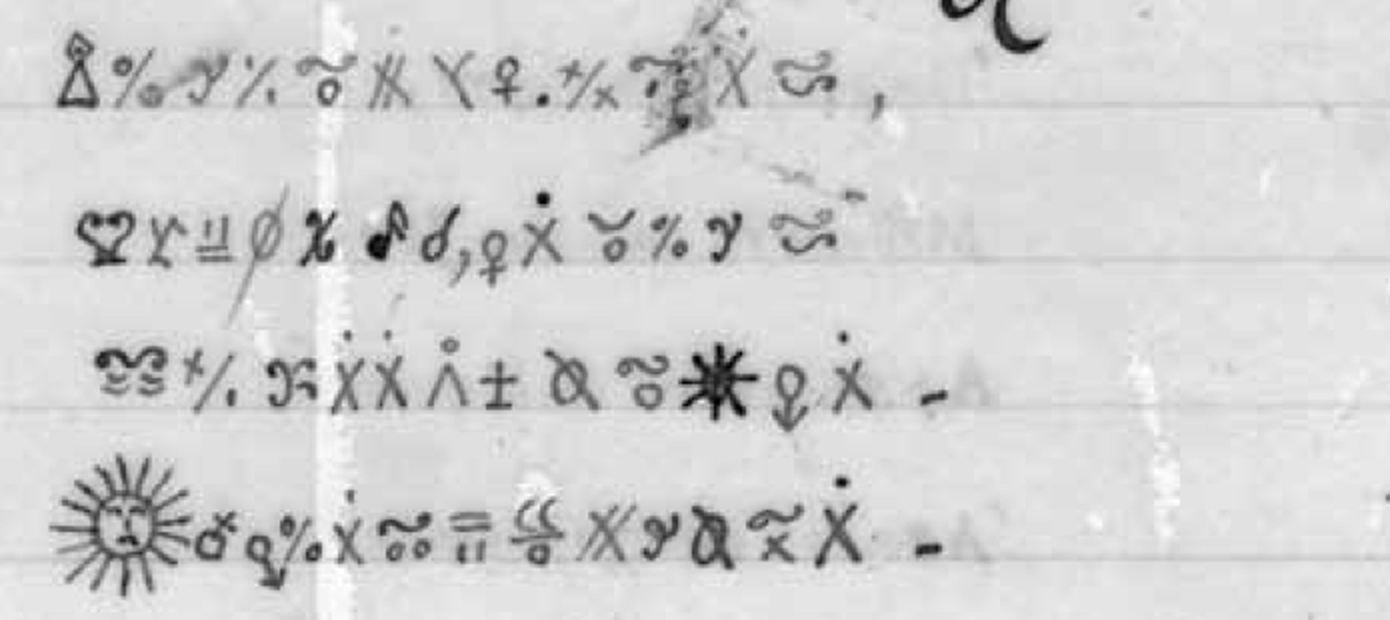
2026年9月,本项目转录了四段中的三段,共969个字形。那首密码诗是二十行押韵对句,其行长和韵脚都指向一种法语音节文字:一个字形对应一个口语音节。符号这么多的音节文字,大约需要800到2,000个字形,才能使只有一个密钥与文本相符,而现存语料总共约1,200个。所有可以作为猜词(crib)检验的已知明文都失败了,没有复原出密钥。从未有人发表过解读;Sektu 2017年对其结构的分析是此前的主要工作。剩下的工作需要本项目之外的资料:Debosnys 所抄写的原文,或他遗稿中的一张密钥纸。
01 此前已知的情况
比通常的概述所说的要多。2017年,Sektu 博客的作者 Brian 转录了全部语料(1,188个字形,425种),用一套小语法把字形分解为子字形,并提出它们是法语音节,波浪号表示鼻化。这份转录从未公开。本项目追踪表的早期版本曾把字形的系统性构成当作新发现提出;其实那是 Sektu 的发现,在此归功于他。
另有两条线索是公开的。Matthew Brown 在2021年表明,Debosnys 留下的明文“诗”几乎都是抄来的,大多抄自 Thomas Moore,这暗示加密的文本也可能是抄本。Nick Pelling 在2015年注意到,第9段中有明写的首字母 H. D. D. L. M. F.,每个字母下的圆点计数了省略的字母:Henry、Deletnack、Debosnys,然后是三个分别为7、7、6个字母的词。
02 已确定的事实
“monographe verse”是二十行押韵对句
每行的最后一个字形成对重复。在10组对句中的9组里完全相同,第十对的基本形相同,只是十字的位置不同。跨对句边界(第2和第3行、第4和第5行,依此类推)则9处中无一相同。即使任意两个字形有五分之一的机会相同,十中有九纯属偶然的概率也只有大约百万分之四。这正是法语对句诗平直的 AABB 韵式,而且第一组对句的韵在第九组中再次出现,正如一个读音会重现那样。
一个字形对应一个法语音节
如果相同的末尾字形承载韵脚,那么字形代表的是读音。至于是多大的读音单位,可以通过把这首诗与279个单位的真实诗歌样本比较来确定:
| 单位 | 每行 | 279个中的种类数 | 最常见 |
|---|---|---|---|
| Debosnys 字形 | 13.9 | 111 | 9.0% |
| 法语音节 | 13.5 | 166 | 3.8% |
| 英语音节 | 10.2 | 172 | 4.5% |
| 法语单词 | 8.6 | 174 | 4.7% |
| 法语字母 | 37.4 | 26 | 14.7% |
只有音节符合行长,而韵脚决定了语言。在真实的押韵对句中,法语诗的末音节有61%拼写完全相同,而 Moore 的英语诗只有31%。如果是英语音节,十个结尾中有九个相同的概率约为万分之三。所以明文最有可能是法语,尽管已知 Debosnys 抄写的东西几乎全是英语。
这段文本的表现像语言:重复的字形对出现的频率是同一批字形随机打乱后的两倍。有两个细节不符合单纯的音节文字。带点的 X 出现频率高达9%,作为单个音节过于频繁;而且它五次成对出现,或许是一个分成两部分的符号。
三段文字,同一种文字
根据扫描件逐个字形转录:二十行的诗(279个字形)、第10页上的四行密码(99个)和散文段落第9段(597个),共969个字形,333种。这几段共用同一套字形库(诗中111种字形里有47种在第9段中重现,覆盖诗的58%),带点的 X 在两者中都居首位,分别占9.0%和8.2%。薄弱之处在于同一性判定:两个相似的复合字形是否为同一个符号。转录文件记录了每一项判定,最难辨认的一行位于一块水渍之下。
03 已排除的可能
这里的每一次搜索都先在一段植入的文本(用同样方式编码并加入噪声的真实法语)上运行,以证明如果确有匹配,搜索能找到它。真实的搜索没有一次找到匹配。
第10页的四行密码并不是对写在其下方那首法语诗的编码
这是最显而易见的猜词:约93个字形位于一首明文诗之上,而那首诗前八行约有93个音节,两者都以问号结尾。把字形与音节对齐,并按每个字形映射的一致程度打分,真实的配对得58分,与随机的法语诗相同(中位数59)。同一首诗的植入编码得86到88分,而对照的最高分为80。这几行更可能是第9段的结尾。
在7,821个法语诗对句窗口中无一匹配
二十八卷作品(拉辛、高乃依、莫里哀、伏尔泰、布瓦洛、谢尼埃、雨果、缪塞、戈蒂耶、波德莱尔、魏尔伦)被切成所有押韵对句的20行窗口,与这首诗逐行对齐。用一个真实窗口植入的编码以很大优势在7,821个中排第一;而这首诗的最佳匹配构成一条平滑的尾部,没有离群值。Delille 翻译的《埃涅阿斯纪》诗体译本也是如此——之所以测它,是因为诗下方抄有维吉尔的诗句。
不是 Moore,不是 Stoddart,也不是他自己的英语抄本
将行长分布和对句结构与 Moore 的全部诗作、Lalla Rookh、Stoddart 以及 Debosnys 本人的明文诗比较:在七千个窗口中,最佳契合度都处于偶然水平,而且 Moore 的对句诗行要短三四个音节。
字形不是字母的堆叠
把每个字形的组成笔画按某种顺序视为字母并搜索密钥,无论法语还是英语,真实字形顺序的得分都不比同一批字形随机打乱后更好。
04 为何止步于此
唯密文攻击需要足够的文本来确定密钥。对替换密码而言,这个阈值是唯一解距离:密钥的信息量除以语言中每个符号的冗余度。在二元模型下,法语诗的音节每个携带7.7比特;一个对应333种字形、取自600到9,000个音节库的密钥,携带3,100到4,400比特。算出的阈值约为800到2,000个字形,这还是在模型和转录都完美的前提下。现存语料总共约1,200个。
实验结果与此一致。把真实的法语诗编码成干净的音节文字,每个音节一个字形,不加噪声,再用一个在115万个音节上训练的音节语言模型攻击:
| 字形数 | 字形种类 | 复原的文本 | 猜最常见的音节 |
|---|---|---|---|
| 1,000 | 364 | 0.0% | 3.2% |
| 5,000 | 944 | 5.4% | 3.3% |
| 20,000 | 1,810 | 4.3% | 2.9% |
在 Debosnys 文本的长度下,求解器什么也复原不出来。更强的求解器在长得多的文本上会做得更好,但没有哪个能突破信息极限。如果 Debosnys 写的是音节文字——正如韵脚所示——那么只有猜词能复原密钥。
05 什么可能带来解答
- 他的遗稿。Essex County Historical Society 收藏着原件。其中若有这首诗的明文抄本、一份草稿或一张密钥纸,就能直接得到密钥。
- 原文。如果这首诗或第9段像他的明文诗一样是抄来的,那么找到原文就是全部工作。搜索工具已经做好并测试过;尚未覆盖、可能性最大的范围是1860和1870年代的法国流行歌曲和诗歌。
- Sektu 的转录。一份独立的全语料转录能解决那些削弱了每一项检验的字形同一性判定。