沒有復原出金鑰;現存文字太短,無法做唯密文求解
2026年9月,本專案轉錄了四段中的三段,共969個字形。那首密碼詩是二十行押韻對句,其行長和韻腳都指向一種法語音節文字:一個字形對應一個口語音節。符號這麼多的音節文字,大約需要800到2,000個字形,才能使只有一個金鑰與文字相符,而現存語料總共約1,200個。所有可以作為猜詞(crib)檢驗的已知明文都失敗了,沒有復原出金鑰。從未有人發表過解讀;Sektu 2017年對其結構的分析是此前的主要工作。剩下的工作需要本專案之外的資料:Debosnys 所抄寫的原文,或他遺稿中的一張金鑰紙。
01 此前已知的情況
比通常的概述所說的要多。2017年,Sektu 部落格的作者 Brian 轉錄了全部語料(1,188個字形,425種),用一套小語法把字形分解為子字形,並提出它們是法語音節,波浪號表示鼻化。這份轉錄從未公開。本專案追蹤表的早期版本曾把字形的系統性構成當作新發現提出;其實那是 Sektu 的發現,在此歸功於他。
另有兩條線索是公開的。Matthew Brown 在2021年表明,Debosnys 留下的明文“詩”幾乎都是抄來的,大多抄自 Thomas Moore,這暗示加密的文字也可能是抄本。Nick Pelling 在2015年注意到,第9段中有明寫的首字母 H. D. D. L. M. F.,每個字母下的圓點計數了省略的字母:Henry、Deletnack、Debosnys,然後是三個分別為7、7、6個字母的詞。
02 已確定的事實
“monographe verse”是二十行押韻對句
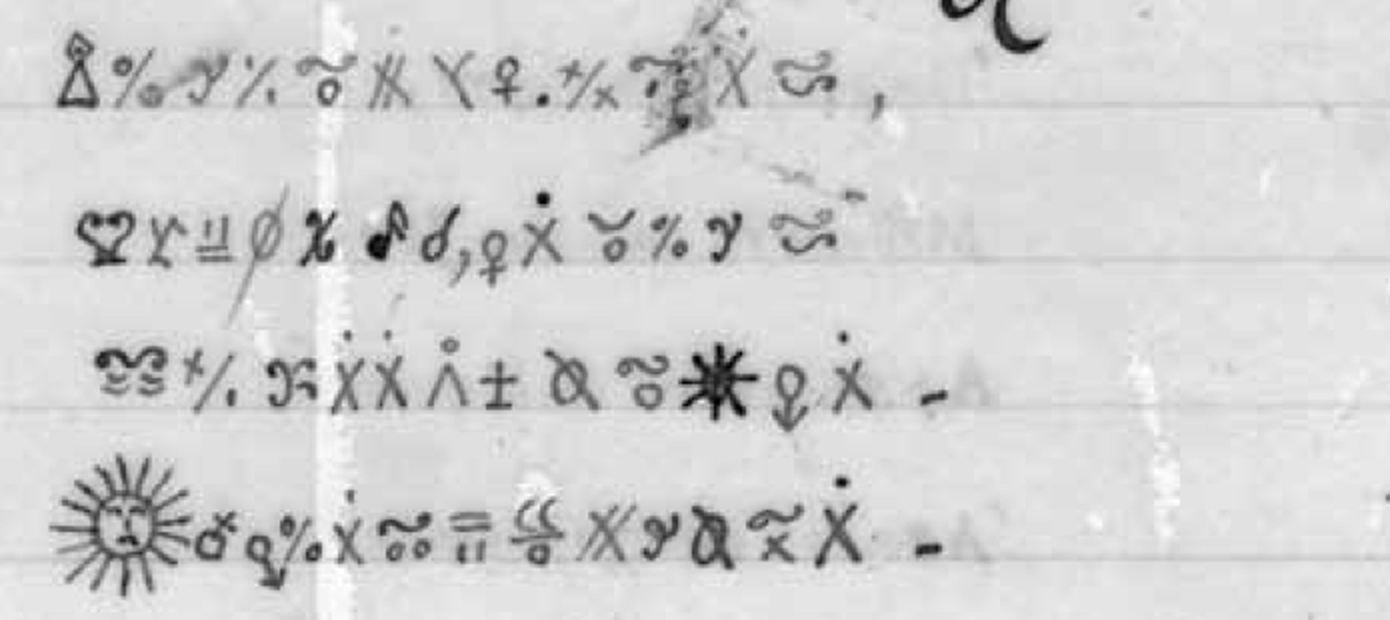
每行的最後一個字形成對重複。在10組對句中的9組裡完全相同,第十對的基本形相同,只是十字的位置不同。跨對句邊界(第2和第3行、第4和第5行,依此類推)則9處中無一相同。即使任意兩個字形有五分之一的機會相同,十中有九純屬偶然的機率也只有大約百萬分之四。這正是法語對句詩平直的 AABB 韻式,而且第一組對句的韻在第九組中再次出現,正如一個讀音會重現那樣。
一個字形對應一個法語音節
如果相同的末尾字形承載韻腳,那麼字形代表的是讀音。至於是多大的讀音單位,可以透過把這首詩與279個單位的真實詩歌樣本比較來確定:
| 單位 | 每行 | 279箇中的種類數 | 最常見 |
|---|---|---|---|
| Debosnys 字形 | 13.9 | 111 | 9.0% |
| 法語音節 | 13.5 | 166 | 3.8% |
| 英語音節 | 10.2 | 172 | 4.5% |
| 法語單詞 | 8.6 | 174 | 4.7% |
| 法語字母 | 37.4 | 26 | 14.7% |
只有音節符合行長,而韻腳決定了語言。在真實的押韻對句中,法語詩的末音節有61%拼寫完全相同,而 Moore 的英語詩只有31%。如果是英語音節,十個結尾中有九個相同的機率約為萬分之三。所以明文最有可能是法語,儘管已知 Debosnys 抄寫的東西幾乎全是英語。
這段文字的表現像語言:重複的字形對出現的頻率是同一批字形隨機打亂後的兩倍。有兩個細節不符合單純的音節文字。帶點的 X 出現頻率高達9%,作為單個音節過於頻繁;而且它五次成對出現,或許是一個分成兩部分的符號。
三段文字,同一種文字
根據掃描件逐個字形轉錄:二十行的詩(279個字形)、第10頁上的四行密碼(99個)和散文段落第9段(597個),共969個字形,333種。這幾段共用同一套字形庫(詩中111種字形裡有47種在第9段中重現,覆蓋詩的58%),帶點的 X 在兩者中都居首位,分別佔9.0%和8.2%。薄弱之處在於同一性判定:兩個相似的複合字形是否為同一個符號。轉錄檔案記錄了每一項判定,最難辨認的一行位於一塊水漬之下。
03 已排除的可能
這裡的每一次搜尋都先在一段植入的文字(用同樣方式編碼並加入噪聲的真實法語)上執行,以證明如果確有匹配,搜尋能找到它。真實的搜尋沒有一次找到匹配。
第10頁的四行密碼並不是對寫在其下方那首法語詩的編碼
這是最顯而易見的猜詞:約93個字形位於一首明文詩之上,而那首詩前八行約有93個音節,兩者都以問號結尾。把字形與音節對齊,並按每個字形對映的一致程度打分,真實的配對得58分,與隨機的法語詩相同(中位數59)。同一首詩的植入編碼得86到88分,而對照的最高分為80。這幾行更可能是第9段的結尾。
在7,821個法語詩對句視窗中無一匹配
二十八卷作品(拉辛、高乃依、莫里哀、伏爾泰、布瓦洛、謝尼埃、雨果、繆塞、戈蒂耶、波德萊爾、魏爾倫)被切成所有押韻對句的20行視窗,與這首詩逐行對齊。用一個真實視窗植入的編碼以很大優勢在7,821箇中排第一;而這首詩的最佳匹配構成一條平滑的尾部,沒有離群值。Delille 翻譯的《埃涅阿斯紀》詩體譯本也是如此——之所以測它,是因為詩下方抄有維吉爾的詩句。
不是 Moore,不是 Stoddart,也不是他自己的英語抄本
將行長分佈和對句結構與 Moore 的全部詩作、Lalla Rookh、Stoddart 以及 Debosnys 本人的明文詩比較:在七千個視窗中,最佳契合度都處於偶然水平,而且 Moore 的對句詩行要短三四個音節。
字形不是字母的堆疊
把每個字形的組成筆畫按某種順序視為字母並搜尋金鑰,無論法語還是英語,真實字形順序的得分都不比同一批字形隨機打亂後更好。
04 為何止步於此
唯密文攻擊需要足夠的文字來確定金鑰。對替換密碼而言,這個閾值是唯一解距離:金鑰的資訊量除以語言中每個符號的冗餘度。在二元模型下,法語詩的音節每個攜帶7.7位元;一個對應333種字形、取自600到9,000個音節庫的金鑰,攜帶3,100到4,400位元。算出的閾值約為800到2,000個字形,這還是在模型和轉錄都完美的前提下。現存語料總共約1,200個。
實驗結果與此一致。把真實的法語詩編碼成乾淨的音節文字,每個音節一個字形,不加噪聲,再用一個在115萬個音節上訓練的音節語言模型攻擊:
| 字形數 | 字形種類 | 復原的文字 | 猜最常見的音節 |
|---|---|---|---|
| 1,000 | 364 | 0.0% | 3.2% |
| 5,000 | 944 | 5.4% | 3.3% |
| 20,000 | 1,810 | 4.3% | 2.9% |
在 Debosnys 文字的長度下,求解器什麼也復原不出來。更強的求解器在長得多的文字上會做得更好,但沒有哪個能突破資訊極限。如果 Debosnys 寫的是音節文字——正如韻腳所示——那麼只有猜詞能復原金鑰。
05 什麼可能帶來解答
- 他的遺稿。Essex County Historical Society 收藏著原件。其中若有這首詩的明文抄本、一份草稿或一張金鑰紙,就能直接得到金鑰。
- 原文。如果這首詩或第9段像他的明文詩一樣是抄來的,那麼找到原文就是全部工作。搜尋工具已經做好並測試過;尚未覆蓋、可能性最大的範圍是1860和1870年代的法國流行歌曲和詩歌。
- Sektu 的轉錄。一份獨立的全語料轉錄能解決那些削弱了每一項檢驗的字形同一性判定。