鍵は復元されず、現存するテキストは暗号文のみからの解読には短すぎる
4つの文章のうち3つを2026年9月にここで転写した。計969字形である。暗号の詩は押韻する二行連句20行で、行の長さと韻はどちらもフランス語の音節文字、つまり話し言葉の1音節に1字形を指している。これほど多くの記号を持つ音節文字では、テキストに合う鍵が1つに絞られるまでにおよそ800から2,000字形が必要だが、現存するコーパス全体は約1,200である。クリブとして検証できた既知の平文はすべて失敗し、鍵は復元されなかった。解読は公表されておらず、構造に関する Sektu の2017年の分析が主要な先行研究である。残る課題には本プロジェクトの外にある資料が必要である:Debosnys が書き写した原典か、彼の文書の中にある鍵の紙である。
01 既に知られていたこと
通常の要約が述べるより多い。2017年、Sektu ブログを書いている Brian がコーパス全体(425種類、1,188字形)を転写し、小さな文法で字形を下位字形に分解して、それらがフランス語の音節であり、チルダが鼻音化を示すと提案した。この転写は公表されなかった。本プロジェクトの追跡表の以前の版では、字形の体系的な構成を新しい観察として示していたが、それは Sektu のものであり、ここでは彼の功績として記す。
さらに2つの手がかりが公開されていた。Matthew Brown は2021年、Debosnys が残した平文の「詩」のほとんどすべてが、主に Thomas Moore からの書き写しであることを示した。これは暗号化されたテキストも書き写しかもしれないことを示唆した。また Nick Pelling は2015年、第9文章に平文の頭文字 H. D. D. L. M. F. があり、各文字の下の点が省略された文字数を数えていることに気づいた:Henry、Deletnack、Debosnys、そして7文字、7文字、6文字の3語である。
02 確立されたこと
「monographe verse」は押韻する二行連句20行である
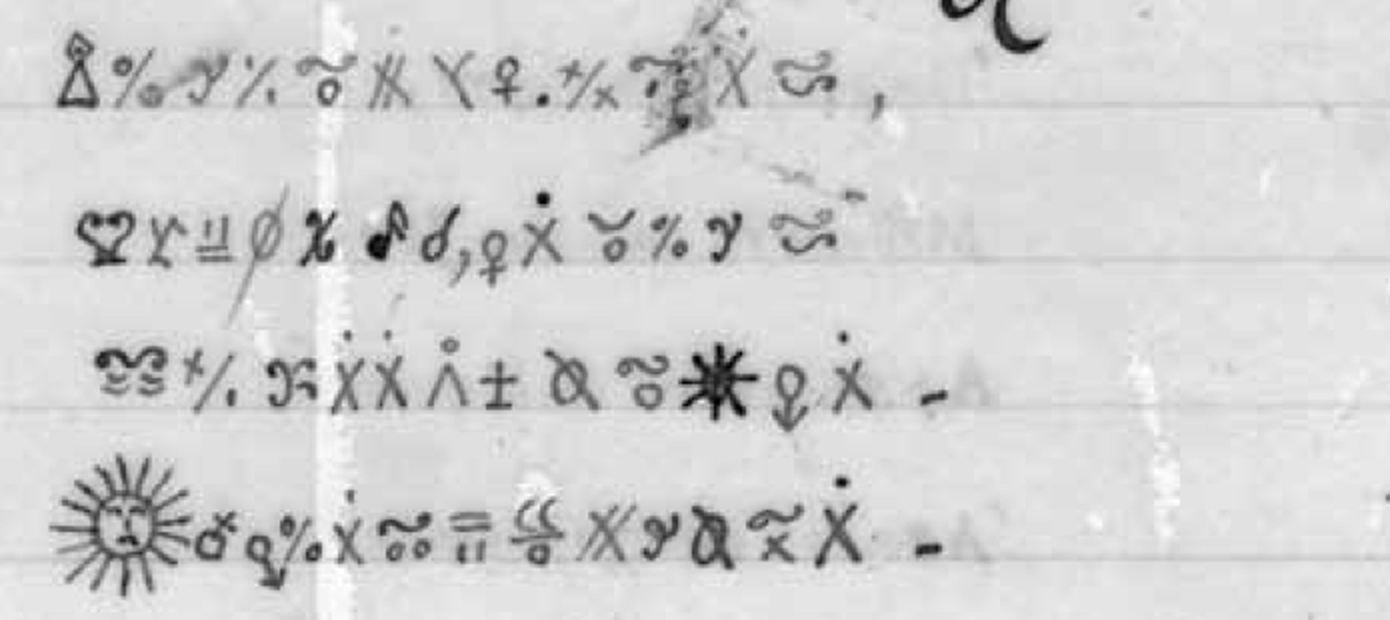
各行の最後の字形は対になって繰り返される。10組の連句のうち9組で同一であり、10組目も基部を共有し、十字の位置だけが異なる。連句の境界をまたぐと(第2行と第3行、第4行と第5行など)、一致は9組中0組である。仮に任意の2つの字形が5回に1回一致するとしても、10組中9組が偶然に生じる確率は100万分の4程度である。これはフランス語の二行連句詩の平板な AABB 押韻であり、最初の連句の韻が、音であればそうなるように9組目で戻ってくる。
1字形はフランス語の1音節である
同一の末尾字形が韻を担うなら、字形は音を表す。どの大きさの音かは、詩を本物の詩の279単位のサンプルと比較することで決まる:
| 単位 | 1行あたり | 279中の種類数 | 最頻 |
|---|---|---|---|
| Debosnys の字形 | 13.9 | 111 | 9.0% |
| フランス語の音節 | 13.5 | 166 | 3.8% |
| 英語の音節 | 10.2 | 172 | 4.5% |
| フランス語の単語 | 8.6 | 174 | 4.7% |
| フランス語の文字 | 37.4 | 26 | 14.7% |
行の長さに合うのは音節だけであり、言語は韻で決まる。実際の押韻二行連句では、末尾の音節が同一に綴られるのはフランス語の詩では61%だが、Moore の英語では31%にすぎない。英語の音節で10組中9組が同一の語尾になるのは、およそ1万回に3回である。したがって、Debosnys が書き写したと知られているもののほとんどすべてが英語であったにもかかわらず、平文はおそらくフランス語である。
テキストは言語のように振る舞う:繰り返される字形の対は、同じ字形をシャッフルしたものの2倍の頻度で現れる。2つの細部が単純な音節文字に合わない。点付きの X は9%と、単一の音節としては頻度が高すぎ、また5回二重に現れる。おそらく2つの部分からなる1つの記号であろう。
3つの文章、1つの文字体系
スキャンから字形ごとに転写した:20行の詩(279字形)、第10ページの暗号4行(99)、散文の第9文章(597)、計333種類969字形である。文章は字形の目録を共有しており(詩の111種類のうち47種類が第9文章に再出し、詩の58%を占める)、点付きの X がどちらでも9.0%と8.2%で首位である。弱点は同一性、つまり2つの似た合成字形が同じ記号かどうかである。転写ファイルには各判断が記録されており、最も判読しにくい行は水染みの下にある。
03 排除されたこと
ここでの探索はすべて、まず仕込んだテキスト(同じ方法で符号化し、雑音を加えた本物のフランス語)で実行し、該当があれば見つけられることを示した。実際の探索ではいずれも該当は得られなかった。
第10ページの暗号4行は、その下に書かれたフランス語の詩を符号化したものではない
明白なクリブである:約93字形が平文の詩の上にあり、その詩の最初の8行は約93音節で、どちらも疑問符で終わる。字形を音節に対応させ、各字形の対応の一貫性を評価すると、実際の組み合わせのスコアは58で、無作為なフランス語詩と同じである(中央値59)。同じ詩を仕込んで符号化したものは86から88となり、対照の最大値は80である。この4行はむしろ第9文章の末尾である可能性が高い。
フランス語詩の7,821の連句窓に一致なし
28巻(ラシーヌ、コルネイユ、モリエール、ヴォルテール、ボワロー、シェニエ、ユゴー、ミュッセ、ゴーティエ、ボードレール、ヴェルレーヌ)を、押韻二行連句の20行の窓すべてに切り分け、詩と1行ずつ照合した。本物の窓の1つを仕込んで符号化したものは、大差で7,821中の1位となる。詩の最良の一致は外れ値のない滑らかな裾野をなす。詩の下に書き写されたウェルギリウスの詩句から思いついた、Delille によるアエネーイスの韻文訳についても同様である。
Moore でも Stoddart でも、彼自身の英語の写しでもない
Moore の全詩集、Lalla Rookh、Stoddart、Debosnys 自身の平文の詩に対する行長の分布と連句構造:7千の窓について最良の適合は偶然の水準にとどまり、Moore の連句の行は3、4音節短い。
字形は文字の積み重ねではない
各字形の構成要素を何らかの順序の文字とみなして鍵を探索しても、実際の字形の順序は、同じ字形をシャッフルしたものより良いスコアにならない。フランス語でも英語でも同様である。
04 ここで止まる理由
暗号文のみからの攻撃には、鍵を確定できるだけのテキストが必要である。換字式の場合、その閾値は一意性距離、すなわち鍵の情報量を言語の記号あたりの冗長度で割ったものである。フランス語の詩の音節は bigram モデルで1つあたり7.7ビットを持つ。600から9,000の音節目録から選ばれる333種類の字形の鍵は3,100から4,400ビットを持つ。閾値は、完全なモデルと完全な転写があっても約800から2,000字形となる。現存するコーパス全体は約1,200である。
実験もこれと一致する。本物のフランス語詩を、1音節1字形で雑音のない純粋な音節文字として符号化し、115万音節で学習した音節言語モデルで攻撃した:
| 字形数 | 字形の種類数 | 復元されたテキスト | 最頻の音節を当てずっぽうで入れた場合 |
|---|---|---|---|
| 1,000 | 364 | 0.0% | 3.2% |
| 5,000 | 944 | 5.4% | 3.3% |
| 20,000 | 1,810 | 4.3% | 2.9% |
Debosnys の長さでは、ソルバーは何も復元しない。より強力なソルバーなら、はるかに長いテキストではより良い結果を出すだろうが、情報量の限界を超えられるものはない。韻が示すように Debosnys が音節文字を書いたのなら、鍵を復元できるのはクリブだけである。
05 解決につながりうるもの
- 彼の文書。Essex County Historical Society が原本を所蔵している。その中に詩の平文の写し、下書き、あるいは鍵の紙があれば、直接鍵が得られる。
- 原典。詩または第9文章が彼の平文の詩と同様に書き写されたものなら、原典を見つけることがすべてである。探索ツールは構築済みで検証もされている。まだ調べていない最も有望な領域は、1860年代と70年代のフランスの大衆歌謡と詩である。
- Sektu の転写。コーパス全体の独立した転写があれば、あらゆる検証を弱めている字形の同一性の判断に決着がつく。