한눈에 보기미해독 · 등록된 가설 2,727건 중 1,425건 유지
- 텍스트
- 출발점은 Asko Parpola의 강연 “Study of the Indus Script”(ICES Tokyo 2005, harappa.com에 게재)였다. 그 바탕이 되는 명문은 약 4,500개의 인장, 판, 도편으로, 대부분 기호가 다섯 개 미만이다.
- 소장처
- 서로 독립적으로 만들어진 기계 판독 가능한 전사 두 가지: Interactive Corpus of Indus Texts(ICIT; Wells와 Fuls)에서 파생된 데이터베이스와 Mahadevan의 1977년 용어 색인(M77). 여기서 둘을 기호 단위로 연결했다. Parpola 자신의 Corpus of Indus Seals and Inscriptions를 디지털화한 것이 세 번째 검증 자료로 쓰였다.
- 문자
- 약 400–600개의 기호로, 대부분 오른쪽에서 왼쪽으로 쓰였으며, 단어 구분자도, 이중 언어 자료도, 알려진 언어도 없다.
- 시도한 방법
- 먼저 Parpola의 강연과 1994년 판독 표에 나오는 모든 수치를 다시 계산했고, 그의 타밀어 검증에 우연 기준선을 부여했다. 그런 다음 데이터를 보기 전에 가설 247세트, 모두 2,727건을 적어 커밋했다. 각 가설을 검정해 유지되었는지 실패했는지를 기록했고, 주요 결과는 따로 떼어 둔 표본과, 읽을 수 있는 두 문자(선문자 B, 우르 3왕조 쐐기문자)에 대해 다시 돌렸다.
- 그 결과
- 음가 없는 상세한 문법. 이름은 한 자리로 끝나는데, 그 형태(740, 520 또는 종결자)는 이름의 마지막 기호가 정한다. 서기들은 결합된 쌍이나 이름과 그 어미를 줄을 넘겨 가르는 일이 결코 없다. 숫자는 그것이 세는 기호와 고정되어 있다. 인장의 이름은 같은 길이의 선문자 B 이름처럼 개인 이름으로 행동한다. Parpola의 별 이름 판독은 각각 인장 한두 개에 기대고 있다.
- 미해결
- 음성에 관한 모든 것, 그리고 언어. 타밀나두 상금이 요구할 기준(12절)에 견주면, 해독을 판가름하는 단계들은 거의 0이다. 이 프로젝트 자체의 앞선 결론 몇 가지는 나중의 검정으로 철회되었으며, 14절에 나열해 두었다.
01 코퍼스와 기호
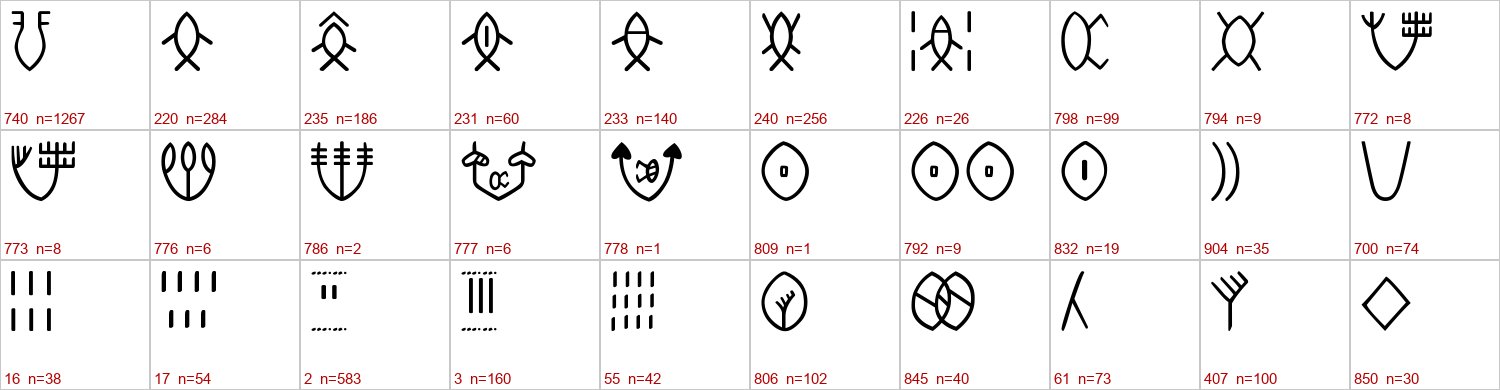
Parpola의 논증은 수치다. 가장 흔한 기호가 얼마나 자주 나오는지, 어떤 기호들이 함께 서는지, 어떤 기호들은 결코 그러지 않는지. 이를 다시 돌리기 위해 이 프로젝트는 서로 독립적으로 만들어진 두 전사를 썼다. 첫째는 indus-website 프로젝트와 함께 공개된, Interactive Corpus of Indus Texts(Wells와 Fuls)에서 파생된 데이터베이스로, 대상물 2,543개, 기호 11,253개이며 CISI 대상물 번호, 유적, 문양이 딸려 있다. 나중의 검정 대부분에는 같은 데이터베이스의 더 완전한 내보내기(기록 5,680건, 발견 지점, 층위, 크기, 재질 포함)를 썼다. 그 기호 총계는 확인한 기호들에 대해 Fuls의 Catalog of Indus Signs(2023)에 인쇄된 총계와 거의 일치한다. ICIT 기호는 번호뿐이므로, 데이터베이스 자체의 글꼴로 각 기호를 그려 Parpola의 기술과 맞춰 보는 방식으로 식별했다. 둘째 전사는 Mahadevan의 1977년 용어 색인(텍스트 2,906개)이다. 두 기호 목록은 공유하는 텍스트를 정렬해 연결했다. 991행이며, 기호의 96%가 단일 대응 기호에 대응한다. 첫째 코퍼스에 없는 M77 텍스트 1,664개는 내내 독립된 재현 표본으로 쓰였다.
02 강연의 주장을 검증하다
- 가장 흔한 기호(‘항아리’, 740)는 전체 기호의 거의 10%다. M77에서 9.9%, ICIT에서 11.3%. 남아시아에서는 결코 자기 자신 옆에 서지 않는다(각 행 안의 순서를 뒤섞을 때의 기댓값 4.0에 대해 0, p 약 0.007). 각 코퍼스에서 한 번씩 그렇게 하는데, Parpola가 말하듯 출토지 미상의 같은 둥근 인장에서다.
- 걸프와 메소포타미아에서 발견된 인장은 흔한 기호를 드문 순서로 쓴다. 사각 인장 하나(오만의 Salut)도 드문 순서인데, 이는 강연과 어긋난다.
- 물고기 기호는 인장 기호의 9.7%다. 게는 우연보다 훨씬 자주 물고기 기호 옆에 서지만, 단순한 물고기가 아니라 표시가 붙은 물고기 옆이다.
- 큰곰자리로 읽히는 ‘7 + 물고기’는 두 코퍼스 모두에서 하라파에서 나온 인장 하나에 한 번 나온다. 북극성인 ‘무화과 + 물고기’는 두 번 나온다(M-172, 그리고 CISI 1권의 사진으로 확인한 M-414).
- 물고기 앞의 숫자. Parpola는 ‘6 + 물고기’(플레이아데스)를 가장 흔한 숫자 + 물고기 연쇄라고 부른다. 서로 다른 텍스트를 한 번씩만 세면 가장 흔한 것은 ‘2 + 물고기’(텍스트 113개)이고, 다음이 ‘3 + 물고기’(28)이며, ‘6 + 물고기’는 8개다. CISI 디지털화본에 있는 Parpola 자신의 전사도 그것이 다루는 인장들에서 같은 답을 준다. 2 + 물고기가 열세 번, 6 + 물고기는 한 번도 없다. 모든 사본을 세든, Mahadevan의 전사를 쓰든, 여전히 2 + 물고기가 가장 흔하다(117건과 123건, 6 + 물고기는 9건과 12건). 세 전사와 두 가지 세는 방식이 일치하므로, 이 차이는 ICIT가 기호를 식별하는 방식의 문제가 아니다. ‘2’의 일부는 긴 획 쌍(113행 중 51행)인데, Parpola는 이를 숫자가 아니라 vēḷ로 읽으며, 긴 쌍 + 물고기가 그의 ‘금성’이다. 그것을 빼더라도 짧은 2 + 물고기(60)가 6 + 물고기(8)보다 훨씬 많다.
03 1994년의 판독과 타밀어 검증
Parpola의 1994년 책은 판독 24개의 표와, 그가 참고한 mīn ‘물고기, 별’로 된 타밀어 복합어 99개의 목록으로 끝난다. 두 코퍼스 모두에서 다음 기호 쌍은 실재하며 되풀이되는 단위다. 3 + 물고기, 6 + 물고기, 눈 + 눈, 화덕 + 고리, 고리 + ‘공간’, ‘공간’ + 물고기. 물고기 + 물고기, 7 + 물고기, 무화과 + 물고기, 무화과 + ‘공간’, 게 + 단순한 물고기는 우연 수준이거나 그 아래다. 책은 물고기 앞의 숫자가 “3, 4, 6, 7로 제한된다”고 말한다. 코퍼스에는 1, 2, 3, 4, 6, 7, 12가 있으며, 타밀어에는 5에 해당하는 별 이름이 있는데도 5는 결코 없다.
모든 판독 뒤에 있는 검증은, 그것이 내놓는 복합어가 실제 타밀어 단어라는 것이다. 우연 기준선을 보면 이것이 얼마나 약한지 드러난다. 미리 정해 둔 그림 개념 98개를 잡자. 그 그림을 뜻하는 어떤 타밀어 단어가 Parpola의 타밀어 별 이름 하나의 첫머리가 되는 경우가 15%이며, 판독들이 쓰는 음성적 허용 범위를 주면 30%다.
04 동판: 기호 = 그림 등식 일곱 개
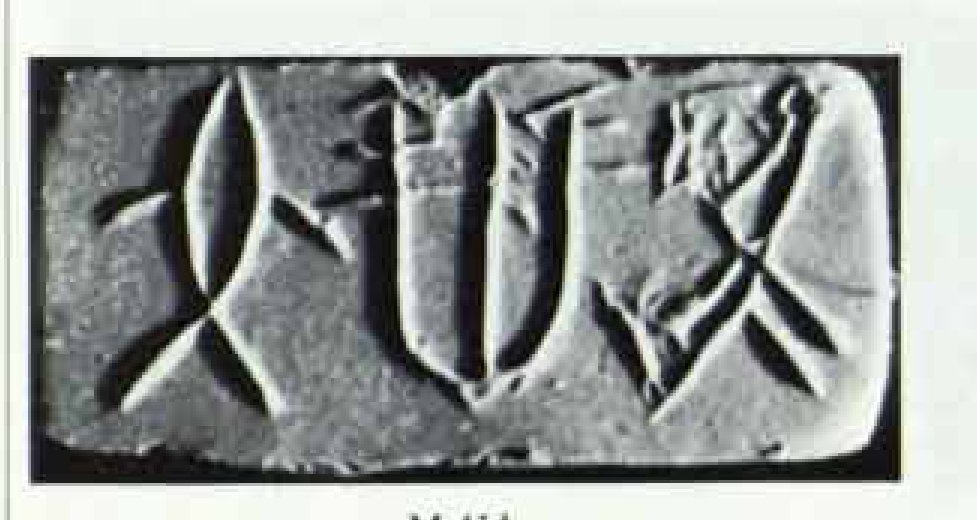
모헨조다로의 동판은 똑같은 사본들의 세트로 나온다. 각 동판은 한 면에 명문, 다른 면에 동물이나 인물이 있으며, 어떤 세트에서는 같은 명문을 지닌 채 기호 하나가 그림의 자리를 대신한다. Parpola의 46개 세트 유형 분류를 전사들과 맞춰 보면 등식 일곱 개가 나온다:
- 무화과 + 게 합자 777 = 마코르 염소 그리고 뿔 달린 궁수;
- 기호 749 = 마코르 염소;
- 341 = 코뿔소;
- 753 = 산토끼;
- 렌즈 모양 기호 = 긴 뿔 황소;
- “3 700 900 165” = 얼룩 황소.
이것들이 이 문자가 제공하는 가장 확실한 의미다. 그림 기호 749, 341, 753은 동판에만 나오고, 777은 그 밖에 인장 하나에 나온다. 어떤 인장 이름도 이들을 쓰지 않는다. 많은 인장 텍스트를 여는 머리 기호는 동판 텍스트를 여는 일이 결코 없다(198개 중 0). 동판은 인장과 다르게 행동한다. 9절의 포획–재포획 검정에서 동판 텍스트는 작고 닫힌 표지 집합을 이루어 칭호처럼 도시 곳곳에서 되풀이되는 반면, 인장 텍스트는 개별적이다. 동판의 그림은 모헨조다로의 구역별로도 몰려 있다. 텍스트만 있는 동판은 DK-G 남쪽에, 동물 계열은 VS-A에, 인물과 복합 형상은 성채 언덕에 있다.
05 어떤 언어인가? 대조군으로서의 산스크리트어와 수메르어
같은 검증을 산스크리트어(Monier-Williams)와 수메르어(ePSD2 용어집)에도 돌렸다. 그림 하나가 별 이름을 내는 경우는 산스크리트어에서 19%, 수메르어에서 10%로, 타밀어의 15%와 비교된다. 물고기 = 별이라는 말장난도 드라비다어만의 것이 아니다. 수메르어 mul은 ‘별’이면서 물고기이기도 하고, 산스크리트어에는 ṛṣi(물고기의 일종; 큰곰자리의 일곱 현인)가 있다. 그러나 2,895개 언어(CLICS4)에 걸쳐 ‘물고기’와 ‘별’을 뜻하는 일상 단어가 일치하는 것은 세 언어뿐이며, 남아시아에는 없고, 고대 타밀어 mīn이 그중 하나다. 따라서 모든 물고기 판독의 첫 단계는 진정으로 드라비다어에 특징적이다. 그 위에 세운 타밀어 복합어 검증은 그렇지 않지만 말이다. 물고기 앞의 숫자는 타밀어 별 이름을 따르지 않는다. 6 + 물고기, 곧 플레이아데스만 과다하게 나타나며, 5 + 물고기는 결코 나오지 않는다.
06 나머지를 수행한 방법: 검정 전에 등록한 가설
위의 검증 이후의 모든 것은 등록된 예측으로 돌렸다. 각 세트마다 가설과 그 문턱값을 targets/indus/PREDICTIONS.md 에 적어, 어떤 스크립트도 데이터를 보기 전에 저장소에 커밋했다. 그런 다음 검정을 돌리고, 문턱값을 바꾸지 않은 채 결과를 유지 또는 실패로 기록했다. 이렇게 247세트, 가설 2,727건을 돌렸다. 1,425건이 유지되고 1,302건이 실패했다. 세트 176부터는 고정된 진척 지표(targets/indus/PROGRESS.md)에 대해 점수를 매기는 루프로 돌렸다. 검정이 잘못 설정된 것으로 드러났거나 스크립트에 버그가 있었던 곳에서는 기록에 그 사실을 적고 원래 결과 옆에 정정된 결과를 둔다.
수치는 서로 다른 텍스트를 단위로 센다. 같은 인장이 여러 봉인에 찍힌 경우나 똑같은 동판 한 묶음은 한 번으로 센다. 반복된 사본은 어떤 패턴이든 부풀리기 때문이다. 주요 결과는 그것을 찾는 데 쓰지 않은 표본으로 다시 돌렸다. Mahadevan의 M77 추가분, 작은 유적들, 동판을 뺀 더 완전한 코퍼스, Parpola의 CISI 전사다. 읽을 수 있는 두 문자가 대조군으로 쓰였다. 선문자 B(미케네 그리스어, DAMOS 데이터베이스)와 우르 3왕조 시대의 인장 명문(수메르어, ORACC의 날인 22,402개)이다.
07 판독이 들어맞아야 할 문법
- 하나의 어휘 위의 네 가지 텍스트. 거의 모든 행은 어미가 붙은 이름, ‘종결자’로 끝나는 행, 수량(숫자와 세는 대상), 또는 어미 없는 맨 연쇄 중 하나다. 서로 다른 2,722행 가운데 넷 중 어디에도 맞지 않는 것은 3행뿐이다. 각 기호는 네 틀 모두에서 그 위치와 짝을 유지한다.
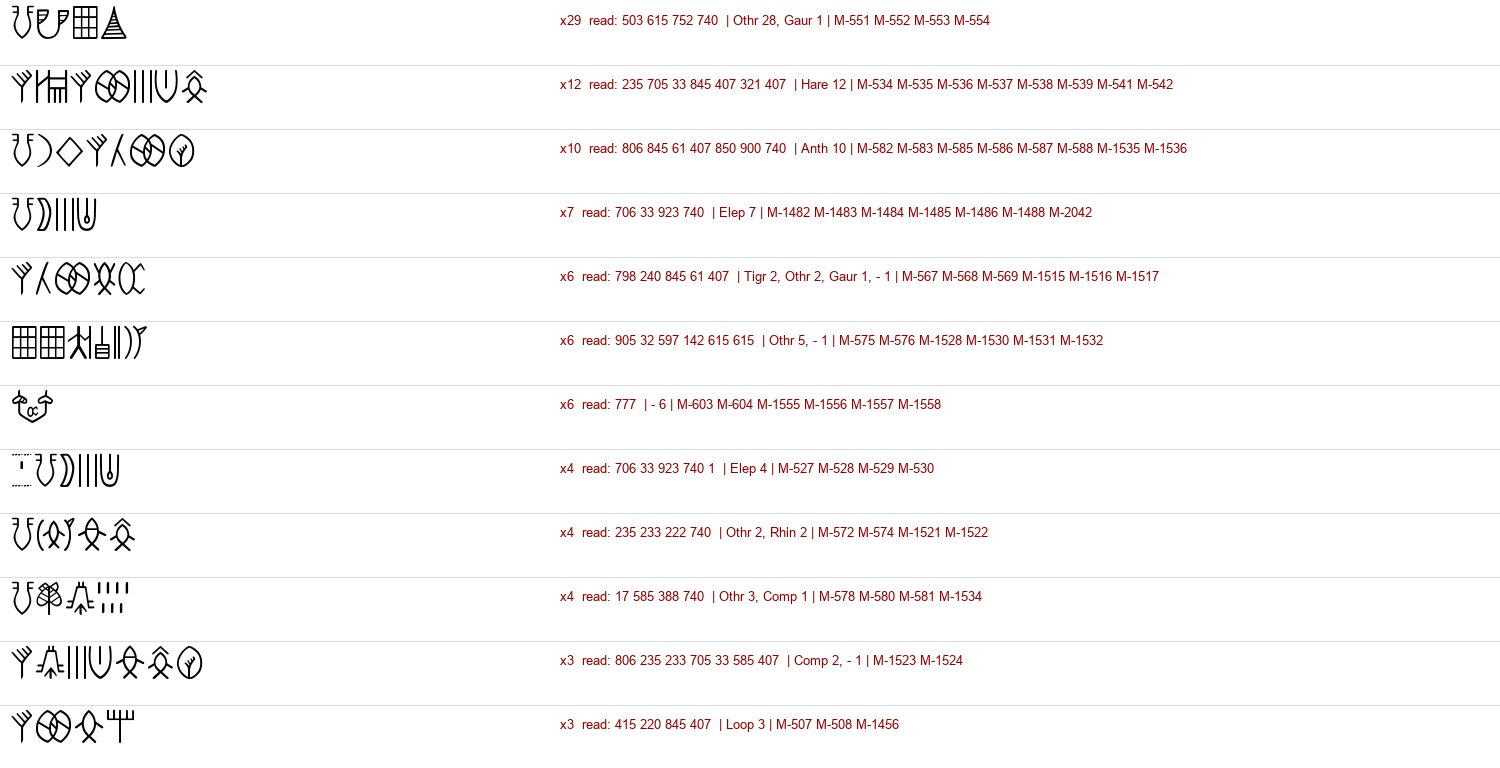
- 어미 자리는 이름의 마지막 기호가 선택하는 패러다임이다. 이름은 항아리 740, ‘화살’ 520, 십여 개의 종결자 중 하나, 또는 740 뒤에 쌓이는 종결자로 끝난다. 그 뒤에 선택적으로 400이나 90(740 뒤에서만)이 온다. 이름의 마지막 기호가 그것이 어떤 어미를 취할지를 예측한다(이를 모형화하면 Mahadevan의 별도 전사에서 어미의 95%를 예측한다). 이름 881개 가운데 740과 520 양쪽과 함께 나타나는 것은 5개뿐이다. 740과 520은 결코 맞닿지 않는다.
- 두 어미는 같지 않다. 740은 열린 어미다. 후기 층위에서 처음 보이는 주요 단어로 만든 이름은 모두 이것을 취한다(34개 중 34개). 520 이름들은 163개 이름에 서로 다른 주요 단어 26개만 쓰며, 대부분 물고기 기호이고, 인장 종결 공식 ‘705(또는 706) + 긴 3 + 520’ 같은 고정 표현을 포함한다.
- 이름은 핵 후행이다. 어미는 이름의 첫 기호가 아니라 마지막 기호 뒤에 온다. 이름은 기존 이름으로부터 앞쪽으로 자라며, 숫자는 그것이 세는 대상 앞에 선다(472건 대 106건). 이는 드라비다어와 인도아리아어의 어순이며, 수메르어와 엘람어와는 반대다. 수 일치는 없고, 접미사의 긴 연쇄도 없다. 어미 자리는 짧고 닫혀 있다.
- 줄바꿈은 단위를 존중한다. 여러 행으로 된 인장과 동판에서, 행 순서를 어느 쪽으로 잡든, 서기들은 가장 긴밀하게 결합된 기호 쌍 30개 중 어느 것도 줄을 넘겨 가르지 않는다(우연이라면 약 5에 대해 0). 되풀이되는 이름 단위나, 이름과 그 어미를 가르는 일도 거의 없다. 각 행은 네 종류 중 하나의 완결된 텍스트이며, 한 행이 이름이면 다른 행은 별개의 항목이다. Fuls(2024)가 Wells(2011)에 반대해 주장하듯, 기호 1과 2는 단어 구분자로 작용하지 않는다.
- 숫자는 그것이 세는 기호와 고정되어 있다. 하나의 숫자 체계가 모든 종류의 텍스트에 쓰이며, 짧은 획, 긴 획, 층을 이룬 획으로 쓰인다. 이름 안에서 특정 기호 앞의 숫자는 마치 숫자 + 기호가 한 단어인 것처럼 고정되어 있다. 같은 기호 앞에서 가장 흔한 값이 모헨조다로와 하라파 사이에 일치하는 것은 기호의 39%뿐이며, ‘2 + 물고기’가 공통된 예외다. 그러나 실제 수량도 이 정도로 지역적이다. 선문자 B에서 한 물품의 가장 흔한 수량은 17개 물품 중 8개에서 크노소스와 필로스가 다르다. 따라서 이것은 명명 관습이 아니라 세기처럼 보인다.
- 예측 가능성. 기호의 위치와 이웃을 다루는 모형은 따로 떼어 둔 텍스트를 기호당 4.66비트로 예측한다. 기호의 절반은 두 이웃으로부터 추측할 수 있다. 그리고 이 문자에는 금지된 쌍이 있다. 우연이라면 다섯 번 이상 함께 놓일 흔한 기호 쌍 20개가 결코 나오지 않는데, 이런 쌍은 뒤섞은 행보다 17배 많다. 예를 들어 물고기 220과 240은 결코 390 바로 앞에 서지 않는다.
08 두 번째 전사, 그리고 다른 이들의 주장
- Parpola 자신의 전사도 일치한다. Corpus of Indus Seals and Inscriptions의 공개 디지털화본은 모헨조다로 인장 M-1부터 M-184까지를 다룬다. 이 인장들에서 그것은 ICIT 전사와 대상물의 96%에서 길이가, 기호 위치의 92%에서, 마지막 기호의 98%에서 일치한다. 불일치는 드문 기호에서 생기며, 어미 규칙은 Parpola의 번호 체계에서도 유지된다.
- Mahadevan의 ‘도시의 상인’(2014), 곧 255 435 690 740이라는 구절은 실재하는 단위다. 세 유적의 서로 다른 텍스트 22개에서 아홉 가지 서로 다른 기호 뒤에 나타난다. 그러나 그 앞쪽 절반은 다른 명사를 수식하기보다는 뒤에 ‘690 740’이나 보유자 종결자를 취한다. 그리고 그가 이름으로 읽는 ‘보유자’ 기호들은 종결자처럼 행동한다. 그것들이 이름의 주요 단어인 경우는 196번 중 1번이다.
- Parpola가 보고하는 대로의 소련 팀의 굴절 주장은 진술된 그대로는 성립하지 않는다. 740은 판에서보다 인장에서 끝에 오는 일이 더 잦지 않으며, 그 뒤의 획이 텍스트를 끝내는 일은 드물다.
- 어떤 종류의 문자인가. 같은 표본 크기(토큰 5,000개)에서 비교하면 인더스 기호는 선문자 B의 기호와 단어 사이에 놓이되 기호 쪽에 더 가깝다. 유형 수가 495개로, 198개와 2,128개 사이이며, 드문 유형의 비율과 예측 가능성도 그 사이에 있다. 이는 기호 수백 개로 된 표어음절 문자에 들어맞으며, Fuls(2023)가 엔트로피로부터 도달한 범주다. 반복성 척도에서는 인더스 기호가 오히려 우르 3왕조 인장 명문을 닮는데, 이는 짧고 정형화된 장르의 표지다.
- ‘문자라고 하기에는 반복이 너무 적다’(Farmer, Sproat, Witzel 2004)는 같은 장르의 대조군 앞에서 성립하지 않는다. 기호 5–7개짜리 인더스 인장 행은 9.5%의 경우에 기호를 반복한다. 단어 5–7개짜리 우르 3왕조 인장 명문은 13.4%의 경우에 단어를 반복한다. 둘 다 뒤섞은 텍스트(28%와 34%)보다 훨씬 낮은데, 이는 실제 텍스트에서는 평범한 일이다.
- 공개된 키. Yajnadevam의 산스크리트어 키, Fairservis의 드라비다어 값, Parpola의 값 30개를, 각 키가 코퍼스의 얼마만큼을 사전 단어로 바꾸는지로 점수 매겨, 값을 뒤섞은 같은 키의 사본들과 비교했다. 어느 키도 자기 언어를 그 뒤섞은 사본보다 더 잘 읽지 못한다. 코퍼스에 맹목적으로 맞춘 키는 산스크리트어든 드라비다어든 수메르어든 똑같이 코퍼스의 약 93%를 읽어 내므로, 판독률 그 자체는 증거가 아니다. 그런데 그 사전 점수는 선문자 B에서도 실패한다. Ventris의 올바른 값은 그 뒤섞은 사본의 59–89%만 이긴다. 그래서 통과하는 두 번째 점수기를 만들었다. 복호화된 각 행을 그 언어의 문자 모형으로 평가하는 것이다. 따로 떼어 둔 선문자 B 행에서 이것은 그리스어 모형으로는 Ventris의 키를 뒤섞은 사본 100개 모두보다 위에 두고, 산스크리트어 모형으로는 그러지 않는다. 이를 통해 보면 실질적인 공개 키 가운데 자신이 주장하는 언어를 읽어 내는 것은 하나도 없다. Fairservis의 키는 뒤섞은 사본 100개 중 12개에, Yajnadevam의 키는 7개에 지며, Parpola와 Mahadevan의 키는 대부분의 뒤섞은 사본보다 못하다. Kak의 기호 일곱 개짜리 키가 통과하는 것은 행 끝의 항아리 740에 sa를 두기 때문일 뿐인데, 흔한 -sa를 가진 접미 언어라면 어느 것이든 이를 보상할 것이다.
- 값을 자유롭게 맞추면 알려진 문자에서 엉뚱한 언어가 골라진다. 선문자 B 텍스트의 절반에 대해 기호 값을 그리스어, 산스크리트어, 드라비다어, 수메르어에 각각 같은 자유도로 컴퓨터로 맞춘 다음, 나머지 절반에서 점수를 매겼다. 산스크리트어가 가장 잘 맞았고, 그리스어는 꼴찌이거나 3위였으며, Ventris의 값은 하나도 복원되지 않았다. 따라서 값을 자유롭게 고른 뒤 인더스 문자가 어떤 언어에 ‘들어맞는다’는 주장은 그 언어에 대한 증거가 아니다.
09 어떤 종류의 이름인가?
인장 텍스트는 짧고, 동물 아래에 있으며, 문법적 자리로 끝난다. 그것은 개인 이름인가, 칭호나 직책인가, 신인가? 생태학자들이 겹치는 두 표본으로부터 개체군 크기를 추정할 때 쓰는 포획–재포획 방법은 음가 없이 이 질문을 던질 길을 준다. 모헨조다로 인장의 이름들과 하라파 인장의 이름들을 한 개체군에서 잡은 두 번의 포획으로 보자. 둘 다에 나타나는 이름이 몇 개인지가 전체 개체군이 얼마나 컸는지를 알려 준다.
- 이름은 크고 열린 개체군이고, 주요 단어는 닫힌 개체군이다. 인장 1,279개에 서로 다른 이름 585개가 있으며, 두 도시 모두에 나타나는 것은 20개뿐이다. 이로써 개체군은 대략 3,000–5,500개 이름으로 추정되며(Lincoln–Petersen 추정과 Chao1 추정), 이름의 92%는 인장 하나에만 있다. 주요 단어(이름의 마지막 기호)는 거의 모두 이미 관찰되었다. 약 130개가 알려져 있고, 추정치는 약 150–220개다. 한 도시 안에서 모헨조다로의 두 구역을 비교하든(관찰된 수의 7.4배) 그 초기와 후기 층위를 비교하든, 그리고 Mahadevan의 별도 전사에서도 마찬가지다.
- 선문자 B에 대한 대조. 크노소스와 필로스를 두 번의 포획으로 삼아 미케네 그리스어에 같은 검정을 하면, 알려진 단어 부류들이 구별된다. 개인 이름은 큰 개체군을 준다(관찰된 수의 3.6배, 18% 공유, 71%가 판 하나에만). 칭호와 직업은 작고 공유되는 개체군을 준다(1.6배, 50% 공유). 길이를 맞추어 비교를 다시 했는데, 더 긴 단위는 무엇을 뜻하든 더 다양하기 때문이다. 기호 세 개에서 인더스 이름은 3.0, 세 음절 선문자 B 이름은 3.7이고, 네 개에서는 3.0 대 3.4다. 그리고 실제 이름은 선문자 B 이름이 그렇듯, 같은 길이의 무작위 기호 조합보다 25배 자주 유적 사이에서 되풀이된다.
- 우르 3왕조 인장에 대한 대조는 이 검정이 말할 수 있는 것을 더 날카롭게 한다. 수메르어 개인 이름은 많은 사람이 쓰는 제한된 이름 집합에서 나오므로, 그 자체로는 칭호처럼 보인다(관찰된 수의 2.0배, 31% 공유). 인장 명문 전체, 곧 이름 + 칭호 + 아버지 이름만이 인더스 이름만큼 개별적이다(17.5배, 3% 공유). 따라서 이 검정은 텍스트 전체가 얼마나 개별적인지를 재는 것이지, 그것이 사람의 이름인지를 재는 것이 아니다. 인더스 인장 텍스트는 선문자 B의 개인 이름이나 메소포타미아 인장 명문 전체처럼 개별적인 구성물이다. 메소포타미아 명문과 달리 두 번째 이름(인장의 1.6% 대 65%)이나 별도의 칭호 행(13% 대 71%)은 거의 없다.
- 이름은 인장의 동물에 묶여 있지 않다. 같은 이름을 가진 인장들이 같은 동물을 지니는 경우는 임의의 두 인장보다 많지 않으며(12% 대 11%), 코끼리, 혹소, 제의용 표지와 우연 이상으로 짝을 이루는 기호는 없다. 이름 열다섯 개가 세 곳 이상의 유적에 나온다. ‘590 390 740’은 다섯 곳에 있다. Allahdino, Chanhu-daro, Dholavira, 하라파, 모헨조다로.
10 장소와 시기
- 텍스트는 발견 지점을 따르지 않는다. 더 완전한 코퍼스에는 각 대상물이 모헨조다로의 어디에서(구역, 블록, 가옥) 발견되었는지가 기록되어 있다. 인장이 말하는 내용은 그것이 발견된 곳에 좌우되지 않는다. 같은 텍스트를 가진 인장들은 유의하게 몰려 있지 않으며, 한 가옥에서 나온 인장들이 특별한 어휘를 공유하지도 않는다. 텍스트의 종류, 어미, 동물, 텍스트 길이는 구역에 따라 달라지지 않으며, 거리에서 발견된 인장도 가옥에서 발견된 것만큼 자주 이름이다.
- 문법은 그대로다. 두 도시의 초기와 후기 층위 사이에서 어미 자리(520의 비율, 종결자, 400과 90, 쌓이는 종결자)와 수량 텍스트는 변하지 않는다. 숫자는 변하며, 모헨조다로에서는 이름이 시작하는 방식이 바뀐다. 자주 쓰이는 첫 기호 33개 중 하나로 시작하는 긴 이름이 39%에서 66%로 늘며, 사각 인장에서도 직사각 인장에서도 그렇다. 그러나 모헨조다로의 주요 단어와 전체 기호 구성은 하라파 쪽으로 움직이지 않으므로, 이는 이름이 시작하는 방식의 지역적 변화이지 두 도시 용법의 융합이 아니다.
- 자형 변이는 대상물과 제작자를 따른다. 같은 기호의 두 형태는 한 대상물 위에서, 그리고 한 텍스트의 사본들 사이에서 우연보다 더 일치하며, 매체에 따라 달라진다. 가정 단위의 습관의 흔적도, 시간에 따른 변화도 없다.
- 외국 이름은 문법을 깨뜨린다. 걸프와 메소포타미아에서 나온 인장은 평범한 인더스 기호를 쓰지만 어미 자리, 이름 단위, 통상적인 첫머리가 없다. 인더스 모형 아래에서 기호당 6.5비트를 기록하며, 행 안에서 획 기호를 많이 쓴다. 이는 외국 이름을 적을 때 획을 그 소리로 썼다는 암시일 수 있다.
11 어순이 보여 주는 한에서의 언어
음가가 없으면 언어에 대해 말해 주는 것은 어순과 문법의 모양뿐이다. 네 가지 특징이 한 방향을 가리킨다:
- 숫자가 세는 대상 앞에 온다;
- 이름은 핵 후행이다;
- 어미는 명사가 정하는 짧은 부류 접미사이며, 다른 곳에 수나 부류의 일치는 없다;
- 이름의 첫 요소는 열린 집합에서 오며, 접두사 집합은 없다.
이는 드라비다어와 인도아리아어에 들어맞으며, 핵을 앞에 두는 수메르어와 엘람어에는 불리하다. 두 가지 점이 범위를 더 좁힌다. 어미는 사람을 물고기 이름(Parpola의 별)과 구별하는데, 문다어 문법이라면 그러지 않을 것이다. 그리고 물고기 = 별 단어는 남아시아에서 드라비다어에만 있다. 둘을 합치면 드라비다어 쪽으로 기울지만, 물고기 이름이 별일 때만 그렇다. 그리고 여기서는 어순만으로 드라비다어와 인도아리아어를 가르는 것이 아무것도 없다. 어족별 기대치는 표준적인 유형론이지, 언어마다 확인한 출처가 아니다.
후보 언어들의 이름 목록은 결과 두 가지를 더한다. 우르 3왕조 인장의 수메르어 개인 이름은 첫 요소(Ur-, Lu-, Nin-, 신을 나타내는 기호)가 고정되어 있는 반면, 인더스 이름은 선문자 B와 산스크리트어 이름이 그렇듯 마지막 요소가 고정되어 있다. 이로써 수메르어형 이름 구조가 다시 한 번 배제된다. 드라비다어와 인도아리아어 사이에서는 목록이 결정을 내려 주지 않는다. 인더스 이름의 길이는 산스크리트어 이름에 더 가깝다. 어미 하나의 우세(740이 이름의 82%를 끝맺음)는 고대 타밀어 개인 이름에 더 가까운데, 그 67%가 남성형 -aṉ으로 끝나며, Mahadevan은 740을 이 접미사로 읽는다. 그런데 더 가까운 인도아리아어 비교 대상이 논증을 뒤집었다. Lüders의 초기 브라흐미 명문 목록(1912)은 산치와 바르후트에서 나온, 기원전 200년–기원후 400년경의 프라크리트어 기증자 이름 374개를 준다. 이는 기증된 물건 위의 개인 이름으로, 시기, 장소, 장르에서 인더스 인장에 가깝다. 인더스 이름은 이들과 같은 방식으로 만들어져 있다:
- 열린 정도가 비슷하다(관찰된 수의 5.1배 대 5.9배);
- 길이와 닫힘 정도에서 고대 타밀어 이름보다 더 가깝다;
- 복합어 핵의 집합으로 끝난다. 가장 흔한 프라크리트어 핵 열 개(-rakhita, -guta, -dina, -mita …)가 이름의 41%를 차지하고, 가장 흔한 인더스 핵 열 개가 43%를 차지한다.
프라크리트어 기증자 이름에도 거의 보편적인 어미가 하나 있는데, 기증 공식의 속격 -sa다. 따라서 740 같은 우세한 어미는 타밀어 -aṉ만큼이나 인도아리아어의 기증자식 공식에도 들어맞는다. 이에 대응하는 드라비다어 검정에는 기증 기록의 타밀어 이름을 썼다. 7세기 이후 DHARMA 타밀어 명문의 영어 번역에서 뽑은 이름 1,396개다. 결과는 증거를 둘로 가른다:
- 프라크리트어 기증자 이름에 더 가까운 것: 복합어 핵의 집합(인더스 43%, 프라크리트어 35%, 타밀어 16%)과 마지막 요소가 얼마나 강하게 고정되어 있는지.
- 타밀어 이름에 더 가까운 것: 이름 길이(거의 같음)와 단일 우세 접미사(740은 이름의 82%, 타밀어 -aṉ은 47%, 가장 흔한 프라크리트어 어간 어미는 23%).
따라서 이름 구조는 수메르어형을 배제하지만 인도아리아어와 드라비다어 사이에서 결정을 내리지는 못한다. 타밀어 기록은 프라크리트어 목록보다 훨씬 늦고, 그 이름의 상당수는 산스크리트어에서 파생된 것이기도 하다.
그래서 Mahadevan의 Early Tamil Epigraphy 쪽 스캔으로부터 같은 시기의 드라비다어 목록을 만들었다. 기원전 2세기경–기원후 4세기의 타밀-브라흐미 동굴 명문에서 나온 기증자 이름 104개다. 이는 시기와 장르에서 프라크리트어 목록과 맞는다.
- 프라크리트어 이름에 더 가까운 것: 세 가지 구조 척도 모두. 마지막 요소가 얼마나 고정되어 있는지: 인더스 0.83, 프라크리트어 0.90, 타밀-브라흐미 1.45. 길이. 그리고 핵의 집합: 43%, 35%, 30%.
- 타밀-브라흐미 이름에 더 가까운 것: 우세 접미사(82% 대 -aṉ의 73%). 그러나 이 대비는 부분적으로 출처가 만들어 낸 것이다. Lüders는 프라크리트어 이름을 격어미 없이 제시하기 때문이다.
이 척도들에서 인더스 이름은 같은 시기의 타밀어 이름보다 초기 인도아리아어 기증자 이름을 더 닮은 것으로 보였다. 나중의 대조 실험이 이를 철회시켰다. 유형론적으로 맞춘 미끼를 추가했다. 인더스의 어순 특징을 공유하는 언어인 일본어와 튀르키예어의 이름이다. 남아시아의 두 기증자 목록은 두 미끼를 모두 이겼지만, 그것들은 명문이었고 미끼는 이름 목록이었다. 양쪽의 장르를 맞추자(Monier-Williams의 산스크리트어 이름과 상감 시인들의 이름을 같은 일본어와 튀르키예어 목록과 비교), 데이터의 두 절반 모두에서 일본어가 인더스 이름에 가장 가깝게 나왔다. 앞서의 기울기는 언어가 아니라 장르였다. 이런 종류의 이름 구조 통계로는 언어를 고를 수 없다.
세계 유형론은 범위를 좁혀 주지만 거기까지다. WALS와 Grambank 데이터베이스와 대조해 보면 인더스의 어순 특징은 세계 어속의 81%(Grambank 어족의 68%)를 배제한다. 드라비다어, 인도아리아어, 문다어, 부루샤스키어, 튀르크어, 몽골어, 일본어, 한국어가 모두 남는다. 단 하나의 부류 신호(물고기를 핵으로 하는 이름은 520을 취하고, 사람, 도구, 식물을 핵으로 하는 이름은 740을 취함)는 모헨조다로, 하라파, 다른 유적들에서, 초기와 후기 모두 유지된다. 이는 드라비다어의 인간/비인간 구분에도 들어맞고, 별 이름이 대부분 여성형인 산스크리트어의 성(性) 해석에도 똑같이 들어맞는다.
12 상금에 견주어: 기준점
2025년 1월 타밀나두 주정부는 이 문자를 “고고학 전문가들이 만족할 만큼” 해독하는 사람에게 미화 100만 달러를 내걸었다. 더 이상의 규칙은 공개되지 않았다. 여기서의 작업은 그런 심사단이 그럴듯하게 요구할 기준에 대해, 비중순으로 점수가 매겨졌다(targets/indus/PROGRESS.md, prizebench.py):
- 검증된 의미: 뜻으로 읽히고 외부 증거(같은 대상물의 그림, 그 용도, 발견 장소)로 확인된 기호. 현재: 기호 토큰의 0.008%, 곧 동판의 그림 기호. 숫자(16.6%)는 따로 센다. 판독에 한 걸음 못 미치는 것으로, 텍스트 전체 열한 개는 그 지시 대상이 그림으로 고정되어 있다. 각각은 하나하나 만든, 같은 그림을 지닌 동판 또는 새김판 세 개 이상에 쓰여 있다. 산토끼, 궁수, 코끼리, 염소, 가비알, 물고기, 황소, ‘고리’다(뒤섞은 그림에 대해 p = 0.001). 두 기호짜리 구절 열다섯 개가 진정으로 서로 다른 텍스트들에 걸쳐, 개별 제작된 판과 서로 다른 틀 찍기 도안에 걸쳐 같은 검정을 통과하는데, 그 가운데 잎 기호가 든 나무 구절 806 158이 있다. 한 텍스트의 부분 전사들은 세기 전에 병합했다. 텍스트와 구절을 합치면 기호 토큰의 0.76%가 되며, 이들은 읽히지는 않은 채 장면에 표지를 붙인다. 그러나 이들은 지역적인 표지다. 새김판에서 한 그림과 짝을 이루는 구절은 틀 찍기 판의 그림을 예측하지 못하며, 그 반대도 마찬가지다(40개 중 1개). 이 방법은 먼저 선문자 B에서 검증했는데, 거기서는 표의 기호가 그림의 역할을 한다. 방법은 표의 기호 하나와 짝을 이루는 단어 143개를 골라내며(우연이라면 2개), a-mo-ta ‘바퀴’와 바퀴 표의 기호 같은 알려진 짝을 복원한다. 인장에서는 기본값인 외뿔 황소 외의 어떤 동물에 대해서도 이 방법이 아무것도 찾지 못하므로, 인장 텍스트는 그 동물의 이름을 대지 않는다. 그림은 반대쪽에서 문법을 검증하기도 한다. 앞선 어떤 검정에도 쓰이지 않은 틀 찍기 판에서, 어미, 표지, 숫자를 포함하는 기호 쌍은 내용 기호 두 개로 된 쌍보다 훨씬 더 다양한 그림과 짝을 이룬다(출현당 서로 다른 그림 0.45 대 0.28, p = 0.001). 문법이 문법적이라고 부르는 기호들은 그 자체의 지시 대상을 지니지 않는다.
- 양성 대조: 방법은 먼저 알려진 답, 곧 선문자 B에서 그리스어를 복원해야 한다. 여섯 가지 방법 가운데 셋이 통과한다. 음가의 치환 검정, 8절의 문자 모형 키 점수기, 그리고 그림-지시 대상 방법이다. 사전 점수와 자유로운 키 맞추기는 실패한다.
- 보지 않은 텍스트: 값을 정하는 데 쓰인 적 없는 텍스트에 시험하기 전에 값을 확정하는 것으로, Ventris의 값이 그의 해독 이후 발견된 필로스 판에서 그렇게 시험되었다. 현재: 없음. 통과한 음가가 없기 때문이다.
- 보조: 고고학적 일관성, 같은 장르의 미끼에 대한 언어, 그리고 예측 과제. 숨긴 기호를 첫 번째 추측으로 맞히는 경우가 40%, 상위 다섯 안에 드는 경우가 62%다(빈도만으로는 9.6%와 22%). 이 향상은 기호를 자형 계열별로 읽는 것과 할인 평활화에서 나왔다. (행의 첫 기호에 조건을 거는 데서 온 듯한 향상은 첫 기호가 자기 자신으로부터 예측되는 누수였으므로 철회했다.) 여기서 자형 계열이란 우리 모양, 항아리나 U 안의 획, 물고기에 붙은 표시를 뜻한다. 이 효과는 계열을 ICIT 번호 체계에서 가져오든 Parpola 자신의 기호 기술에서 가져오든 유지되며, 문맥으로부터 학습한 부류는 이 효과를 전혀 주지 않는다. 그 이상으로 더 잘 보정된 모형은 첫 추측을 개선하지 못한 채 기호당 비트 수만 낮춘다.
첫째와 셋째 단계를 끌어올리려는 시도에서 두 가지 발견이 나왔다. 판의 그림은 단일 기호가 아니라 틀로 되풀이 찍은 텍스트 전체와 짝을 이룬다. 판의 절반에서 확정한 그림 의미는 보지 않은 판 38개 중 1개를 예측한다. 공유되는 두 기호짜리 구절은 약한 경향을 지닌다(각 텍스트를 차례로 빼고 시험했을 때 17%가 맞음, p = 0.05). 대부분 코끼리 구절 706 33 923 740과 나무 구절 806 158이다. 타밀나두의 낙서 표시(Rajan과 Sivanantham 2026, vol. II)를 기호 등식이 필요 없는 검정으로 인더스 행과 비교했다. 두 낙서 요소가 함께 나오는 경우 같은 순서를 유지하는 것은 70.5%로, 인더스 기호의 88.0%와 대비되며, 이 수치는 Keeladi와 Thulukarpatti에서 같다. 기록된 대로라면 낙서 복합체는 인더스 문자보다 덜 질서 정연하다.
같은 루프에서 구조적 추가 사항 두 가지가 나왔다. 수량 바로 앞의 자리는 제한된 집합, 곧 수량에 붙는 표지로 채워지며, 두 코퍼스 모두 그렇다. 그 가장 흔한 기호 열 개가 자리의 52%와 58%를 차지하며, 뒤섞은 행에서는 훨씬 적다. 이는 부분적으로 머리 기호 때문이지만 그것만은 아니다. 그리고 이 규칙을 넣은 문법은 보지 않은 행을 뒤섞은 행보다 조금 더 큰 차이로 더 잘 구문 분석한다.
가장 강력한 보조 결과는 일관성이다. 학습된 부분을 포함한 문법을 한 장소의 행에 맞추고 다른 장소에서 점수를 매기되, 뒤섞은 행 대비 차이로 나타내면:
- 모헨조다로에서 학습하면 하라파의 행을 자기 행과 거의 같은 수준으로 구문 분석하며(43.8 대 44.8점), 그 반대도 성립한다.
- 두 도시에서 학습하면 작은 유적들을 구문 분석한다(36.1).
- 인장에서 학습하면 판을 구문 분석한다(43.6).
- 후기 하라파에서 학습하면 초기 층위를 구문 분석한다(27.0).
자형 장치, 수량 표지 자리, 물고기/520 부류 신호는 모두 각 도시에서, 그리고 인장과 판에서 똑같이 행동한다. 우리에 든 기호는 결코 740이나 520을 취하지 않으며, 획이 든 항아리는 행을 끝내는 일이 거의 없다. 하나의 문법 체계가 인더스 세계 전체에 쓰였으므로, 어떤 판독이든 어디서나 이에 들어맞아야 한다. 이름에 접두사가 보이지 않으므로 언어에 접두사가 없어야 한다는 조건을 더하면 유형론의 범위가 더 좁아진다. WALS 어속의 85%와 Grambank 어족의 77%가 배제된다.
이 기준점에 따르면 이기는 것은 이런 것이다. 흔한 기호 70개가량에 값을 주어 대부분의 토큰을 한 언어의 문법적 구절로 읽어 내는 것. 그 뜻은 여러 종류의 외부 증거와 일치해야 한다. 방법은 선문자 B 대조를 통과하고, 값을 정하는 데 쓰인 적 없는 텍스트를 읽어 내야 하며, 그것을 만들지 않은 전문가들에 의해 재현되어야 한다. 현재의 작업은 그런 주장이 통과해야 할 문법과 검정을 제공한다. 판독은 하나도 제공하지 않았다.
13 남은 문제
- 증거가 강제하는 음가를 가진 기호는 하나도 없으며, 언어도 밝혀지지 않았다. 위의 구조를 넘어서는 내부 검정은 바닥났다. 마지막 몇 차례는 대부분 귀무 결과와 정정만을 내놓았다. 남은 것에는 새 자료가 필요하다. 이중 언어 명문, 새로 발굴된 명문 대상물, 또는 디지털화된 CISI 2권과 3권. (전체 ICIT 데이터베이스는 이미 여기서 쓰이고 있다. 내보내기에는 기록 5,680건이 모두 들어 있으며, 분석에는 손상된 텍스트를 제외한 깨끗한 텍스트 3,681개를 쓴다.)
- 동판의 기호 = 그림 등식 일곱 개(749, 341, 753, 777, 렌즈 기호)가 가장 확실한 의미다. 어떤 언어로 된 판독이든 이에 들어맞아야 한다.
- 메소포타미아 명문이 개인 이름과 직책 또는 가계를 여러 행에 펼쳐 놓듯, 인더스 이름이 이를 한 단위에 담고 있는지는 미해결이다(14절 참조).
14 도중에 철회한 것들
예측을 먼저 등록한다는 것은 이 프로젝트 자체의 판독 일부가 나중의 검정으로 뒤집혔다는 뜻이다. 그것들은 기록에 남겨 두었으며, 여기 나열한다:
- 음성 기호 후보 목록(선문자 B의 음성 기호처럼 이웃과 자유롭게 결합하는 기호 46개)은 등록된 검정 세 개를 모두 통과하지 못했다. 드문 이름일수록 더 자유로운 기호를 쓴다는 관련 발견은 선문자 B에서도 나타났으므로, 드문 단어의 일반적 효과다.
- ‘두 가지 숫자 체계’(초기의 판독)는 여러 획 형태를 가진 하나의 숫자 체계가 되었다. 긴 획은 하라파 판에서 계량 기호 700과 짝을 이룬다.
- ‘직책 + 이름’. 칭호 같은 첫 기호와 사람 같은 이름 나머지 부분 사이의 대비는, 알고 보니 단일 기호와 여러 기호로 된 단위를 비교한 것이었다. 단일 기호는 거의 정의상 닫힌 집합이다. 길이를 통제하자 첫 기호와 인장 동물 사이의 약한 연관만 남았다.
- ‘숫자 복합어는 지역적 명명 관습이다’. 선문자 B의 수량도 그만큼 지역적인 것으로 드러났으므로, 이 주장은 ‘수량이 그렇듯 지역적이다’로 철회했다.
- ‘모헨조다로가 하라파로 수렴한다’. 이것은 이름이 시작하는 방식의 지역적 변화로 정정되었다(10절).
- ‘인더스 이름은 개인 이름이다’. 이것은 우르 3왕조 대조에 의해 ‘개별적 구성물’로 좁혀졌다(9절).
- ‘인더스 이름 구조는 인도아리아어에 더 가깝다’. 장르를 맞추면 일본어 미끼 목록이 그보다 더 가깝게 나온다. 그 기울기는 출처가 명문이라는 데서 왔다(11절).
- ‘공유 구절이 판의 그림을 예측한다’(한 분할에서 p = 0.001). 세 번째 분할은 실패했고, 각 텍스트를 차례로 빼면 p = 0.05에 그친다. 유리한 분할이었던 것이다(12절).
15 출처
- A. Parpola, “Study of the Indus Script”, Transactions of the International Conference of Eastern Studies 50 (2005), 28–66, harappa.com; Deciphering the Indus Script (Cambridge, 1994).
- J. P. Joshi and A. Parpola, Corpus of Indus Seals and Inscriptions 1 (Helsinki, 1987); 그 공개 디지털화본 mayig/indus-valley-script-corpus (MIT).
- indus-website 프로젝트의 ICIT 파생 코퍼스(github.com/yajnadevam/indus-website); A. Fuls, Corpus of Indus Inscriptions (Berlin, 2022), A Catalog of Indus Signs (Berlin, 2023); A. Fuls, “Comparison of Linear Elamite and Indus Writing Systems”, Iranian Journal of Archaeological Studies 14.1 (2024), 3–16.
- I. Mahadevan, The Indus Script: Texts, Concordance and Tables (1977), github.com/joyboseroy/indus_decipher를 통해 기계 판독 가능; I. Mahadevan, Dravidian Proof of the Indus Script via the Rig Veda: A Case Study (Bulletin of the Indus Research Centre 4, 2014).
- 언어 비교 자료: H. Lüders, A List of Brahmi Inscriptions (Epigraphia Indica X appendix, 1912; Internet Archive); DHARMA, Early Inscriptions of Āndhradeśa와 타밀어 코퍼스(erc-dharma tfa-*, CC BY 4.0); Wikipedia, List of Sangam poets; Monier-Williams; I. Mahadevan, Early Tamil Epigraphy (Harvard Oriental Series 62, 2003), Appendix II, Internet Archive 스캔에서.
- 대조 자료: DAMOS, Database of Mycenaean at Oslo(선문자 B), Tiripode 어휘집 포함; ORACC epsd2/admin/ur3(우르 3왕조 인장 명문, CC0); Monier-Williams (Cologne Digital Sanskrit Lexicon); ePSD2; CLICS4; L. L. Merriam and A. Fuls, The Dravidian Database (Zenodo, 2026).
- 유형론과 미끼: M. S. Dryer and M. Haspelmath (eds.), WALS Online (2013), H. Skirgård et al., Grambank (2023), 둘 다 CLDF 릴리스, CC BY 4.0; JMnedict (EDRDG, CC BY-SA 4.0); 튀르키예어 이름 빈도(github.com/eoner/turkce_isimler).
- 상금과 낙서: 2025년 1월 5일 발표(Archaeology Magazine 보도); K. Rajan and R. Sivanantham, Indus Signs and Graffiti Marks of Tamil Nadu: A Morphological Study (2025), Inscribed Potsherds of Tamil Nadu: Graffiti and Tamiḻi, vol. II (2026), Department of Archaeology, Government of Tamil Nadu, Tamil Digital Library에서.
스크립트, 등록된 가설(PREDICTIONS.md), 모든 세트의 결과(results/), 작업 메모(NOTES.md)는 저장소 폴더 targets/indus/에 있다.