要点未解読 · 登録した仮説2,727件中1,425件が成立
- テキスト
- 出発点は Asko Parpola の講演「Study of the Indus Script」(ICES 東京 2005年、harappa.com 掲載)である。その背後にある銘文は約4,500点の印章、タブレット、土器片で、大半は5文字に満たない。
- 所蔵
- 互いに独立して作られた機械可読の転写が2つある。Interactive Corpus of Indus Texts(ICIT。Wells と Fuls)から派生したデータベースと、Mahadevan の1977年のコンコーダンス(M77)である。ここでは両者を文字ごとに対応づけた。Parpola 自身の Corpus of Indus Seals and Inscriptions のデジタル化版を第三の検証に用いた。
- 文字体系
- 約400–600の文字で、大半は右から左へ書かれる。語の区切りも、二言語併記の資料もなく、言語もわかっていない。
- 試みた方法
- まず、Parpola の講演と彼の1994年の読みの表にあるすべての数を数え直し、彼のタミル語による検証に偶然の基準線を与えた。次に、データを見る前に247組、計2,727の仮説を書き出して確定させた。それぞれを検証し、成立したか失敗したかを記録した。主要な結果は、取り置いておいたサンプルと、読むことのできる2つの文字体系(線文字B、ウル第3王朝の楔形文字)に対して再度検証した。
- 得られたもの
- 音価のない詳細な文法。名前はある枠で終わり、その形(740、520、あるいは閉じ記号)は名前の最後の文字によって選ばれる。書記は結びついた対や、名前とその語尾を、決して行をまたいで分割しない。数字は、数える対象の文字と固定的に結びついている。印章の名前は個人名のようにふるまい、同じ長さの線文字Bの名前と同様である。Parpola の星の名前の読みは、それぞれ1つか2つの印章に依拠している。
- 未解決
- 音に関わることすべて、そして言語。タミル・ナードゥ州の賞金が求めるもの(12節)に照らすと、解読を決定づける段階はほぼゼロである。本プロジェクト自身の以前の結論のいくつかは、後の検証によって撤回された。それらは14節に挙げている。
01 コーパスと文字
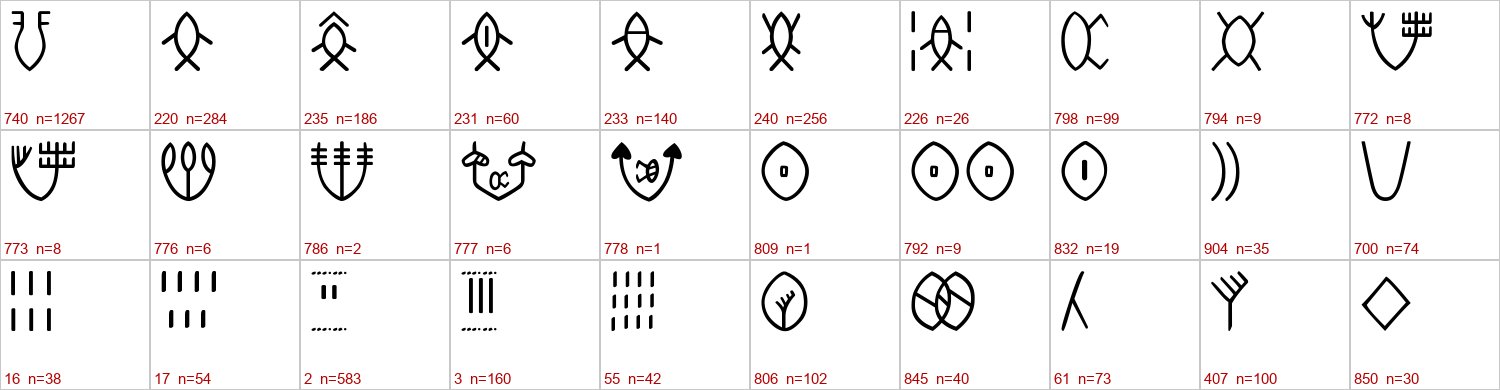
Parpola の論拠は数である。最も多い文字がどれほど頻繁に現れるか、どの文字が並び、どの文字が決して並ばないか。それを再検証するために、本プロジェクトは互いに独立して作られた2つの転写を使った。1つ目は Interactive Corpus of Indus Texts(Wells と Fuls)から派生したデータベースで、indus-website プロジェクトとともに公開されている。2,543点の対象、11,253文字で、CISI の対象番号、遺跡、図柄が付いている。同じデータベースのより完全な書き出し(5,680件の記録で、出土地点、層位、大きさ、材質を含む)を、後の検証の大半に用いた。その文字の総数は、確認した文字について、Fuls の Catalog of Indus Signs(2023年)に印刷された数とよく一致する。ICIT の文字は番号でしかないので、各文字をデータベース自身のフォントで描き、Parpola の記述と照合して同定した。2つ目の転写は Mahadevan の1977年のコンコーダンス(2,906テキスト)である。2つの文字リストは、両者に共通するテキストを揃えることで対応づけた。991行で、文字の96%がただ1つの対応物をもつ。1つ目のコーパスにない M77 の1,664テキストは、全体を通じて独立した再現用サンプルとした。
02 講演の主張を検証する
- 最も多い文字(「壺」、740)は全文字のほぼ10%を占める。M77 で9.9%、ICIT で11.3%である。南アジアでは自分自身と隣り合うことがない(0回。各行内の順序をシャッフルした場合の期待値は4.0、p は約0.007)。Parpola の言うとおり、各コーパスに1回ずつ、出所不明の同じ丸い印章の上でだけ隣り合う。
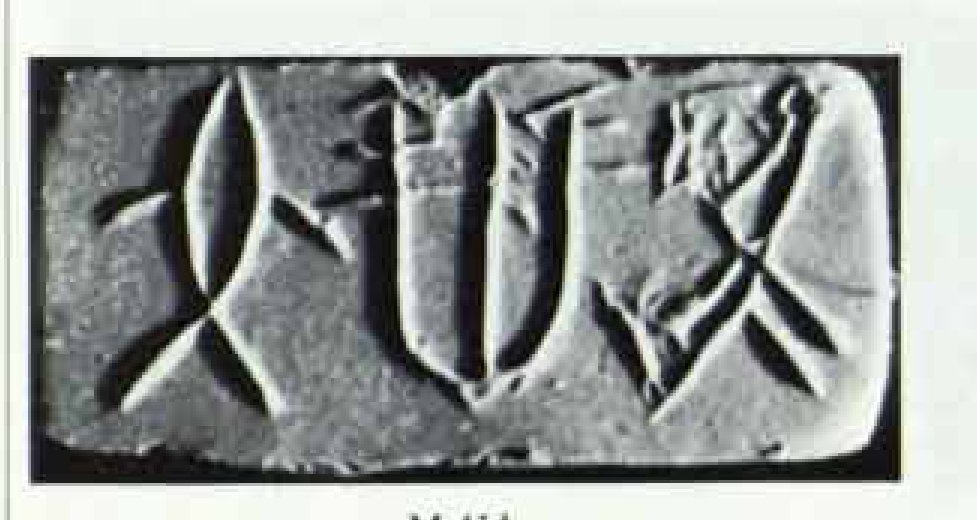
- ペルシア湾岸とメソポタミアで見つかった印章は、よくある文字を珍しい順序で使う。講演とは異なり、1つの四角い印章(オマーン、Salut)も珍しい。
- 魚の文字は印章の文字の9.7%である。蟹は偶然よりはるかに頻繁に魚の文字と隣り合うが、隣り合うのは印付きの魚であって、無印の魚ではない。
- 「7 + 魚」は大熊座と読まれるが、両コーパスでハラッパーの1つの印章に1回だけ現れる。「イチジク + 魚」、すなわち北極星は2回現れる(M-172 と、CISI 第1巻の写真で確認した M-414)。
- 魚の前の数。Parpola は「6 + 魚」(プレアデス)を最も多い数字 + 魚の並びとしている。異なるテキストを1回ずつ数えると、最も多いのは「2 + 魚」(113テキスト)で、次が「3 + 魚」(28)である。「6 + 魚」は8である。CISI のデジタル化版にある Parpola 自身の転写も、それがカバーする印章について同じ答えを出す。2 + 魚が13回、6 + 魚は0回である。すべての写しを数えても、Mahadevan の転写を使っても、2 + 魚がやはり最も多い(117例と123例、6 + 魚は9例と12例)。3つの転写と2つの数え方が一致するので、違いは ICIT の文字の同定の仕方によるものではない。「2」の一部は長い2本線(113行中51行)であり、Parpola はこれを数ではなく vēḷ と読み、長い2本線 + 魚を「金星」としている。それを除いても、短い2 + 魚(60)は6 + 魚(8)をはるかに上回る。
03 1994年の読みとタミル語による検証
Parpola の1994年の本は、24の読みの表と、彼が依拠した mīn「魚、星」を含む99のタミル語複合語のリストで締めくくられる。両コーパスで、次の文字の対は実在し、繰り返し現れる単位である。3 + 魚、6 + 魚、目 + 目、炉 + 輪、輪 + 「空間」、「空間」 + 魚。魚 + 魚、7 + 魚、イチジク + 魚、イチジク + 「空間」、蟹 + 無印の魚は、偶然と同程度かそれ以下である。本は、魚の前の数は「are restricted to 3, 4, 6 and 7」と述べる。コーパスには 1、2、3、4、6、7、12 があり、5 は一度もない。タミル語には5に対応する星の名前があるにもかかわらずである。
すべての読みの背後にある検証は、それが与える複合語が実在するタミル語の語であるかどうかである。偶然の基準線を置くと、それがどれほど弱いかがわかる。前もって固定した98の図像概念を取る。その図像を表す何らかのタミル語の語が Parpola のタミル語の星の名前のどれかの語頭になる確率は15%で、読みが用いている音の許容幅を認めると30%になる。
04 銅板:文字 = 図像の7つの等式
モヘンジョダロの銅板は、同一の写しの組になっている。それぞれ片面に銘文、もう片面に動物や人物があり、いくつかの組では図像のかわりに1つの文字が置かれ、銘文は同じである。Parpola による46組の類型を転写と照合すると、7つの等式が得られる。
- イチジク + 蟹の合字 777 = マーコール(ヤギ)および角のある射手
- 文字 749 = マーコール(ヤギ)
- 341 = サイ
- 753 = ウサギ
- レンズ形の文字 = 長い角の雄牛
- 「3 700 900 165」= 斑点のある雄牛
これらが、この文字体系が与える最も確かな意味である。図像文字 749、341、753 は銅板にしか現れず、777 はそれに加えて1つの印章に現れるだけである。どの印章の名前もこれらを使わない。多くの印章のテキストの冒頭に来る見出しは、銅板のテキストの冒頭には決して来ない(198中0)。銅板は印章とは異なるふるまいをする。9節の捕獲再捕獲テストでは、銅板のテキストはラベルの小さな閉じた集合をなし、称号のように都市中で繰り返されるが、印章のテキストは個別的である。銅板の図像はモヘンジョダロの地区ごとにもまとまっている。テキストだけの銅板は DK-G South に、動物の系列は VS-A に、人物と合成像は城塞の丘にある。
05 どの言語か? 対照としてのサンスクリットとシュメール語
同じ検証をサンスクリット(Monier-Williams)とシュメール語(ePSD2 の語彙集)でも行った。図像が星の名前を与えるのは、サンスクリットで19%、シュメール語で10%であり、タミル語は15%である。魚 = 星の語呂合わせもドラヴィダ語だけのものではない。シュメール語の mul は「星」であり、魚でもある。サンスクリットには ṛṣi(魚。大熊座の七賢者)がある。しかし2,895の言語(CLICS4)全体で、「魚」と「星」を表す普通の語が一致するのは3言語だけで、南アジアには一つもなく、古タミル語の mīn がそのうちの1つである。したがって、すべての魚の読みの第一歩は真にドラヴィダ語に特有であるが、その上に築かれたタミル語の複合語による検証はそうではない。魚の前の数はタミル語の星の名前に従わない。有意に多いのは6 + 魚、すなわちプレアデスだけで、5 + 魚は一度も現れない。
06 残りの進め方:検証前に登録した仮説
上の検証以降のすべては、登録された予測として実行した。各組について、仮説とその閾値を targets/indus/PREDICTIONS.md に書き込み、どのスクリプトもデータを見る前にリポジトリにコミットした。その後で検証を実行し、閾値を変えずに結果を成立または失敗として記録した。この方法で247組、2,727の仮説を実行した。1,425が成立し、1,302が失敗した。176組目以降は、固定した進捗指標に対して採点するループとして実行した(targets/indus/PROGRESS.md)。検証の設定が不適切だとわかった場合や、スクリプトにバグがあった場合は、記録にそう書き、元の結果の横に訂正した結果を示している。
数は異なるテキストについて数えている。多くの封泥に押された同じ印章や、同一のタブレットの一群は1回と数える。繰り返された写しはどんなパターンも水増しするからである。主要な結果は、それを見つけるのに使わなかったサンプルで再度検証した。Mahadevan の M77 で追加されたもの、小さな遺跡、銅板を除いたより完全なコーパス、そして Parpola の CISI の転写である。読むことのできる2つの文字体系を対照実験とした。線文字B(ミケーネ・ギリシア語、DAMOS データベースから)と、ウル第3王朝期の印章銘(シュメール語、ORACC からの22,402の押印)である。
07 読みが従うべき文法
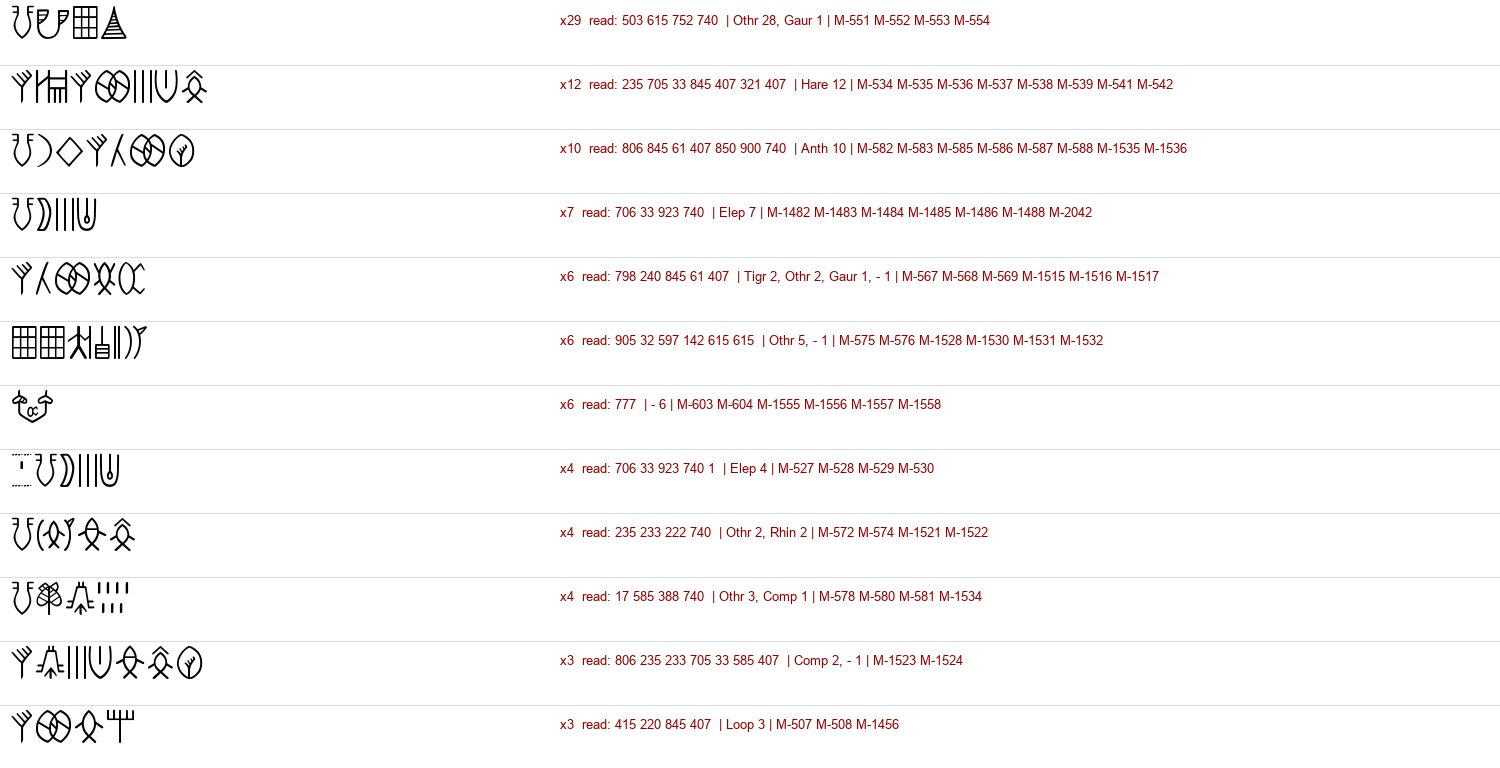
- 1つの語彙による4種類のテキスト。ほぼすべての行は、語尾付きの名前、「閉じ記号」で終わる行、計数(数字と数えられるもの)、語尾のない裸の並びのいずれかである。異なる2,722行のうち、4つのどれにも当てはまらないのは3行だけである。各文字は4つの枠すべてにわたって、その位置と共起する相手を保つ。
- 語尾の枠は、名前の最後の文字によって選ばれる語形変化表である。名前は、壺 740、「矢」520、十数個ある閉じ記号のどれか、あるいは 740 に積み重ね型の閉じ記号が続いたもので終わる。その後に任意で 400、または(740 の後に限り)90 が来る。名前の最後の文字は、それがどの語尾を取るかを予測する(これをモデル化すると、Mahadevan の別個の転写における語尾の95%を予測する)。881の名前のうち、740 と 520 の両方と現れるものは5つしかない。740 と 520 が接することはない。
- 2つの語尾は同じではない。740 は開かれた語尾である。後期の層で初めて現れる主要語を基にしたすべての名前がこれを取る(34中34)。520 の名前は163の名前で26種の主要語しか使わず、その大半は魚の文字であり、印章の締めくくりの定型句「705(または 706)+ 長い3 + 520」のような固定表現を含む。
- 名前は主要部後置である。語尾は名前の最初の文字ではなく、最後の文字の後に続く。名前は既存の名前から前方に向かって伸び、数字は数える対象の前に置かれる(472例対106例)。これはドラヴィダ語とインド・アーリア語の語順であり、シュメール語とエラム語の逆である。数の一致はなく、長い接尾辞の連鎖もない。語尾の枠は短く、閉じている。
- 改行は単位を尊重する。複数行の印章とタブレットでは、どちらの行順でも、書記は最も強く結びついた30の文字の対のどれも、決して行をまたいで分割しない(偶然なら約5回のところ0回)。繰り返し現れる名前の単位や、名前とその語尾を分割することもほとんどない。各行は4種類のいずれかの完結したテキストであり、ある行が名前である場合、もう一方の行は別の欄である。Fuls(2024年)が Wells(2011年)に反論して論じるとおり、文字 1 と 2 は語の区切りとしては働かない。
- 数字は、数える対象の文字と固定的に結びついている。1つの数体系が、短い線、長い線、段になった線で書かれ、あらゆる種類のテキストに用いられる。名前の中では、ある文字の前の数は固定されており、数字 + 文字が1つの語であるかのようである。同じ文字の前で最も多い値がモヘンジョダロとハラッパーで一致するのは文字の39%だけで、「2 + 魚」は共通する例外である。しかし本物の計数も同じくらい地域的である。線文字Bでは、ある品目の最も多い数量は、17品目中8品目でクノッソスとピュロスの間で異なる。したがって、これは命名の慣習ではなく計数のように見える。
- 予測可能性。文字の位置と隣接文字のモデルは、取り置いたテキストを1文字あたり4.66ビットで予測する。文字の半分は両隣の2文字から推測できる。そしてこの文字体系には禁じられた対がある。偶然なら5回以上並ぶはずのよく使われる文字の対のうち20組は一度も現れず、そのような対はシャッフルした行の17倍ある。たとえば、魚 220 と 240 は 390 の直前に来ることがない。
08 第二の転写と他者の主張
- Parpola 自身の転写も一致する。Corpus of Indus Seals and Inscriptions の公開デジタル化版は、モヘンジョダロの印章 M-1 から M-184 をカバーする。それらの印章で、ICIT の転写と、対象の96%で長さが、文字位置の92%で、最後の文字の98%で一致する。食い違いは稀な文字に集中し、語尾の規則は Parpola の番号体系でも成り立つ。
- Mahadevan の「都市の商人」(2014年)、すなわち 255 435 690 740 という句は実在する単位である。異なる22テキストに、3つの遺跡で、9種類の文字の後に現れる。しかしその前半は、ほかの名詞を修飾するのではなく、後に「690 740」か担い手の閉じ記号のどちらかを取る。そして彼が名前として読む「担い手」の文字は、閉じ記号としてふるまう。名前の主要語になるのは196回中1回である。
- ソ連のチームによる語形変化の主張は、Parpola が伝えるとおりの形では成り立たない。740 が末尾に来るのは、印章でもタブレットでも頻度は変わらず、その後に線が来ても、それでテキストが終わることは稀である。
- どのような書記体系か。同じサンプルサイズ(5,000トークン)で比べると、インダス文字は線文字Bの文字と語の間に位置し、文字のほうに近い。型の数は495で、線文字Bの文字は198、語は2,128である。稀な型の割合と予測可能性もその間にある。これは数百の文字からなる表語音節文字に合致し、Fuls(2023年)がエントロピーから到達した分類と同じである。反復性の尺度では、インダス文字はむしろウル第3王朝の印章銘に似ており、これは短く定型的なジャンルの特徴である。
- 「文字であるには反復が少なすぎる」(Farmer、Sproat、Witzel 2004年)という主張は、同じジャンルの対照実験で成り立たない。5–7文字のインダスの印章の行が文字を繰り返すのは9.5%である。5–7語のウル第3王朝の印章銘が語を繰り返すのは13.4%である。どちらもシャッフルしたテキスト(28%と34%)をはるかに下回るが、これは本物のテキストでは普通のことである。
- 公刊された鍵。Yajnadevam のサンスクリットの鍵、Fairservis のドラヴィダ語の値、Parpola の30の値について、それぞれの鍵がコーパスのどれだけを辞書にある語に変えるかを、値をシャッフルした同じ鍵の複製と比べて採点した。どれも、シャッフルしたものより自分の言語をうまく読むことはない。コーパスに盲目的に当てはめた鍵は、サンスクリットでもドラヴィダ語でもシュメール語でも同じように、コーパスの約93%を読んでしまう。したがって読める割合はそれだけでは証拠にならない。ところが、その辞書による採点は線文字Bでも失敗する。Ventris の正しい値は、シャッフルしたものの59–89%にしか勝たない。そこで、合格する第二の採点法を作った。復号した各行を、その言語の文字単位のモデルで評価するものである。取り置いた線文字Bの行で、これはギリシア語のモデルでは Ventris の鍵を100回のシャッフルのすべてより上位に置き、サンスクリットのモデルではそうしない。これを通すと、公刊された実質的な鍵のどれも、主張する言語を読まない。Fairservis の鍵は100回のシャッフルのうち12回に、Yajnadevam の鍵は7回に負け、Parpola と Mahadevan の鍵は自分のシャッフルの大半より成績が悪い。Kak の7文字の鍵が合格するのは、行末の壺 740 に sa を当てているからにすぎず、よく使われる -sa をもつ接尾辞型の言語なら何でもそれに報いるだろう。
- 値を自由に当てはめると、既知の文字体系で誤った言語を選んでしまう。線文字Bのテキストの半分で、コンピュータによって文字の値をギリシア語、サンスクリット、ドラヴィダ語、シュメール語に、それぞれ同じ自由度で当てはめ、残りの半分で採点した。最もよく当てはまったのはサンスクリットで、ギリシア語は最下位か3位であり、Ventris の値は1つも復元されなかった。したがって、値を自由に選んだ後でインダス文字がある言語に「当てはまる」という主張は、その言語を支持する証拠にはならない。
09 どのような名前か?
印章のテキストは短く、動物の下に置かれ、文法的な枠で終わる。それは個人名なのか、称号や役職なのか、神なのか。捕獲再捕獲法、すなわち生態学者が重なり合う2つの標本から個体数を推定するのに使う方法は、音価なしにこれを問う手段を与える。モヘンジョダロの印章の名前とハラッパーの印章の名前を、1つの母集団からの2回の捕獲とみなす。両方に現れる名前の数が、母集団全体の大きさを教えてくれる。
- 名前は大きく開かれた母集団であり、主要語は閉じた母集団である。1,279の印章に585の異なる名前があり、両方の都市に現れるのは20だけである。これにより母集団はおよそ3,000–5,500の名前と推定され(Lincoln–Petersen 法と Chao1 法による推定)、名前の92%はただ1つの印章にしか現れない。主要語(名前の最後の文字)はほぼすべてがすでに見えている。約130が知られており、推定は約150–220である。同じことは、1つの都市の中で、モヘンジョダロの2つの区域を比べても(観察数の7.4倍)、その前期と後期の層を比べても成り立ち、Mahadevan の別個の転写でも成り立つ。
- 線文字Bでの対照実験。クノッソスとピュロスを2回の捕獲として、ミケーネ・ギリシア語で同じ検証を行うと、既知の語の類が分離される。個人名は大きな母集団を与える(観察数の3.6倍、共有18%、71%が1枚のタブレットにのみ現れる)。称号と職業は小さく共有された母集団を与える(1.6倍、共有50%)。長い単位は意味にかかわらずより多様になるので、比較は長さを揃えてやり直した。3文字では、インダスの名前は3.0、3音節の線文字Bの名前は3.7である。4文字では3.0対3.4である。そして本物の名前は、線文字Bの名前と同じく、同じ長さの無作為な文字の組み合わせより25倍頻繁に遺跡間で繰り返し現れる。
- ウル第3王朝の印章での対照実験は、この検証が言えることをより明確にする。シュメール語の個人名は多くの人が名乗る限られた蓄えから来るので、それだけでは称号のように見える(観察数の2.0倍、共有31%)。インダスの名前と同じくらい個別的なのは、名前 + 称号 + 父の名という印章銘全体だけである(17.5倍、共有3%)。したがってこの検証が測るのは、テキスト全体がどれほど個別的かであって、それが人物を名指しているかどうかではない。インダスの印章のテキストは、線文字Bの個人名やメソポタミアの印章銘全体と同じく、個別の構成物である。メソポタミアの印章銘と違って、2つ目の名前(印章の1.6%、メソポタミアは65%)や独立した称号の行(13%、メソポタミアは71%)をもつことはほとんどない。
- 名前は印章の動物と結びついていない。同じ名前をもつ印章が同じ動物をもつ頻度は、任意の2つの印章と変わらない(12%対11%)。象、コブウシ、祭祀用の標章と偶然以上に結びつく文字もない。15の名前が3つ以上の遺跡に現れる。「590 390 740」は5つの遺跡にある。Allahdino、Chanhu-daro、Dholavira、ハラッパー、モヘンジョダロである。
10 場所と時代
- テキストは出土地点に従わない。より完全なコーパスは、各対象がモヘンジョダロのどこで見つかったか(区域、街区、家屋)を記録している。印章に書かれた内容は出土場所に依存しない。同じテキストをもつ印章は有意にまとまっておらず、1つの家屋から出た印章が特別な語彙を共有することもない。テキストの種類、語尾、動物、テキストの長さは地区によって変わらず、街路で見つかった印章も家屋で見つかったものと同じ頻度で名前である。
- 文法は変わらない。両都市の前期と後期の層の間で、語尾の枠(520 の割合、閉じ記号、400 と 90、積み重ね型の閉じ記号)と計数のテキストは変化しない。数字は変化し、モヘンジョダロでは名前の始まり方が変わる。よく使われる33の冒頭文字のどれかで始まる長い名前は、39%から66%に増え、これは長方形の印章だけでなく四角い印章でも同様である。しかしモヘンジョダロの主要語と文字の全体的な構成はハラッパーのそれに近づかないので、これは名前の始まり方の局地的な変化であって、2つの都市の用法の融合ではない。
- 字形の異体は対象と作り手に従う。同じ文字の2つの形は、1つの対象の上で、また1つのテキストの複数の写しの間で、偶然以上に一致し、媒体に依存する。家ごとの癖の痕跡も、時代による変遷もない。
- 外国の名前は文法を破る。ペルシア湾岸とメソポタミアの印章は普通のインダス文字を使うが、語尾の枠、名前の単位、通常の冒頭を欠いている。インダスのモデルでは1文字あたり6.5ビットとなり、行の内部で線の文字を多用する。これは、外国の名前を綴る際に線がその音のために使われたことを示唆しているのかもしれない。
11 語順から見える限りの言語
音価がなければ、言語について語るのは語順と文法の形だけである。4つの特徴が同じ方向を指す。
- 数字は数える対象の前に来る。
- 名前は主要部後置である。
- 語尾は名詞によって決まる短い類別接尾辞で、ほかの箇所には数や類の一致がない。
- 名前の最初の要素は開かれた集合から来ており、接頭辞の集合はない。
これはドラヴィダ語とインド・アーリア語に合致し、主要部を前に置くシュメール語とエラム語には不利である。さらに2点が範囲を狭める。語尾は人と魚の名前(Parpola の星)を分けるが、ムンダ語の文法はそうしないだろう。そして魚 = 星の語は、南アジアではドラヴィダ語にしかない。合わせるとドラヴィダ語に傾くが、それは魚の名前が星である場合に限られ、ここには語順だけでドラヴィダ語とインド・アーリア語を区別するものはない。語族についての予想は標準的な類型論であり、言語ごとに確認した典拠ではない。
候補となる言語の名前のリストからは2つの結果が加わる。ウル第3王朝の印章にあるシュメール語の個人名はその最初の要素(Ur-、Lu-、Nin-、神を表す文字)を固定するが、インダスの名前は線文字Bやサンスクリットの名前と同じく最後の要素を固定する。これでシュメール型の名前の構造は再び除外される。ドラヴィダ語とインド・アーリア語の間では、リストは決め手にならない。インダスの名前の長さはサンスクリットの名前に近い。1つの語尾の優勢(740 が名前の82%を締めくくる)は古タミル語の個人名に近く、その67%は男性形の -aṉ で終わる。これは Mahadevan が 740 をそう読む接尾辞である。より近いインド・アーリア語の比較対象が、その後この議論をひっくり返した。Lüders による初期ブラーフミー碑文のリスト(1912年)は、サーンチーとバールフトの、紀元前200年–紀元400年頃の374のプラークリットの寄進者名を挙げている。これらは寄進物に記された個人名で、時代、場所、ジャンルにおいてインダスの印章に近い。インダスの名前はそれらと同じように作られている。
- 開かれ方はほぼ同程度である(観察数の5.1倍対5.9倍)。
- 長さと閉じ方において、古タミル語の名前より近い。
- 複合語の主要部の蓄えで終わる。最も多い10のプラークリットの主要部(-rakhita、-guta、-dina、-mita …)は名前の41%をカバーし、最も多い10のインダスの主要部は43%をカバーする。
プラークリットの寄進者名にも、ほぼ普遍的な語尾が1つある。寄進の定型句の属格 -sa である。したがって 740 のような優勢な語尾は、タミル語の -aṉ と同様に、インド・アーリア語の寄進者型の定型句にも合う。これに対応するドラヴィダ語の検証には、寄進記録のタミル語の名前を使った。7世紀以降の DHARMA タミル語碑文の英訳から取った1,396の名前である。この検証は証拠を二分する。
- プラークリットの寄進者名に近い点:複合語の主要部の蓄え(インダス43%、プラークリット35%、タミル語16%)と、最後の要素の固定の強さ。
- タミル語の名前に近い点:名前の長さ(ほぼ同一)と、単一の優勢な接尾辞(740 は名前の82%、タミル語の -aṉ は47%、プラークリットで最も多い語幹語尾は23%)。
したがって、名前の構造はシュメール型を除外するが、インド・アーリア語とドラヴィダ語の間の決め手にはならない。タミル語の記録はプラークリットのリストよりずっと後のもので、その名前の多くはサンスクリット由来でもある。
次に、Mahadevan の Early Tamil Epigraphy のページスキャンから、同時代のドラヴィダ語のリストを作った。紀元前2世紀頃–紀元4世紀頃のタミル・ブラーフミー洞窟碑文から取った104の寄進者名である。これは時代とジャンルにおいてプラークリットのリストに対応する。
- プラークリットの名前に近い点:構造の3つの尺度すべて。最後の要素の固定度:インダス0.83、プラークリット0.90、タミル・ブラーフミー1.45。長さ。そして主要部の蓄え:43%、35%、30%。
- タミル・ブラーフミーの名前に近い点:優勢な接尾辞(82%対 -aṉ の73%)。ただしこの対照は部分的には資料によって作られたものである。Lüders はプラークリットの名前を格語尾なしで挙げているからである。
これらの尺度では、インダスの名前は同時代のタミル語の名前よりも初期インド・アーリア語の寄進者名に似ているように見えた。後の対照実験がそれを撤回させた。類型を揃えた囮として、インダスの語順の特徴を共有する言語である日本語とトルコ語の個人名を加えた。南アジアの2つの寄進者リストは両方の囮に勝ったが、それらは碑文であり、囮は名前のリストだった。両側でジャンルを揃えると(Monier-Williams のサンスクリット名とサンガム詩人の名前を、同じ日本語とトルコ語のリストと比べると)、データのどちらの半分でも日本語がインダスの名前に最も近くなった。先の傾きはジャンルによるもので、言語によるものではなかった。この種の名前の構造の統計では言語を選ぶことはできない。
世界の類型論は範囲を狭めるが、それ以上ではない。インダスの語順の特徴を WALS と Grambank のデータベースと照合すると、世界の言語の属の81%(Grambank の語族の68%)が除外される。ドラヴィダ語、インド・アーリア語、ムンダ語、ブルシャスキー語、テュルク語、モンゴル語、日本語、朝鮮語はすべて残る。唯一の類の信号(主要部が魚の名前は 520 を取り、主要部が人、道具、植物の名前は 740 を取る)は、モヘンジョダロ、ハラッパー、その他の遺跡で、前期にも後期にも成り立つ。これはドラヴィダ語の人/非人の区別にも、星の名前の大半が女性形であるサンスクリットの性による読みにも、同じように合う。
12 賞金に照らした基準
2025年1月、タミル・ナードゥ州政府は、この文字を「to the satisfaction of archaeological experts」解読した者に100万米ドルを提供すると発表した。それ以上の規則は公表されていない。ここでの作業は、そのような審査団が必要とするであろうものに照らして、重みの順に採点した(targets/indus/PROGRESS.md, prizebench.py):
- 確認された意味:意味として読まれ、外部の証拠(同じ対象の図像、その用途、出土場所)によって確認された文字。現状:文字トークンの0.008%、すなわち銅板の図像文字。数字(16.6%)は別に数える。読解の一歩手前の段階として、11のテキスト全体が図像によって指示対象を固定されている。それぞれが、1枚ずつ作られた3枚以上の銅板または刻線タブレットに書かれ、同じ図像を伴う。ウサギ、射手、象、ヤギ、インドガビアル、魚、雄牛、そして「輪」である(図像をシャッフルした場合に対して p = 0.001)。15の2文字の句が、本当に異なるテキストにわたって、個別に作られたタブレットの上で、また異なる型押しの図柄にわたって同じ検証に合格する。その中には葉の文字を伴う木の句 806 158 がある。1つのテキストの部分的な転写は、数える前に統合した。テキストと句を合わせると文字トークンの0.76%になり、読まれることなく場面にラベルを付けている。ただし、それらは局地的なラベルである。刻線タブレットである図像と結びつく句は、型押しタブレットの図像を予測せず、その逆も同様である(40中1)。この方法はまず線文字Bで検証した。そこでは表意文字が図像の役割を果たす。この方法は1つの表意文字と結びつく143の語を選び出し(偶然なら2)、車輪の表意文字と a-mo-ta「車輪」のような既知の組を復元する。印章では、この方法は既定の一角獣の雄牛以外のどの動物についても何も見出さない。したがって印章のテキストはその動物を名指していない。図像は反対側から文法を検証することにもなる。それまでのどの検証にも使っていなかった型押しタブレットでは、語尾、標識、数字を含む文字の対は、内容を表す2文字の対よりもはるかに多くの異なる図像と結びつく(出現1回あたりの異なる図像の数は0.45対0.28、p = 0.001)。文法が文法的とみなす文字は、それ自身の指示対象をもたない。
- 陽性対照:方法はまず既知の答え、すなわち線文字Bからギリシア語を復元しなければならない。6つの方法のうち3つが合格する。音価の置換テスト、8節の文字モデルによる鍵の採点法、そして図像の指示対象による方法である。辞書による採点と自由な鍵の当てはめは失敗する。
- 未見のテキスト:値を、それを決めるのに一度も使われていないテキストで試す前に固定すること。Ventris の値が、彼の解読の後に見つかったピュロスのタブレットで試されたように。現状:なし。音価が1つも合格していないからである。
- 補助的なもの:考古学的な整合性、同じジャンルの囮に対する言語、予測課題。隠した文字は40%の確率で第1候補として、62%で上位5候補以内で当てられる(頻度だけでは9.6%と22%)。改善は、字形の系統によって文字を読むことと、割引による平滑化から得られた。(行の冒頭文字で条件付けることによる見かけの改善は、最初の文字がそれ自身から予測されていたという漏洩であり、撤回した。)ここでいう字形の系統とは、籠、壺や U の内側の線、魚の上の印のことである。この効果は、系統を ICIT の番号体系から取っても Parpola 自身の文字の記述から取っても成り立ち、文脈から学習した類ではまったく得られない。それ以上に較正のよいモデルは、1文字あたりのビット数を下げるが、第1候補の的中を改善しない。
第1段階と第3段階を引き上げようとする試みから、2つの発見が得られた。タブレットの図像は、型から繰り返されたテキスト全体と結びつくのであって、単一の文字とではない。タブレットの半分で固定した図像の意味は、未見の38枚中1枚しか予測しない。共有された2文字の句には弱い傾向がある(各テキストを順に1つずつ除くと17%で正解、p = 0.05)。その大半は象の句 706 33 923 740 と木の句 806 158 である。タミル・ナードゥ州の落書き記号(Rajan and Sivanantham 2026, vol. II)を、文字の等式を必要としない検定でインダスの行と比較した。2つの落書きの要素が一緒に現れる場合、それらが同じ順序を保つのは70.5%で、インダス文字では88.0%である。この数字は Keeladi でも Thulukarpatti でも同じである。記録されている限り、落書きの組み合わせはインダスの書記より秩序が弱い。
同じループから、構造上の追加が2つ得られた。計数の直前の枠は、両コーパスで、限られた集合、すなわち計数のためのラベルで埋められる。最も多い10の文字がこの枠の52%と58%を占め、シャッフルした行よりはるかに多い。一部は見出しだが、それだけではない。そしてこの規則を加えた文法は、未見の行をシャッフルした行よりもわずかに大きな差でうまく解析する。
最も強い補助的結果は整合性である。学習した部分を含めて文法をある場所の行に当てはめ、別の場所で、シャッフルした行に対する差として採点する。
- モヘンジョダロで学習すると、ハラッパーの行を自分の行とほぼ同じくらいうまく解析し(43.8対44.8ポイント)、その逆も成り立つ。
- 2つの都市で学習すると、小さな遺跡の行を解析する(36.1)。
- 印章で学習すると、タブレットを解析する(43.6)。
- 後期ハラッパーで学習すると、前期の層を解析する(27.0)。
字形の工夫、計数ラベルの枠、魚/520 の類の信号は、どの都市でも、印章でもタブレットでも同じようにふるまう。籠で囲まれた文字は決して 740 も 520 も取らず、線の入った壺が行を終えることはほとんどない。1つの文法体系がインダス世界全体で用いられていたので、どんな読みもあらゆる場所でそれに合わなければならない。名前に接頭辞が見られないことから、言語に接頭辞がないことを条件にすると、類型はさらに絞られる。WALS の属の85%、Grambank の語族の77%が除外される。
この基準で勝つものは何か。70ほどのよく使われる文字に値を与え、大半のトークンを1つの言語の文法的な句として読むこと。その意味は、数種類の外部の証拠と一致しなければならない。方法は線文字Bの対照実験に合格し、値を決めるのに一度も使われなかったテキストを読み、それを作っていない専門家によって再現されなければならない。本研究は、そのような主張が合格すべき文法と検証を提供する。読みは何一つ提供していない。
13 未解決のまま残る点
- 証拠によって強制される音価をもつ文字は1つもなく、言語も特定されていない。上に示した構造を超えると、内部的な検証は尽きた。最後の数ラウンドは、大半が帰無結果と訂正だった。残っているものには新しい資料が必要である。二言語併記の銘文、新たに発掘された銘文のある対象、あるいはデジタル化された CISI 第2巻と第3巻である。(ICIT の完全なデータベースはすでにここで使っている。書き出しは5,680件の記録すべてを含み、分析は損傷したテキストを除いた3,681の良好なテキストを使っている。)
- 銅板の7つの文字 = 図像の等式(749、341、753、777、レンズ形の文字)が最も確かな意味である。どの言語による読みも、これらに合わなければならない。
- メソポタミアの印章銘が個人名と役職や家系を複数の行に分けて書くのに対し、インダスの名前がそれらを1つの単位に詰め込んでいるのかどうかは未解決である(14節を参照)。
14 途中で撤回したこと
予測を先に登録するということは、本プロジェクト自身の読みのいくつかが後の検証によって覆されたということである。それらは記録に残し、ここに挙げる。
- 音を表す文字の候補リスト(線文字Bの音節文字のように隣接文字と自由に結びつく46文字)は、登録した3つの検証のすべてに失敗した。稀な名前ほど自由な文字を使うという関連した発見は線文字Bでも現れたので、稀な語に一般的な効果である。
- 「2つの数体系」(初期の読み)は、いくつかの線の形をもつ1つの数体系になった。ハラッパーのタブレットでは、長い線は計量の文字 700 と結びつく。
- 「役職 + 名前」。称号のような最初の文字と、人名のような名前の残りとの対照は、単一の文字と複数文字の単位を比べていたことがわかった。単一の文字はほとんど定義上、閉じた集合である。長さを統制すると、最初の文字と印章の動物との弱い結びつきしか残らなかった。
- 「数字の複合語は地域的な命名の慣習である」。線文字Bの計数もまったく同じくらい地域的であることがわかったので、これは「計数と同じく地域的」へと撤回した。
- 「モヘンジョダロはハラッパーに収束する」。これは名前の始まり方の局地的な変化へと訂正した(10節)。
- 「インダスの名前は個人名である」。これはウル第3王朝の対照実験によって「個別の構成物」へと絞り込まれた(9節)。
- 「インダスの名前の構造はインド・アーリア語に近い」。ジャンルを揃えると、日本語の囮のリストのほうがさらに近くなる。この傾きは、資料が碑文であることから生じていた(11節)。
- 「共有された句はタブレットの図像を予測する」(ある分割で p = 0.001)。3つ目の分割では失敗し、各テキストを順に1つずつ除くと p = 0.05 にしかならない。都合のよい分割だったのである(12節)。
15 出典
- A. Parpola, “Study of the Indus Script”, Transactions of the International Conference of Eastern Studies 50 (2005), 28–66, harappa.com;Deciphering the Indus Script(Cambridge, 1994)。
- J. P. Joshi and A. Parpola, Corpus of Indus Seals and Inscriptions 1(Helsinki, 1987);その公開デジタル化版 mayig/indus-valley-script-corpus(MIT)。
- indus-website プロジェクトの ICIT 派生コーパス(github.com/yajnadevam/indus-website);A. Fuls, Corpus of Indus Inscriptions(Berlin, 2022)および A Catalog of Indus Signs(Berlin, 2023);A. Fuls, “Comparison of Linear Elamite and Indus Writing Systems”, Iranian Journal of Archaeological Studies 14.1 (2024), 3–16。
- I. Mahadevan, The Indus Script: Texts, Concordance and Tables(1977)、機械可読版は github.com/joyboseroy/indus_decipher;I. Mahadevan, Dravidian Proof of the Indus Script via the Rig Veda: A Case Study(Bulletin of the Indus Research Centre 4, 2014)。
- 言語の比較対象:H. Lüders, A List of Brahmi Inscriptions(Epigraphia Indica X 付録、1912年;Internet Archive);DHARMA、Early Inscriptions of Āndhradeśa およびタミル語コーパス(erc-dharma tfa-*、CC BY 4.0);Wikipedia、List of Sangam poets;Monier-Williams;I. Mahadevan, Early Tamil Epigraphy(Harvard Oriental Series 62, 2003)、付録 II、Internet Archive のスキャンより。
- 対照実験:DAMOS, Database of Mycenaean at Oslo(線文字B)、Tiripode 語彙集とともに;ORACC epsd2/admin/ur3(ウル第3王朝の印章銘、CC0);Monier-Williams(Cologne Digital Sanskrit Lexicon);ePSD2;CLICS4;L. L. Merriam and A. Fuls, The Dravidian Database(Zenodo, 2026)。
- 類型論と囮:M. S. Dryer and M. Haspelmath (eds.), WALS Online(2013)および H. Skirgård et al., Grambank(2023)、いずれも CLDF リリース、CC BY 4.0;JMnedict(EDRDG、CC BY-SA 4.0);トルコ語の個人名の頻度(github.com/eoner/turkce_isimler)。
- 賞金と落書き記号:2025年1月5日の発表(Archaeology Magazine の報道による);K. Rajan and R. Sivanantham, Indus Signs and Graffiti Marks of Tamil Nadu: A Morphological Study(2025)および Inscribed Potsherds of Tamil Nadu: Graffiti and Tamiḻi, vol. II(2026)、タミル・ナードゥ州政府考古局、Tamil Digital Library より。
スクリプト、登録した仮説(PREDICTIONS.md)、各組の結果(results/)、作業ノート(NOTES.md)は、リポジトリのフォルダ targets/indus/ にある。