速览未破解 · 2,727项登记假设中有1,425项成立
- 文本
- 出发点是 Asko Parpola 的讲座“Study of the Indus Script”(ICES 东京2005年,见 harappa.com)。其背后的铭文约有4,500件印章、刻板和陶片,大多数不到五个符号。
- 藏地
- 两份独立制作的机器可读转录:一份是源自 Interactive Corpus of Indus Texts(ICIT;Wells 和 Fuls)的数据库,另一份是 Mahadevan 1977年的索引(M77)。这里将两者逐个符号对应起来。Parpola 本人的Corpus of Indus Seals and Inscriptions的一份数字化版本作为第三重核对。
- 文字
- 约400–600个符号,大多从右往左书写,没有分词符,没有双语对照,所记语言不明。
- 尝试经过
- 首先,把 Parpola 讲座中和他1994年读法表中的每一个计数都重新算了一遍,并为他的泰米尔语检验设定了随机基线。然后,在查看数据之前,写下并提交了247组假设,共2,727项。每一项都经过检验,无论成立与否都记录在案,主要结果还在留出样本上、并对照两种可以读懂的文字(线形文字B、乌尔第三王朝楔形文字)重新运行。
- 结果如何
- 一套详细的语法,但没有任何音值。名字以一个槽位结尾,其形式(740、520或某个结尾符)由名字的最后一个符号决定。书写者从不在换行处拆开一对紧密结合的符号,也从不把名字与其词尾拆开。数字与它们所计数的符号固定搭配。印章上的名字表现得像人名,与同样长度的线形文字B名字一样。Parpola 的星名读法每一个都只依据一两枚印章。
- 尚未解决
- 一切与语音有关的东西,以及语言本身。对照泰米尔纳德邦奖金所需要的条件(第12节),决定一项解读能否成立的那几个层级几乎为零。本项目自己早先的几条结论被后来的检验推翻而撤回;它们列在第14节。
01 语料与符号
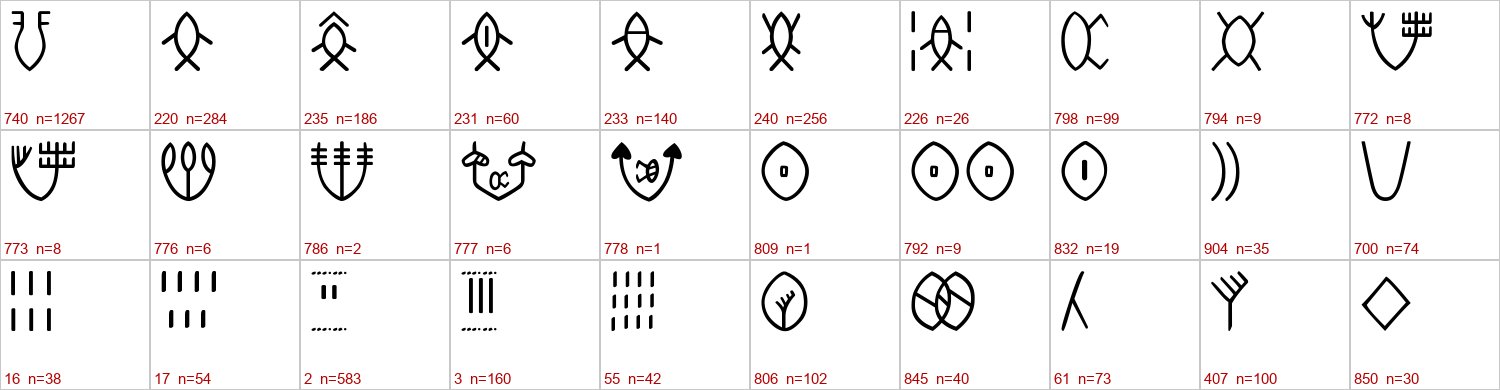
Parpola 的论证都是计数:最常见的符号出现得多频繁,哪些符号一起出现,哪些从不一起出现。为了重新运行这些计数,本项目使用了两份彼此独立制作的转录。第一份是源自 Interactive Corpus of Indus Texts(Wells 和 Fuls)的数据库,随 indus-website 项目发布:2,543件器物,11,253个符号,附有 CISI 器物编号、遗址和野外记录的图案。同一数据库的一份更完整的导出(5,680条记录,附出土地点、地层、尺寸和材质)用于后来的大多数检验。就所核对的符号而言,它的符号总数与 Fuls 的Catalog of Indus Signs(2023)中刊印的数字十分接近。ICIT 的符号只有编号,所以这里用数据库自己的字体把每个符号画出来,再对照 Parpola 的描述加以辨认。第二份转录是 Mahadevan 1977年的索引(2,906件文本)。两份符号表通过对齐它们共有的文本联系起来:991行,96%的符号对应唯一的对应符号。第一套语料中缺少的1,664件 M77 文本,自始至终都用作独立的复现样本。
02 讲座中的论断,逐一核对
- 最常见的符号(“罐”,740)几乎占全部符号的10%:M77 中为9.9%,ICIT 中为11.3%。在南亚,它从不与自身相邻(0次,而如果打乱每行内部的顺序,预期为4.0次,p 约为0.007)。正如 Parpola 所说,它在每套语料中都只与自身相邻一次,出现在同一枚出处不明的圆形印章上。
- 在海湾地区和美索不达米亚发现的印章以不寻常的顺序使用常见符号。有一枚方形印章(阿曼 Salut)也不寻常,这与讲座所说相反。
- 鱼形符号占印章符号的9.7%。蟹与鱼形符号相邻的频率远高于随机,但它旁边是带标记的鱼,而不是素鱼。
- “7 + 鱼”被读作大熊座,在两套语料中都只出现一次,在哈拉帕的一枚印章上。“无花果 + 鱼”即北极星,出现两次(M-172,以及 M-414,已对照 CISI 第1卷中的照片核实)。
- 鱼之前的数字。Parpola 称“6 + 鱼”(昴星团)是最常见的“数字 + 鱼”序列。把每件不同的文本只计一次,最常见的是“2 + 鱼”(113件文本),其次是“3 + 鱼”(28件);“6 + 鱼”只有8件。在 CISI 数字化版本所覆盖的印章上,Parpola 本人的转录给出同样的答案:2 + 鱼十三次,6 + 鱼零次。如果把每个副本都计入,或改用 Mahadevan 的转录,2 + 鱼仍然最常见(117例和123例,而6 + 鱼为9例和12例)。三份转录、两种计数方式结论一致,所以这种差异并不取决于 ICIT 如何辨认符号。“2”中有一部分是长笔画对(113行中的51行),Parpola 不把它读作数字,而是读作vēḷ,“长笔画对 + 鱼”就是他的“金星”。即便去掉这部分,短笔画的2 + 鱼(60)也远多于6 + 鱼(8)。
03 1994年的读法与泰米尔语检验
Parpola 1994年的书最后附有一张24个读法的表,以及他所依据的99个带mīn“鱼、星”的泰米尔语复合词的清单。在两套语料中,以下这些符号对都是真实的、反复出现的单位:3 + 鱼、6 + 鱼、眼睛 + 眼睛、炉灶 + 圆环、圆环 + “空间”,以及“空间” + 鱼。鱼 + 鱼、7 + 鱼、无花果 + 鱼、无花果 + “空间”和蟹 + 素鱼则处于或低于随机水平。书中说鱼之前的数字“仅限于3、4、6和7”。语料中有1、2、3、4、6、7和12,从来没有5,尽管泰米尔语中有对应5的星名。
每个读法背后的检验,都是它所给出的复合词是不是一个真实的泰米尔语词。一条随机基线表明这种检验有多弱。预先确定98个图画概念。表示该图画的某个泰米尔语词,有15%的概率恰好是 Parpola 的某个泰米尔语星名的开头;如果允许这些读法所用的语音宽容度,概率是30%。
04 铜板:七个“符号 = 图像”等式
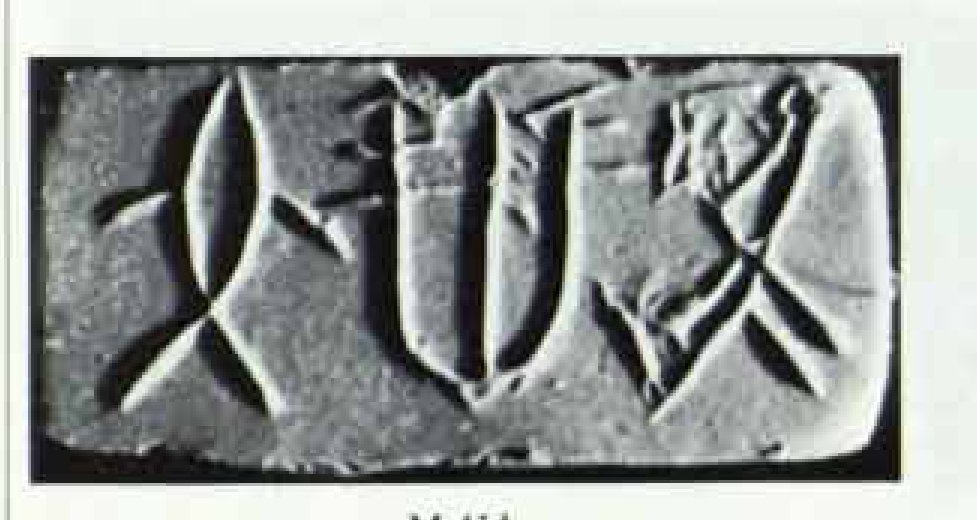
摩亨佐-达罗的铜板成套出现,每套由相同的副本组成。每块一面有铭文,另一面是动物或人物,而在某些套中,单个符号取代了图画,铭文相同。把 Parpola 对46套铜板的分类与转录相匹配,得出七个等式:
- 无花果 + 蟹合体777 = 捻角山羊以及带角的弓箭手;
- 符号749 = 捻角山羊;
- 341 = 犀牛;
- 753 = 野兔;
- 一个透镜形符号 = 长角公牛;
- “3 700 900 165” = 一头带斑点的公牛。
这些是这种文字所能提供的最可靠的意义。图画符号749、341和753只出现在铜板上,777另外还出现在一枚印章上:没有任何印章名字用到它们。许多印章文本开头的那个起首符,从不出现在铜板文本的开头(198件中0件)。铜板的表现与印章不同。在第9节的捕获–再捕获检验中,铜板文本构成一小组封闭的标签,像称号一样在全城重复出现,而印章文本则各不相同。铜板上的图画还按摩亨佐-达罗的城区聚集:只有文字的铜板在 DK-G 南区,动物系列在 VS-A 区,人物和合成形象在卫城土丘上。
05 哪种语言?以梵语和苏美尔语作对照
对梵语(Monier-Williams)和苏美尔语(ePSD2 词表)也做了同样的检验。一幅图画得出一个星名的概率,梵语为19%,苏美尔语为10%,泰米尔语为15%。“鱼 = 星”这个双关也不是达罗毗荼语独有:苏美尔语mul是“星”,也是一种鱼;梵语有ṛṣi(一种鱼;大熊座的七仙人)。不过,在2,895种语言中(CLICS4),“鱼”和“星”的日常用词只在三种语言中相同,没有一种在南亚,而古泰米尔语mīn就是其中之一。所以,每一个鱼形读法的第一步确实是达罗毗荼语所特有的,尽管建立在它之上的泰米尔语复合词检验并非如此。鱼之前的数字并不符合泰米尔语的星名:只有6 + 鱼(昴星团)出现得偏多,而5 + 鱼从未出现。
06 其余部分如何完成:检验前登记的假设
上述核对之后的所有工作,都是作为登记在案的预测来运行的。每一组的假设及其阈值都写进 targets/indus/PREDICTIONS.md 并在任何脚本查看数据之前提交到仓库。然后运行检验,记录结果成立还是失败,不改动阈值。以这种方式运行了247组,共2,727项假设:1,425项成立,1,302项失败。从第176组起,它们以循环方式运行,按一个固定的进展指标打分(targets/indus/PROGRESS.md)。凡是某项检验后来被证明提法不当,或某个脚本有 bug,记录中都会注明,并在原结果旁给出更正后的结果。
计数针对的是不同的文本。同一枚印章在许多封泥上压印,或者一批相同的铜板,都只计一次,因为重复的副本会夸大任何模式。主要结果都在未用于发现它们的样本上重新运行过:Mahadevan 的 M77 补充部分、较小的遗址、不含铜板的更完整语料,以及 Parpola 的 CISI 转录。两种可以读懂的文字作为对照:线形文字B(迈锡尼希腊语,取自 DAMOS 数据库)和乌尔第三王朝时期的印章铭文(苏美尔语,取自 ORACC 的22,402个印文)。
07 一种读法必须符合的语法
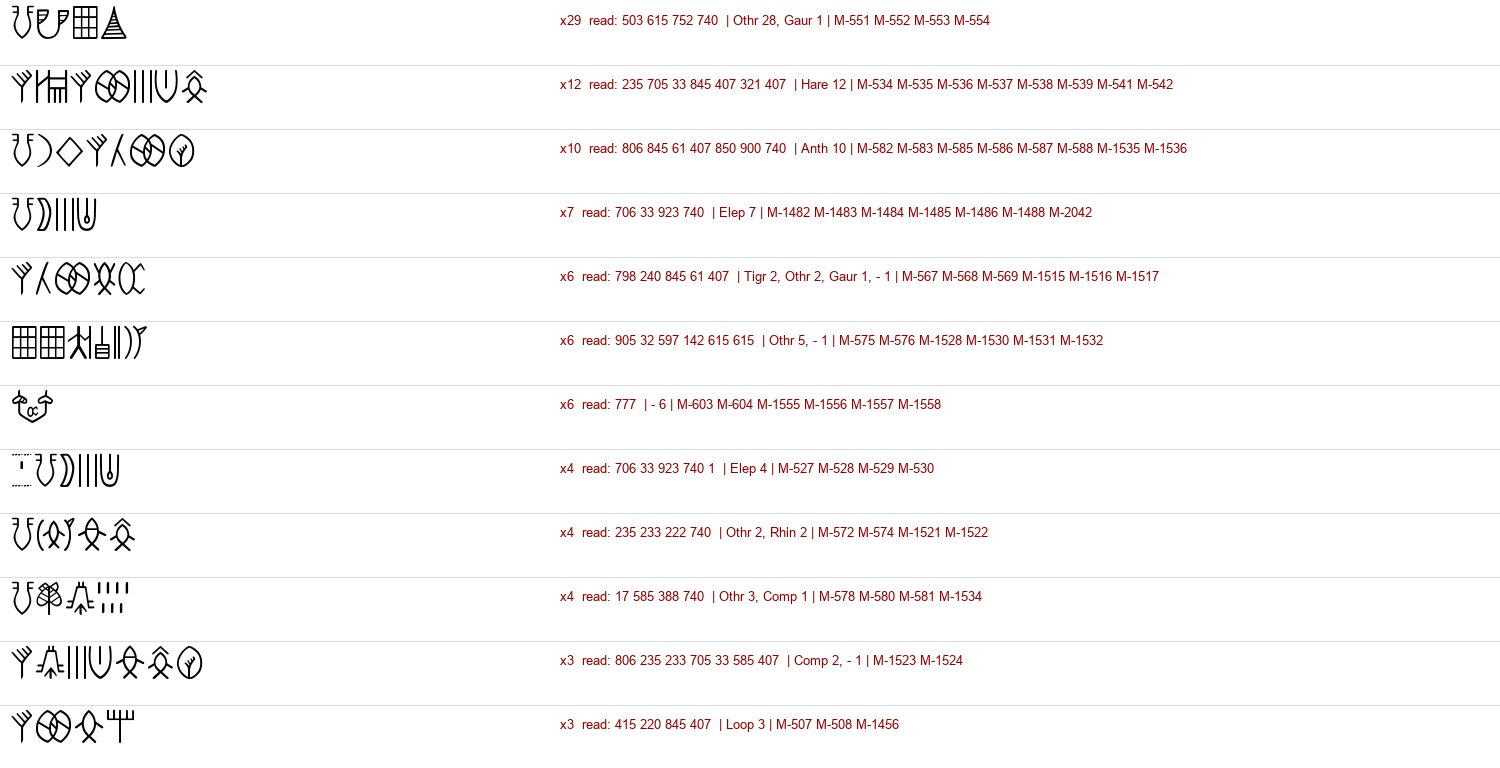
- 同一套词汇上的四类文本。几乎每一行都是以下之一:带词尾的名字,以“结尾符”结束的行,计数(数字加所计之物),或者不带词尾的单纯序列。2,722个不同的行中只有3行不属于这四类中的任何一类。每个符号在全部四种框架中都保持其位置和搭配。
- 词尾槽位是一个由名字最后一个符号选择的词形变化表。名字以罐740、“箭”520、十几个结尾符之一,或740后接一个叠加结尾符来结束。然后可选地接400,或者90(只接在740之后)。名字的最后一个符号预示它取哪种词尾(对此建立的模型能预测 Mahadevan 那份独立转录中95%的词尾)。881个名字中只有5个同时与740和520一起出现过。740和520从不相邻。
- 两种词尾并不相同。740是开放词尾:凡是以晚期地层中才首次出现的主词构成的名字,都取这个词尾(34个中的34个)。520名字在163个名字中只用了26个不同的主词,大多是鱼形符号,还包括一些固定表达,例如印章结束套语“705(或706)+ 长3 + 520”。
- 名字是中心语居后的。词尾跟在名字的最后一个符号之后,而不是第一个。名字在已有名字的前端增长,数字位于所计之物之前(472例对106例)。这是达罗毗荼语和印度-雅利安语的语序,与苏美尔语和埃兰语相反。没有数的一致,也没有长串的后缀:词尾槽位短小且封闭。
- 换行尊重这些单位。在多行的印章和铜板上,无论行序如何,书写者从不把30个结合最紧密的符号对中的任何一对拆到两行(0次,随机预期约5次)。他们几乎从不拆开一个反复出现的名字单位,或者把名字与其词尾拆开。每一行都是四类文本之一的完整文本,而如果某一行是名字,另一行就是一个独立的字段。符号1和2并不充当分词符,这一点 Fuls(2024)在反驳 Wells(2011)时已有论述。
- 数字与它们所计数的符号固定搭配。同一套数字系统用于各类文本,用短笔画、长笔画和分层笔画书写。在名字内部,某个符号之前的数字是固定的,仿佛“数字 + 符号”是一个词。同一符号之前最常见的数值,在摩亨佐-达罗和哈拉帕之间只有39%的符号一致,“2 + 鱼”是共有的例外。但真实的计数也差不多同样具有地方性:在线形文字B中,17种物品里有8种,其最常见的数量在克诺索斯和皮洛斯之间不同。所以这看起来像是计数,而不是某种命名习俗。
- 可预测性。一个基于符号位置和相邻符号的模型,对留出文本的预测为每符号4.66比特。半数符号可以从其两侧邻居猜出。而且这种文字有禁止的组合:20对常见符号,按随机本应相邻五次或更多,却从未出现,这类组合是打乱后各行中的17倍。例如,鱼220和240从不直接出现在390之前。
08 第二份转录,以及他人的论断
- Parpola 本人的转录结论一致。Corpus of Indus Seals and Inscriptions的开放数字化版本覆盖了摩亨佐-达罗印章 M-1 至 M-184。在这些印章上,它与 ICIT 转录在器物长度上的一致率为96%,在符号位置上为92%,在最后一个符号上为98%。分歧都落在罕见符号上,而在 Parpola 的编号体系中,词尾规则同样成立。
- Mahadevan 的“城市的商人”(2014),即短语255 435 690 740,是一个真实的单位。它出现在22件不同的文本中,分布于三处遗址,跟在九个不同的符号之后。但它的前半部分后面接的要么是“690 740”,要么是一个“持有者”结尾符,而不是去修饰其他名词。而他读作名字的那些“持有者”符号,表现得像结尾符:它们在196次中只有1次是名字的主词。
- 苏联团队关于屈折变化的论断,按 Parpola 的转述,照其原样是不成立的。740在印章上处于末尾的频率并不比在铜板上更高,而它后面的一道笔画也很少位于文本结尾。
- 是什么样的文字。在相同的样本量(5,000个记号)下比较,印度河符号介于线形文字B的符号与其词之间,更接近符号:495个类型,对比198和2,128,罕见类型的比例和可预测性也居于两者之间。这符合一种有几百个符号的语素音节文字,也就是 Fuls(2023)根据熵得出的那一类。而在重复性指标上,印度河符号则更像乌尔第三王朝的印章铭文,这是一种简短程式化体裁的标志。
- “重复太少,不可能是文字”(Farmer、Sproat 和 Witzel 2004)这一论断,在同一体裁的对照上站不住脚。5–7个符号的印度河印章行,有9.5%的情况出现符号重复。5–7个词的乌尔第三王朝印章铭文,有13.4%出现词重复。两者都远低于打乱后的文本(28%和34%),这对真实文本来说是很正常的。
- 已发表的密钥。对 Yajnadevam 的梵语密钥、Fairservis 的达罗毗荼语音值和 Parpola 的30个音值进行了打分,看每把密钥能把多少语料变成词典中的词,并与把同一把密钥的音值打乱后的副本相比较。没有一把密钥读出自己所声称的语言的效果好于其打乱版本。一把盲目拟合语料的密钥,能把约93%的语料读成梵语,也能同样读成达罗毗荼语或苏美尔语,所以单凭阅读率本身不构成证据。不过,这种词典得分在线形文字B上也失效了:Ventris 的正确音值只胜过其打乱版本的59–89%。于是另建了一个能通过检验的打分器:每一行解码结果都由该语言的字符模型来评分。在留出的线形文字B行上,配合希腊语模型,它把 Ventris 的密钥排在全部100个打乱版本之上,而配合梵语模型则不然。用这个打分器检验,没有任何一把像样的已发表密钥能读出它所声称的语言:Fairservis 的密钥被100个打乱版本中的12个击败,Yajnadevam 的被7个击败,而 Parpola 和 Mahadevan 的密钥则比它们的大多数打乱版本还差。Kak 的七符号密钥之所以能通过,只是因为它把sa放在了行末的罐740上,任何带有常见后缀-sa的后缀型语言都会因此得分。
- 自由拟合音值,在一种已知文字上会选错语言。在一半线形文字B文本上,用计算机把符号音值分别拟合到希腊语、梵语、达罗毗荼语和苏美尔语,每种语言给予同样的自由度,然后在另一半文本上打分。梵语拟合得最好,希腊语排在最后或第三,Ventris 的音值一个也没有复原出来。所以,在自由选择音值之后声称印度河文字“符合”某种语言,并不构成支持该语言的证据。
09 什么样的名字?
一段印章文本很短,位于一只动物下方,以一个语法槽位结尾。它是人名、称号或官职,还是神名?捕获–再捕获,即生态学家用两个相互重叠的样本来估计种群数量的方法,提供了一种不需要音值就能提出这个问题的途径。把摩亨佐-达罗印章上的名字和哈拉帕印章上的名字当作从同一个种群中捕获的两批。有多少名字同时出现在两批中,就能说明整个种群有多大。
- 名字是一个庞大的开放种群;主词则是一个封闭的种群。1,279枚印章上有585个不同的名字,只有20个同时出现在两座城市。据此估计种群约有3,000–5,500个名字(Lincoln–Petersen 估计和 Chao1 估计),且92%的名字只出现在一枚印章上。主词(名字的最后一个符号)几乎都已经见过:已知约130个,估计约150–220个。在一座城市内部也是如此,无论是比较摩亨佐-达罗的两个区域(观察数的7.4倍),还是比较其早期和晚期地层,在 Mahadevan 的那份独立转录中也一样。
- 线形文字B上的对照。对迈锡尼希腊语做同样的检验,以克诺索斯和皮洛斯为两批捕获,可以把已知的词类区分开来。人名给出一个庞大的种群(观察数的3.6倍,18%共有,71%只见于一块泥板)。称号和职业给出一个小的、共有的种群(1.6倍,50%共有)。比较又在匹配长度的条件下重做了一遍,因为无论含义如何,较长的单位总是更多样。在三个符号时,印度河名字为3.0,三音节的线形文字B名字为3.7;在四个符号时,为3.0对3.4。而且,真实的名字在不同遗址之间重复出现的频率,是同样长度的随机符号组合的25倍,线形文字B的名字也是如此。
- 乌尔第三王朝印章上的对照使这一检验所能说明的东西更加明确。苏美尔人名来自一个有限的名字库,由许多人共用,所以单看人名,它们就像称号(观察数的2.0倍,31%共有)。只有完整的印章铭文,即“名字 + 称号 + 父名”,才像印度河名字一样具有个体性(17.5倍,3%共有)。所以这项检验衡量的是整段文本的个体性有多强,而不是它是否为某个人命名。印度河印章文本是各自独立的组合,就像线形文字B的人名和完整的美索不达米亚印章铭文。与美索不达米亚铭文不同的是,它们几乎从不带第二个名字(印章中占1.6%,对比65%),也几乎不带单独的称号行(13%,对比71%)。
- 名字与其印章上的动物没有关联。带同一个名字的印章,刻同一种动物的频率并不比任意两枚印章更高(12%对11%),也没有任何符号与大象、瘤牛或祭祀标杆的关联超出随机水平。有十五个名字出现在三处或更多遗址。“590 390 740”出现在五处:Allahdino、昌胡-达罗、朵拉维拉、哈拉帕和摩亨佐-达罗。
10 地点与时间
- 文本不随出土地点而变。更完整的语料记录了每件器物在摩亨佐-达罗的出土位置(区域、街区、房屋)。印章上写的内容与它的出土地点无关。文本相同的印章没有显著的聚集,同一所房屋出土的印章也没有共享的特殊词汇。文本类型、词尾、动物和文本长度都不因城区而异,街道上发现的印章与房屋中发现的印章,是名字的比例一样高。
- 语法保持不变。在两座城市的早期和晚期地层之间,词尾槽位(520的占比、结尾符、400和90、叠加结尾符)和计数文本都没有变化。数字有变化,而在摩亨佐-达罗,名字的开头方式发生了转变。以33个高频起首符号之一开头的长名字,从39%上升到66%,方形印章和长方形印章都是如此。但摩亨佐-达罗的主词和整体符号构成并没有向哈拉帕靠拢,所以这是名字开头方式的局部变化,而不是两座城市用法的融合。
- 字形变体随器物和制作者而定。同一符号的两种写法,在同一件器物上、在同一文本的不同副本之间,一致的程度都高于随机,并且取决于载体材质。没有任何家族习惯的痕迹,也没有随时间的漂移。
- 外来名字打破了语法。海湾地区和美索不达米亚出土的印章使用普通的印度河符号,却没有词尾槽位、名字单位和常见的开头。在印度河模型下,它们的得分为每符号6.5比特,而且在行内大量使用笔画符号。这也许暗示,在拼写外来名字时,笔画是按读音使用的。
11 就语序所能显示的而言,这种语言
没有音值,就只有语序和语法的形态能说明语言。有四个特征指向同一个方向:
- 数字位于所计之物之前;
- 名字是中心语居后的;
- 词尾是一个由名词决定的简短类别后缀,其他地方没有数或类别的一致;
- 名字的第一个成分来自一个开放集合,没有一套前缀。
这符合达罗毗荼语和印度-雅利安语,而不利于把中心语放在前面的苏美尔语和埃兰语。还有两点进一步缩小了范围。词尾把人与鱼形名字(Parpola 的星)区分开来,而蒙达语的语法不会这样做。而且,“鱼 = 星”这个词在南亚只见于达罗毗荼语。两者合起来偏向达罗毗荼语,但前提是鱼形名字确实是星名,而且这里没有任何东西能单凭语序把达罗毗荼语和印度-雅利安语区分开。各语系的预期依据的是标准类型学,并非针对每种语言逐一核对过的来源。
候选语言中的名字列表又带来了两个结果。乌尔第三王朝印章上的苏美尔人名固定的是第一个成分(Ur-、Lu-、Nin-、神名符号),而印度河名字固定的是最后一个成分,线形文字B和梵语名字也是如此。这再一次排除了苏美尔式的名字结构。在达罗毗荼语和印度-雅利安语之间,这些列表无法作出判断。印度河名字的长度更接近梵语名字。一种词尾占主导(740结束了82%的名字),则更接近古泰米尔语人名,其中67%以阳性后缀-aṉ结尾,Mahadevan 正是把740读作这个后缀。随后,一个更贴近的印度-雅利安语参照又让论证掉转了方向。Lüders 的早期婆罗米文铭文列表(1912)给出了桑吉和巴尔胡特的374个俗语(Prakrit)捐献者名字,约公元前200年至公元400年。这些是捐献器物上的人名,在时间、地点和体裁上都与印度河印章接近。印度河名字的构成与它们相似:
- 两者的开放程度差不多(观察数的5.1倍对5.9倍);
- 在长度和封闭程度上,它们比古泰米尔语名字更接近;
- 它们都以一套复合中心语结尾。最常见的十个俗语中心语(-rakhita、-guta、-dina、-mita……)覆盖41%的名字,最常见的十个印度河中心语覆盖43%。
俗语捐献者名字也带有一个几乎普遍的词尾,即捐献套语中的属格-sa。所以,像740这样占主导的词尾,既符合泰米尔语的-aṉ,也同样符合印度-雅利安语捐献者式的套语。与之相应的达罗毗荼语检验,用的是捐献记录中的泰米尔语名字:取自 DHARMA 泰米尔语铭文英译本的1,396个名字,7世纪以后。它使证据分成两边:
- 更接近俗语捐献者名字的:复合中心语的库存(印度河43%,俗语35%,泰米尔语16%),以及最后一个成分的固定程度。
- 更接近泰米尔语名字的:名字长度(几乎相同),以及单一占主导的后缀(740见于82%的名字,泰米尔语-aṉ见于47%,最常见的俗语词干词尾见于23%)。
因此,名字结构排除了苏美尔类型,但无法在印度-雅利安语和达罗毗荼语之间作出判断。此外,泰米尔语记录比俗语列表晚得多,其中许多名字源自梵语。
随后又根据 Mahadevan 的Early Tamil Epigraphy的页面扫描件,建立了一份同时代的达罗毗荼语列表:取自泰米尔-婆罗米文洞窟铭文的104个捐献者名字,约公元前2世纪至公元4世纪。它在时期和体裁上都与俗语列表相匹配。
- 更接近俗语名字的:全部三项结构指标。最后一个成分的固定程度:印度河0.83,俗语0.90,泰米尔-婆罗米文1.45。长度。以及中心语库存:43%、35%和30%。
- 更接近泰米尔-婆罗米文名字的:占主导的后缀(82%,对比-aṉ的73%)。但这一反差部分是资料造成的,因为 Lüders 给出的俗语名字不带格词尾。
按这些指标,印度河名字看起来更像早期印度-雅利安语的捐献者名字,而不是同时代的泰米尔语名字。后来的一项对照推翻了这一点。加入了类型学上相匹配的诱饵:日语和土耳其语的人名,这两种语言具有与印度河相同的语序特征。两份南亚捐献者列表都胜过了这两个诱饵,但它们是铭文,而诱饵是名字列表。当两边的体裁都匹配时(取自 Monier-Williams 的梵语名字和桑伽姆诗人的名字,对比同样的日语和土耳其语列表),日语最接近印度河名字,在数据的两半中都是如此。早先的偏向是体裁造成的,而不是语言。这类名字结构统计无法选出一种语言。
世界类型学能缩小范围,但也仅此而已。对照 WALS 和 Grambank 数据库检验印度河的语序特征,可以排除世界上81%的语言属(Grambank 语系的68%)。达罗毗荼语、印度-雅利安语、蒙达语、布鲁夏斯基语、突厥语、蒙古语、日语和朝鲜语全都还在。唯一的类别信号(以鱼为中心语的名字取520,而以人、工具和植物为中心语的名字取740),在摩亨佐-达罗、哈拉帕和其他遗址都成立,早期和晚期都一样。它既符合达罗毗荼语的“人/非人”区分,也同样符合梵语的性别解读,因为星名大多是阴性的。
12 对照奖金要求:一张评分表
2025年1月,泰米尔纳德邦政府悬赏一百万美元,奖励能“令考古专家满意地”解读这种文字的人。此后没有公布进一步的规则。这里的工作按照这样一个评审组可能需要的条件来打分,按权重排序(targets/indus/PROGRESS.md, prizebench.py):
- 经过核实的意义:被读出意义、并由外部证据(同一件器物上的图画、其用途、其出土地点)证实的符号。目前:占符号记号的0.008%,即铜板上的图画符号。数字(16.6%)另计。离读出只差一步的,有十一段完整文本,其所指由图画确定。每一段都写在三块或更多块逐一制作、带有同一幅图画的铜板或刻划板上:野兔、弓箭手、大象、山羊、长吻鳄、一条鱼、公牛和“环”(对照打乱的图画,p = 0.001)。有十五个双符号短语,在确实不同的文本之间、在逐一制作的刻板上以及在不同的模制图案之间,都通过了同样的检验,其中包括带叶形符号的树短语806 158。同一文本的不完整转录在计数前已经合并。这些文本和短语合计占符号记号的0.76%,它们为一个场景贴上了标签,但并没有被读出来。不过它们是局部的标签:一个在刻划板上与某幅图画相伴的短语,并不能预测模制板上的图画,反之亦然(40个中1个)。这一方法先在线形文字B上做过检验,在那里由表意符号充当图画的角色。它挑出了143个与某个表意符号相伴的词,随机预期只有2个,并复原了已知的配对,例如 a-mo-ta“车轮”与车轮表意符号。在印章上,除了默认的独角公牛之外,这一方法对任何动物都一无所获,所以印章文本并不命名其动物。图画还从另一个方向检验了语法。在此前任何检验都没有用过的模制板上,含有词尾、标记或数字的符号对,所搭配的不同图画远多于由两个实义符号组成的符号对(每次出现0.45幅不同图画,对比0.28幅,p = 0.001)。被语法认定为语法成分的符号,本身并不带有所指。
- 阳性对照:方法必须首先复原一个已知答案,即从线形文字B得出希腊语。六种方法中有三种通过:一种音值替换检验、第8节的字符模型密钥打分器,以及图画所指方法。词典得分和自由拟合密钥都失败了。
- 未见过的文本:音值先固定下来,再拿到从未用于设定它们的文本上去试,就像 Ventris 的音值在他解读之后发现的皮洛斯泥板上所经受的检验。目前:没有,因为没有任何音值通过检验。
- 辅助性的:考古上的一致性、对照同体裁诱饵的语言检验,以及预测任务。一个被隐藏的符号,有40%的时候第一猜就猜中,62%的时候落在前五名之内(仅凭频率为9.6%和22%)。提升来自按字形家族读取符号,以及折扣平滑。(以该行的起首符号为条件而带来的一项表面提升其实是信息泄漏,因为第一个符号是由它自己预测的,已经撤回。)这里的字形家族是指笼形、罐或 U 形内部的笔画、鱼身上的记号。无论家族是取自 ICIT 的编号,还是取自 Parpola 本人的符号描述,效果都成立,而从上下文学到的类别则完全没有这种效果。在此基础上校准得更好的模型,能降低每符号的比特数,但并不能提高第一猜的命中率。
为了提高第一层和第三层而做的尝试,得出了两个发现。铜板图画对应的是从模具重复压制的完整文本,而不是单个符号:在一半铜板上确定的图画意义,只能预测38块未见铜板中的1块。共有的双符号短语带有一种微弱的倾向(每次留出一段文本,命中率17%,p = 0.05),主要是大象短语706 33 923 740和树短语806 158。泰米尔纳德邦的刻划记号(Rajan 和 Sivanantham 2026,第 II 卷)用一种不需要符号等式的检验与印度河行作了比较。两个刻划元素一起出现时,它们有70.5%的时候保持同样的顺序,而印度河符号为88.0%,这个数字在 Keeladi 和 Thulukarpatti 都一样。就记录所见,刻划组合的有序程度低于印度河文字。
同样的循环还带来了两项结构上的补充。紧挨在计数之前的槽位,在两套语料中都由一个受限的集合来填充,即计数的标签:它最常见的十个符号在该槽位中分别占52%和58%,而在打乱的行中要少得多,其中部分是起首符,但不仅仅是起首符。而且,加入这条规则的语法,对未见过的行的解析优于打乱的行,差距略有扩大。
最有力的辅助性结果是一致性。在一处地点的行上拟合语法(包括其学习得到的部分),在另一处地点上打分,以相对于打乱行的差距来衡量:
- 在摩亨佐-达罗学习得到的语法,解析哈拉帕的行几乎与解析本地的行一样好(43.8分对44.8分),反过来也成立。
- 在两座城市上学习得到的语法,能解析较小的遗址(36.1)。
- 在印章上学习得到的语法,能解析刻板(43.6)。
- 在哈拉帕晚期学习得到的语法,能解析早期地层(27.0)。
字形手段、计数标签槽位以及“鱼/520”类别信号,在每座城市中、在印章和刻板上都表现一致。带笼形的符号从不取740或520,带笔画的罐几乎从不位于行末。一套语法体系通行于整个印度河世界,所以任何读法都必须处处与之相符。由于名字中没有前缀,要求该语言没有前缀,也进一步缩小了类型范围:WALS 语言属的85%和 Grambank 语系的77%被排除。
按这张评分表,什么才能赢得奖金:为大约七十个常见符号给出音值,把大多数记号读成同一种语言中合乎语法的短语。其意义必须与几种外部证据相符。方法必须通过线形文字B对照,必须能读出从未用于设定音值的文本,并且能由并非其构建者的专家复现。目前的工作提供了这样一项主张必须符合的语法和必须通过的检验。它没有提供任何读法。
13 仍未解决的部分
- 没有任何符号具有证据所迫使的音值,语言也没有确定。除上述结构之外,内部检验已经走到尽头。最后几轮大多得出零结果和更正。剩下的需要新材料:一份双语铭文、新出土的带铭文器物,或者 CISI 第2卷和第3卷的数字化版本。(完整的 ICIT 数据库这里已经在用:导出包含全部5,680条记录;分析使用其中3,681件干净的文本,把残损文本放在一边。)
- 铜板上的七个“符号 = 图像”等式(749、341、753、777、透镜形符号)是最可靠的意义。任何语言的读法都必须与之相符。
- 一个印度河名字是否把人名和官职或世系压缩在一个单位中,就像美索不达米亚铭文把它们分散在几行中那样,这仍是未解决的问题(见第14节)。
14 途中撤回的结论
先登记预测,意味着本项目自己的一些读法被后来的检验推翻了。它们保留在记录中,并列于此:
- 一份表音符号候选名单(46个与相邻符号自由组合的符号,就像线形文字B的表音符号)在全部三项登记检验中都失败了。与之相关的发现,即罕见名字使用更自由的符号,在线形文字B中也出现了,所以这是罕见词的普遍效应。
- “两套数字系统”(早期的一种解读)变成了一套具有几种笔画形式的数字系统。在哈拉帕的刻板上,长笔画与计量符号700搭配。
- “官职 + 名字”。一种在类似称号的第一个符号与类似人名的名字其余部分之间的对比,结果发现是在拿单个符号与多符号单位作比较。单个符号几乎按定义就是一个封闭集合。控制了长度之后,只剩下第一个符号与印章动物之间的一种微弱联系。
- “数字复合词是地方性的命名习俗”。线形文字B的计数结果同样具有地方性,所以这一条被撤回,改为“具有地方性,计数本来就是如此”。
- “摩亨佐-达罗向哈拉帕趋同”。这一条被更正为名字开头方式的局部变化(第10节)。
- “印度河名字是人名”。这一条经乌尔第三王朝对照被收窄为“各自独立的组合”(第9节)。
- “印度河名字结构更接近印度-雅利安语”。体裁匹配之后,一份日语诱饵列表更为接近。这种偏向来自资料都是铭文(第11节)。
- “共有短语能预测刻板上的图画”(在一种划分上 p = 0.001)。第三种划分失败了,每次留出一段文本则只得到 p = 0.05。那只是一种有利的划分(第12节)。
15 来源
- A. Parpola,“Study of the Indus Script”,Transactions of the International Conference of Eastern Studies 50(2005),28–66,harappa.com;Deciphering the Indus Script(剑桥,1994)。
- J. P. Joshi 和 A. Parpola,Corpus of Indus Seals and Inscriptions 1(赫尔辛基,1987);其开放数字化版本,mayig/indus-valley-script-corpus(MIT)。
- indus-website 项目源自 ICIT 的语料(github.com/yajnadevam/indus-website);A. Fuls,Corpus of Indus Inscriptions(柏林,2022)和A Catalog of Indus Signs(柏林,2023);A. Fuls,“Comparison of Linear Elamite and Indus Writing Systems”,Iranian Journal of Archaeological Studies 14.1(2024),3–16。
- I. Mahadevan,The Indus Script: Texts, Concordance and Tables(1977),机器可读版本见 github.com/joyboseroy/indus_decipher;I. Mahadevan,Dravidian Proof of the Indus Script via the Rig Veda: A Case Study(Bulletin of the Indus Research Centre 4,2014)。
- 语言参照:H. Lüders,A List of Brahmi Inscriptions(Epigraphia Indica X 附录,1912;Internet Archive);DHARMA,Early Inscriptions of Āndhradeśa及泰米尔语语料(erc-dharma tfa-*,CC BY 4.0);维基百科,List of Sangam poets;Monier-Williams;I. Mahadevan,Early Tamil Epigraphy(Harvard Oriental Series 62,2003),附录 II,取自 Internet Archive 扫描件。
- 对照:DAMOS,Database of Mycenaean at Oslo(线形文字B),配合 Tiripode 词典;ORACC epsd2/admin/ur3(乌尔第三王朝印章铭文,CC0);Monier-Williams(Cologne Digital Sanskrit Lexicon);ePSD2;CLICS4;L. L. Merriam 和 A. Fuls,The Dravidian Database(Zenodo,2026)。
- 类型学与诱饵:M. S. Dryer 和 M. Haspelmath(编),WALS Online(2013),以及 H. Skirgård 等,Grambank(2023),均为 CLDF 发行版,CC BY 4.0;JMnedict(EDRDG,CC BY-SA 4.0);土耳其语人名计数(github.com/eoner/turkce_isimler)。
- 奖金与刻划记号:2025年1月5日的公告(据Archaeology Magazine报道);K. Rajan 和 R. Sivanantham,Indus Signs and Graffiti Marks of Tamil Nadu: A Morphological Study(2025)和Inscribed Potsherds of Tamil Nadu: Graffiti and Tamiḻi,第 II 卷(2026),泰米尔纳德邦政府考古局,取自Tamil Digital Library。
脚本、登记的假设(PREDICTIONS.md)、每一组的结果(results/)以及工作笔记(NOTES.md)都在仓库文件夹 targets/indus/ 中。