한눈에 보기언어는 풀리지 않음 · 언어 없이도 토큰의 41.8%가 뜻이 통함
- 텍스트
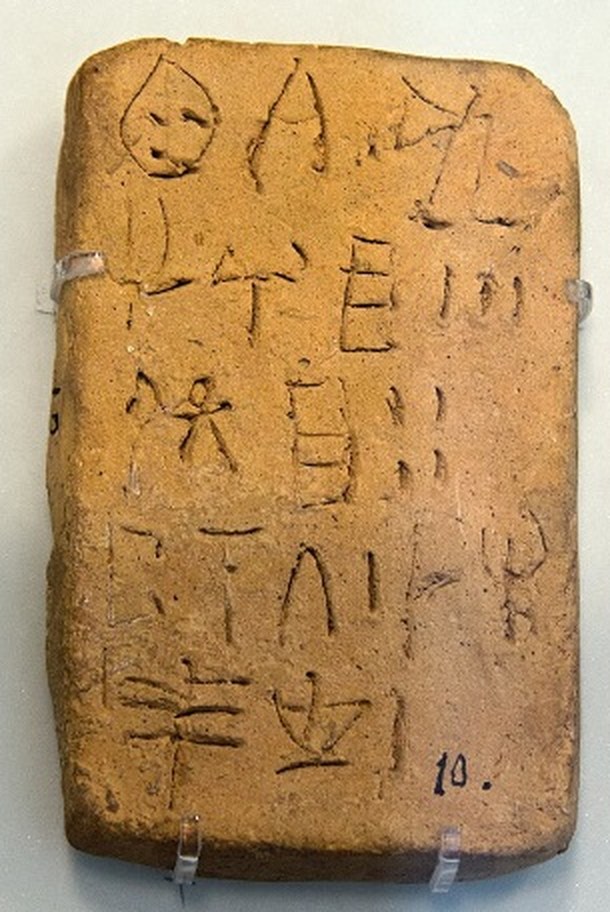
- 크레타와 에게해에서 나온 미노아 명문 약 1,400점, 기원전 1800–1450년경. 회계 서판, 봉인, 그리고 돌 그릇에 새긴 봉헌물이다. 작업 자료는 기록 1,722건이다.
- 소장처
- 대부분 Heraklion Archaeological Museum에 있다. GORILA(Godart와 Olivier 1976–85)에 편집되어 있다. 여기서 쓴 디지털 텍스트는 Robert Hogan의 lineara.xyz와 SigLA 데이터베이스다.
- 문자
- 약 90개의 음절 기호로, 선형 문자 B의 조상이며, 여기에 물품을 나타내는 표어문자, 숫자, 분수 기호가 더해진다. 알려지지 않은 언어를 적는다. 암호가 아니다. 아무도 무언가를 숨기고 있지 않았다.
- 작업 방식
- 선형 문자 B의 음가가 이어지는지를 무작위 귀무 모델과 비교해 시험했다. 그다음 모든 토큰에 기능을 부여하고, 합계 35개를 모두 분수까지 포함해 다시 확인했으며, 헌주 정형구를 유적지 간에 정렬했다.
- 내용
- 사람, 곡물, 포도주, 기름, 올리브, 무화과를 이름과 장소별로 기록하고 합계와 부족분을 적은 목록이다. 세 장소가 확인된다. 파이스토스, Sybrita, Setoija이다. 봉헌 용기에 새긴 정형화된 헌사 문구도 있다.
- 새로운 점
- 세 가지 발견이며, 09절에서 자세히 다룬다. 서판 HT 34는 두 분수 기호에 대해 발표된 값과 모순된다. 제안된 셈어계·루위어 친척 언어들은 하와이어나 요루바어보다 선형 문자 A와 더 잘 맞지 않는다. 선형 문자 B에 다시 나타나는 선형 문자 A 단어들은 이름이며, 모두 크노소스에서 나온다.
- 가장 그럴듯한 추정
- 한 지역 중심지의 실무 회계 기록이다. 이름이 붙은 사람과 작업조로부터 거두어들이고 그들에게 내어준 주요 물자를 기록하고, 부족분을 추적했다(06절, 해석).
- 미해결
- 언어 자체, 그리고 새로 발견되었으나 아직 전사가 출판되지 않은 크노소스 홀(笏). 숫자, 물품, 합계, 지명이 아닌 모든 단어의 의미로, 이는 토큰의 40.5%에 해당한다. 미확인 기호들, 그리고 분수 기호 H와 A.
01 선형 문자 A란 무엇이며, 그것을 읽는다는 것은 무엇을 뜻할 수 있는가
선형 문자 A는 미노스 문명 크레타의 문자였다. 미케네 그리스인들은 이를 변형해 선형 문자 B를 만들었고, Michael Ventris가 1952년에 선형 문자 B를 해독했다. 그것이 가능했던 것은 선형 문자 B가 이미 알려진 언어인 그리스어를 적은 것으로 밝혀졌기 때문이다. 선형 문자 A는 기호 대부분을 선형 문자 B와 공유하므로 음가를 그대로 옮겨 올 수 있다. 그 결과 소리 내어 읽을 수는 있지만 번역은 되지 않는다. 그 뒤에 있는 언어에는 알려진 친척 언어가 없고, 같은 단어를 알려진 언어로 함께 적은 텍스트도 없다.
따라서 이것은 암호 문제가 아니며, 이 프로젝트가 평소 완전한 결과의 척도로 삼는 기준(텍스트의 95%가 의미를 이룸)은 어떤 방법으로도 도달할 수 없다. 할 수 있는 일은 더 좁지만, 검증할 수 있다.
- 옮겨 온 음가가 실제로 맞는지 검증한다.
- 의미가 언어에 의존하지 않는 것, 즉 숫자, 분수, 물품 그림문자, 회계 용어를 모두 읽는다.
- 산술을 확인한다.
- 남은 것의 구조를 기술한다.
이 페이지는 전체 코퍼스에 대해 이 네 단계를 수행한 결과를 각각의 척도와 함께 보고한다.
02 음가는 그대로 옮겨지며, 미노스 이름들은 크노소스에 살아남아 있다
만약 선형 문자 B의 값이 선형 문자 A에 붙인 임의의 꼬리표에 불과하다면, 선형 문자 A 단어가 선형 문자 B 단어와 일치하는 것은 우연일 뿐일 것이다. 검증은 기호 세 개 이상으로 된 선형 문자 A 단어 유형 491개 전부를 가져와, 지명을 포함해 그리스어 동족어가 있는 선형 문자 B 단어 919개(NeuroDecipher 목록, Luo et al. 2019)와 비교한다. 정확한 일치 건수를 센다. 이어서 빈도가 비슷한 선형 문자 A 기호들 사이에서 값을 2,000번 뒤섞고 일치 건수를 다시 센다.
| 선형 문자 A | 선형 문자 B / 그리스어 | 선형 문자 A의 출처 |
|---|---|---|
| PA-I-TO | pa-i-to, 파이스토스 | HT 97a, HT 120 |
| SU-KI-RI-TA | su-ki-ri-ta, Sybrita | PH Wa 32 |
| SE-TO-I-JA | se-to-i-ja, Setoija | PR Za 1 |
| A-RU-RA | ἄρουρα, 경작지(?) | HT 11a |
| I-JA-TE | i-ja-te, 의사(?) | PH Zb 4 |
| DA-MA-TE | da-ma-te, 데메테르(?) | KY Za 2 |
실제 일치는 6건이고 무작위 평균은 0.49건이다. 2,000번의 뒤섞기 중 6건에 이른 것은 단 한 번뿐이었다(p ≈ 0.001). 음가는 그대로 옮겨진다. 어간은 같고 마지막 기호만 다른 단어까지로 검증을 느슨하게 하면, 기댓값 25.4건에 대해 35건이 일치한다(p 0.09). 즉 아무것도 아니다. 6건 중 3건은 크레타의 지명으로, 어떤 언어라도 공유했을 것이다. 491개 중 일반 단어는 3개만 일치하므로 선형 문자 A는 그리스어가 아니며, 이는 통설과 같다.
자음 행은 실재한다. 음가에 대한 두 번째 검증은 알려진 단어를 전혀 필요로 하지 않는다. 선형 문자 B가 같은 자음 행에 넣는 기호들(NA, NE, NI, NU; RA, RE, RI, RO, RU)은 선형 문자 A 단어 안에서 서로 다른 행의 기호들보다 더 비슷한 주변 기호와 함께 나타나며(p = 0.0005), 그 효과는 선형 문자 B 자체에서만큼 크다. 이는 자음 조화와 어두 모음을 비교에서 빼도, 하기아 트리아다와 다른 유적지를 따로 보아도 유지된다. Q, N, R 행이 가장 뚜렷하게 결속된다. 결속되지 않는 유일한 행은 Z(ZA, ZU)인데, 이는 선형 문자 B에서도 가장 불확실한 계열이므로 미노스어 음가가 다를 가능성이 가장 큰 곳이 바로 여기다. 같은 방법으로 숨긴 기호의 모음은 문맥에서 복원되지만(우연 20%에 대해 42%) 자음은 복원되지 않으므로, 아직 판독되지 않은 기호에 값을 부여할 수는 없다. 선형 문자 B에서 자음의 27%를 복원하는 최근접 이웃 방법은 선형 문자 A에서는 우연 수준에 그친다. 행 신호는 평균적으로는 실재하지만, 이 코퍼스에서는 개별 기호의 위치를 정하기에는 너무 약하다.
모음에 관한 단서. 선형 문자 B에서는 한 행의 e 기호와 i 기호(TE와 TI, KE와 KI)가 문맥상 서로 뚜렷이 다르며, o 기호와 u 기호도 그렇다. 선형 문자 A에서는 반대쪽으로 기울며, 두 문자 사이의 차이는 뚜렷하다(e/i는 p = 0.003, o/u는 0.014). 이는 e와 o가 주변적이었던 미노스어 모음 체계와 맞으며, o 기호가 드물다는 사실도 이미 그것을 시사한다. 이는 탐색적 비교이며, 선형 문자 B의 대비 중 일부는 그리스어 격어미에서 비롯된다. 이후 새로운 데이터로 한 검증에서는 모음들이 서로 바꿔 쓰인 것이 아니라 드물었던 것으로 나타났다(이름 절 참조).
크노소스의 미노스 이름들. 선형 문자 B 어휘 전체를 대상으로 한 같은 검증에는 linearb.xyz 코퍼스의 단어 유형 4,164개를 쓰며, 각각에는 Chadwick과 Ventris의 용어집에 따른 범주가 붙어 있다. 기댓값 2.8건에 대해 13건이 일치하며(p 0.0005), 이들은 종류별로 깔끔하게 나뉜다.
- 이름들, 모두 크레타에서. 선형 문자 B의 이름과 일치하는 선형 문자 A 단어는 모두 크레타의 크노소스에서만 확인되는 단어이다. 지명은 PA-I-TO, SU-KI-RI-TA, SE-TO-I-JA이다. 인명은 DA-I-PI-TA(자크로스), I-TA-JA(HT 28a), KI-DA-RO(HT 47a, HT 117a)이다. 선형 문자 B 이름의 절반(51.3%)이 크레타에서만 나오므로, 우연으로 6개 중 6개가 될 확률은 p = 0.018이다.
- 크노소스 단어 두 개가 더 선형 문자 A 목록에서 이름처럼 쓰인다. TA-NA-TI는 위에 보인 남자들의 목록 HT 7a를 포함해 네 서판에 나오고, PA-RA-NE는 HT 115에 나온다.
- 일반 단어들, 본토에서. 본토에서만 발견되는 선형 문자 B 단어들은 필로스의 그리스어 일반 단어로, ma-te-re “어머니”, i-ja-te “의사” 같은 것이다. 이들은 07절에서 측정하는 종류의 우연한 닮은꼴이다.
선형 문자 B 기록에 살아남은 미노스어 어휘는 이름이며, 그것도 크노소스에만 있다. 오슬로의 데이터베이스 DAMOS를 독립적으로 조회해도 같은 결과가 나온다. 13건 중 12건이 일치하고, 크노소스와 본토 사이의 구분도 같다. 또한 두 문자에서 이름들이 같은 역할, 즉 개인 목록의 항목 역할을 한다는 것도 보여 준다. TA-NA-TI는 HT 7a 남자 목록에서 1과 함께 나오고, 크노소스에서는 “ta-na-ti, DA 1”(KN Uf 311)로 나온다. 마찬가지로 I-TA-JA는 여성 한 명을 뜻하는 “i-ta-ja MUL 1”(KN Ap 769)로, PA-RA-NE는 “pa-ra-ne 1”(KN Vc 7616)로 나온다. 한 가지 주의할 점이 있다. SigLA는 파이스토스 도편 PH Wa 32를 SU-KI-RI-TA가 아니라 SU-KI-RA-TA로 읽으므로, Sybrita 일치는 GORILA의 기호 하나 판독에 달려 있다.
정확한 일치를 넘어서. 크노소스 인명 전체가 형태상 미노스적이다. 음절 단위로 비교하면, 크노소스에서만 확인되는 선형 문자 B 인명 637개는 필로스에서만 확인되는 339개보다 선형 문자 A 목록 이름 358개에 훨씬 가깝다(전체, 첫음절, 끝음절 모두 p = 0.0002). 이 결과는 정확히 공유되는 이름을 빼도, 하기아 트리아다, 자크로스, 하니아의 선형 문자 A 이름을 따로 보아도 유지된다. 일반 어휘에서는 크노소스와 필로스 사이에 이런 차이가 없으므로, 이는 이름의 특징이지 크노소스식 철자의 특징이 아니다. 이름이 가장 미노스적인 형태를 띤 크노소스 서기들은 합의된 값이 없는 선형 문자 B 기호도 가장 많이 쓴다(서기 23명에 걸쳐 rho = 0.48). 두 번째 징후도 같은 방향을 가리킨다. 선형 문자 A는 o 음절을 매우 적게 쓰며(3% 미만), 단어 내부에서 크노소스 이름은 필로스 이름보다 o 음절을 덜 쓴다(12% 대 17%). e도 마찬가지다. 선형 문자 A는 e 음절을 적게 쓰고(10%), 크노소스 이름은 필로스 이름보다 덜 쓰며(16% 대 26%, p = 0.0005), 일반 어휘에는 이런 격차가 없다. 크노소스의 미노스 이름들은 선형 문자 A의 두 가지 모음 부족을 모두 지니며, 크레타의 지명들도 그렇다. 그리스어 어미를 떼어 내면 크노소스에서만 확인되는 지명은 음절의 21%에서 e나 o를 쓰는 반면 필로스는 42%이다(p = 0.0005). 선형 문자 A 자체에서 e와 o는 주로 어미에 놓이며(NE, ME, TE는 세 번 중 두 번 어말에 온다), 마치 미노스어가 이들을 주로 접미사에 쓴 것처럼 보인다. 이들은 자음에도 좌우된다. e와 o는 P나 J보다 Q, R, T, S 뒤에 훨씬 자주 오며, W나 Z 뒤에는 결코 오지 않는다. 이 의존성은 선형 문자 B보다 네 배 강하다. 모아서 보면, 설정 자음(T, D, N, R, S, Z) 뒤에는 음절의 22.5%에서 e나 o가 오고, 나머지 자음 뒤에는 12.4%에서 오며, 이는 단어 내부에서도 그렇다. 이 규칙은 e만 따로 보아도, 하기아 트리아다 밖에서도, 목록 이름에서도 성립하며, 중요한 것은 다음 음절이 아니라 같은 음절의 자음이다. 가장 강한 기호(RE)를 빼도 살아남고, 한 번만 쓰인 단어와 첫음절에서도 성립하므로, 몇몇 단어나 어미의 문제가 아니다. 다만 자음별로 보면 “치음”보다 범위가 좁다. e와 o는 Q 뒤(절반), R 뒤(37%), T 뒤(28%)에서 가장 흔하고, 그다음이 S와 N이며, D는 낮게 머물고 W와 Z는 결코 이들을 취하지 않는다. 실제로 미노스어의 e와 o는 주로 R과 T 뒤에 서며, 다른 음절이라면 i와 u가 올 자리이다. R과 T 뒤에서 선형 문자 A는 음절을 다섯 모음 모두에 걸쳐 분포시킨다. 다른 자음 뒤에서는 세 모음(a, i, u)에 가까운 더 좁은 집합을 쓴다. 선형 문자 B에는 이런 차이가 없다. 자음별로 T, R, S, N과 순연구개음 Q는 e와 o를 취하고, K, P, M, J, W는 이를 피한다. 선형 문자 A가 적는 미노스어 단어는 또한 단순한 자음-모음 음절의 연쇄였다. 모음 기호 두 개가 나란히 서는 일이 없고, 순수 모음 기호로 끝나는 단어는 적으며(4%, 선형 문자 B는 10%), QA, QE, QI는 어두에 온다(57–62%, 선형 문자 B는 28%). 이웃한 음절은 같은 자음을 공유하는 경향도 있어(TA-TI, KU-KA) 선형 문자 B보다 그 정도가 크며, 이는 모든 유적지와 목록 이름에서 그렇다. 이 모든 것이 두 전사본 모두에서 성립하며, Q와 어말 모음의 습관은 크노소스 이름에서도 다시 나타난다. 모음 패턴은 SigLA의 전사에서도 재현되고 자크로스에서도 성립하지만, 기호와 합자에서도 따로 노는 하니아에서는 성립하지 않는다. 이 규칙은 서판뿐 아니라 종교적 헌사에서도 성립한다. 단어가 충분한 모든 유적지(하기아 트리아다, 하니아, 크노소스, Palaikastro, 파이스토스, 자크로스)에서, 그리고 lineara.xyz뿐 아니라 SigLA의 독립적 전사에서도 성립하며, 자음 행도 마찬가지다. 그리스 서기들이 -u로 끝나는 미노스 이름을 -os로 바꾸었다는 단서(DI-DE-RU와 di-de-ro)는 따로 검증하자 유지되지 않았다. -u로 끝나는 선형 문자 A 단어가 -o로 끝나는 크노소스 이름과 맞는 빈도는 -a로 끝나는 단어보다 높지 않다. 종교적 단어는 행정 단어보다 두 배 자주 -TE로 끝난다(A-DI-KI-TE, I-DA-MA-TE, 산 이름 딕테와 이다). 선형 문자 A를 넘어서 보면, 그리스어의 선그리스어 기층 단어들도 같은 윤곽을 공유하여 어간에 e와 o가 일반 그리스어 단어보다 적고(p = 0.0005), 에테오크레타어에도 o가 적다. 그러나 선그리스어 단어들은 설정음 패턴이나 선형 문자 A의 자음 윤곽은 공유하지 않으므로, 유사성은 모음 부족에만 있다. 다만 e와 o의 부족은 세계 언어들 사이에서 흔하므로, 이는 미노스어를 기술할 뿐 그 어족을 밝혀 주지는 않는다. 그러나 철자에서 e를 i로, o를 u로 바꾸는 일이 우연보다 많지는 않으므로, 증거가 말하는 것은 미노스어의 e와 o가 i와 u에 합쳐졌다는 것이 아니라 드물었다는 것이다.
이 모음 규칙은 얼마나 특이한가. 이 규칙을 유라시아 언어 104개(NorthEuraLex, Dellert et al. 2020)와 비교했다. 각 언어는 선형 문자 B가 그리스어에 쓰는 규칙으로 다시 철자화했다. 자음은 선형 문자 A의 행으로 합치고, 자음군은 쪼개고, 어말 자음은 탈락시켰다. 104개 중 어느 언어도 e와 o를 앞 자음에 선형 문자 A만큼 강하게 묶지 않는다(T, R, S, N, Q 대 K, P, M, J, W의 로그 오즈 1.22). 가장 가까운 것은 캅카스의 언어인 라크어(0.99)이며, R과 T만 세면 라크어가 선형 문자 A를 넘어선다. 이 결과는 모든 언어를 선형 문자 A의 표본 크기로 줄여도, 두 번째 철자 규칙을 적용해도 유지된다. 따라서 이 규칙은 극단적이지만 자연 언어에서 발견되는 것이며, 서기의 습관일 필요는 없다. 선형 문자 B의 그리스어 철자로는 이런 규칙이 생기지 않는다. 이 비교는 어떤 어족이나 지역도 가리키지 않는다. 선형 문자 A와 가장 가까운 윤곽들은 흩어져 있고(라크어, 에스토니아어, 만시어, 에벤키어, 만주어), 가까움은 크레타로부터의 거리와 무관하다. 방법은 거칠다. 그리스어의 선형 문자 B 철자를 주면 현대 그리스어를 104개 중 5위에 놓을 뿐이다.
흔적은 이름에 그치지 않는다. 크노소스의 선형 문자 B는 전체적으로 필로스보다 선형 문자 A에 가까운 비율로 음절을 쓴다. 합의된 값이 없는 선형 문자 B 기호(*18, *47, *56 등)를 포함한 단어는 크노소스에서 약 세 배 흔하다. 이름뿐 아니라 선형 문자 A의 종교적 단어도 필로스 이름보다 크노소스 이름을 더 닮았으며, 헌주 문구 단어를 빼도 여전히 그렇다. 이들 각각은 50개 가설을 함께 검정한 데 대한 보정을 거쳐도 살아남는다. 이름 결과는 표본 밖에서도 예측력을 보인다. 크노소스 이름을 한 번도 보지 못한 모델을, 학습에 쓰지 않은 필로스 이름에 대해 검정해도 여전히 크노소스 이름을 더 미노스적인 쪽으로 골라내며(AUC 0.59, p = 0.0025), 두 유적지의 일반 단어는 구분하지 않는다. 이는 선형 문자 A 단어의 출처에 좌우되지 않는다. 하기아 트리아다 이외 유적지의 이름만으로 학습한 모델도 똑같이 잘하고(AUC 0.61), 이름 없이 종교적 단어만으로 학습한 모델도 마찬가지다(AUC 0.60). 합의된 값이 없는 기호로 철자된 단어들은 다른 음절에서도 미노스적 형태를 띤다.
대비는 필로스와만의 것이 아니다. 어미를 뗀 어간으로, 필로스 이름을 한 번도 보지 못한 모델로 점수를 매기면, 크노소스 이름은 테베, 미케네, 티린스의 이름 46개보다도 더 미노스적이며(AUC 0.63, p = 0.0025), 크노소스에서만 나오는 이름은 본토에서도 발견되는 크노소스 이름보다 더 미노스적이다. 한계가 하나 있다. 가장 이른 크노소스 기록군인 전차 서판실(Room of Chariot Tablets)은 후대 퇴적층보다 미노스 이름이 더 많지 않으며, 굳이 말하자면 더 적다.
크노소스의 많은 단어는 미노스어 어간에 그리스어 어미를 붙인 것처럼 보인다. 크노소스에서만 나오는 단어가 선형 문자 A 단어에 음절 하나를 더한 형태인 경우는 필로스 단어보다 두 배 이상 많다(7.8% 대 3.4%). 인명에서 덧붙은 음절은 전형적인 그리스어 어미로, 선형 문자 A의 A-DA-RA에 대한 a-da-ra-ro가 그 예이다. 미노스적 신호는 어미가 아니라 이 어간에 있다. 실제로 크노소스 이름은 필로스 이름보다 -o로 더 자주 끝난다. 두 가지 주의점이 있다. 이 어간들은 일반적인 선형 문자 A 단어이지, 특별히 선형 문자 A 이름인 것은 아니다. 테베, 미케네, 티린스와 비교하면 크노소스의 초과분은 작고 유의하지 않으므로(7.8% 대 6.4%), 대비의 일부는 필로스가 낮은 데서 온다.
03 장부 읽기
스크립트(targets/lineara/reading/build_reading.py)가 구분자와 손상 표시를 제외한 코퍼스의 토큰 5,339개 각각에 하나의 범주를 부여한다. 주석은 근거가 명시된 것만 남긴다.
- 물품 그림문자: GORILA의 표지(곡물, 포도주, 기름, 올리브, 무화과, 남자, 염소, 방동사니). 선형 문자 B에서 같은 기호가 지니는 의미에 근거한다.
- 분수 값: Corazza et al. 2021. 단, 04절에서 이의를 제기하는 두 개는 제외한다.
- KU-RO: “합계”, 여기서 검증한다.
- PO-TO-KU-RO: “총합계”.
- KI-RO: “부족분”. KU-RO가 이후 합산하는 목록의 첫머리에 온다(HT 88, 94b, 117a). HT 34에서는 뺄셈 뒤에 온다. 100 − 70 = 30.
| 등급 | 토큰 | 공유 |
|---|---|---|
| 의미로 읽힘: 숫자, 분수, 물품, KU-RO / PO-TO-KU-RO / KI-RO, 지명 세 개 | 2,232 | 41.8% |
| 소리로 읽히며 기능만 알 수 있음: 목록 항목, 표제, 문구 단어, 봉인 표시 | 2,164 | 40.5% |
| 읽히지 않음: 미확인 기호와 합자(*301, *308…), 이를 포함한 단어, 논란 중이거나 값이 없는 분수 | 943 | 17.7% |
토큰 대신 기호로 측정하면 32.1%가 의미로 읽힌다. HT 88은 이 수준의 판독이 어떤 모습인지 보여 준다.
A-DU [표제], VIR+KA [남자들] 20: RE-ZA 6, KI-KI-NA 7. KI-RO [부족분]: KU-PA3-PA3 1, KA-JU 1, KU-PA3-NU 1, PA-JA-RE 1, SA-MA-RO 1, DA-TA-RE 1. KU-RO [합계] 6.
이런 항목 66개, 즉 각각 적은 수의 남자와 함께 적힌 짧은 단어들은 인명일 가능성이 높은 것으로 표시된다. 여러 서판에 항목으로 되풀이되는 단어는 18%의 경우 같은 서기가 적었으며, 우연이라면 4%이므로, 서기들은 각자 자기 사람들이나 부문을 맡았던 것이다. 서기들은 물품과 거래 용어(SA-RA2, KA-PA, A-DU)에서도 전문화되어 있으므로, 하기아 트리아다 기록고는 필체와 주제에 따라 나뉘어 있었다. 각 서기에게는 목록 양식(목록의 길이, 합계를 덧붙이는지 여부, 한 물품 안에서의 수량 규모)도 있었고, 여러 물품을 다루는 서판은 곡물을 맨 앞에, 포도주를 맨 뒤에 두는 고정된 순서로 물품을 나열하며, 서로 다른 서기들도 같은 순서를 따른다. 무화과도 이 순서에 자리가 있다. 선형 문자 A에는 별도의 무화과 기호가 없다. 무화과를 음절 NI로 적는데, 선형 문자 B는 나중에 이 기호를 무화과 표어문자로 썼다. NI 항목은 다른 계량 물품처럼 분수를 취하고(45%, 남자는 6%), 곡물, 방동사니, 기름 뒤와 포도주 앞에 서며, 우연보다 자주 곡물과 함께 나온다. 선형 문자 B는 이 습관을 유지했다. 같은 NI 기호인 그 무화과 표어문자는 둘 다 기록한 선형 문자 B 서판 37개 모두에서 곡물 뒤에 오며, 선형 문자 A에서 NI가 분수를 취하는 것만큼 자주 하위 단위를 취한다(44% 대 45%). 선형 문자 B 역시 곡물을 맨 앞에 적고, 가장 큰 수량을 맨 앞에 두며, 물품 목록을 큰 것부터 정렬한다. 포도주를 맨 뒤에 두는 것은 선형 문자 B가 유지하지 않은 유일한 선형 문자 A 습관이다. 또 다른 차이는 표기법에 있다. 선형 문자 A 목록은 물품 기호를 첫머리에 한 번 적고 나머지는 생략된 것으로 둔다(항목의 38%가 이를 지닌다). 선형 문자 B는 물품 목록의 거의 모든 줄에서 표어문자를 되풀이한다(크노소스 82%, 필로스 86%, 실질적 차이 없음). 사람 목록에서 크노소스의 수치가 더 낮은 것은 여성과 아이 서판 때문인데, 여기서는 소녀와 소년 줄에 MUL 대신 고유한 단어가 붙는다. 또 이름 열두 개에 VIR를 한두 번만 적는, 선형 문자 A식의 긴 이름 목록 두 개(서기 102와 105) 때문이기도 하다. 선형 문자 B 서판도 곡물을 맨 앞에 두지만, 곡물 이후의 순서는 선형 문자 A의 순서와 맞지 않는다. 합계를 적는 것은 하기아 트리아다의 습관이었다. 그곳 서판의 18%가 KU-RO로 끝나는 반면, 파이스토스와 자크로스는 3%이고 다른 곳은 전혀 없다. 같은 인물들이 같은 물품의 서판에 되풀이해 나온다. 물품 기호에 붙는 음절은 지역마다 달랐다. 하기아 트리아다와 Tylissos는 한 벌의 기름 합자(OLE+U, OLE+KI, OLE+MI)를 공유하는 반면, 하니아는 OLE+TA를, 자크로스는 GRA+PA를 쓴다. Tylissos는 하기아 트리아다의 기름 합자를 공유하지만 단어는 하나도 공유하지 않으므로, 연결은 표기법상의 것이었다. 일부 미판독 기호도 지역적이며(*411, *409, *311은 하니아에서만 나온다), 같은 물품의 전형적 수량도 유적지마다 다르다. 곡물 항목은 하기아 트리아다에서 크고 하니아와 자크로스에서 작은 반면, 포도주 항목은 그 반대다. 남자의 수는 유적지 간에 다르지 않으므로, 더 그럴듯한 설명은 유적지마다 곡물과 포도주를 다른 단위로 쟀다는 것이다. 두 쌍의 서판은 항목 묶음 전체를 되풀이한다. HT 86과 HT 95, ZA 4와 ZA 15로, 두 번 작성된 목록이다. 되풀이되는 단어 세 개는 기능은 알 수 있지만 의미는 알 수 없다.
- SA-RA2: 하기아 트리아다에서만, 곡물 및 방동사니와 함께 20건의 기록에 쓰인 거래 용어.
- A-DU와 KA-PA: 표제 용어.
모든 기록의 전체 판독(reading/edition.txt, targets/lineara/reading/build_reading.py로 작성)은 공개 저장소에 없다. 그 바탕이 된 디지털 텍스트에 라이선스가 없기 때문이다. 요청하면 제공한다.
합계. KU-RO와 PO-TO-KU-RO 합계 35개 전부를 정확한 분수로 다시 확인했다. 각각에 대해 여러 범위에 걸쳐 항목을 합산했다. 서판의 처음부터, 마지막 구분선부터, KI-RO 표제 다음부터, 유물의 양면에 걸쳐, 그리고 물품별로.
- 10개는 맞아떨어진다. HT 123a의 올리브 합계는 서판의 다른 물품과 따로 올리브 항목만 합산할 때에만 맞는다. 31 + 31½ + 16 + 15 = 93½. 아래 그림은 이 서판을 재현한다.
- 나머지는 맞지 않는다. 손상 때문이거나 오래전부터 알려진 실수 때문이다. HT 9a는 ¾, HT 13은 ½, HT 94a와 HT 119는 1만큼 어긋난다. HT 122에서는 총합계가 97인데, 양면을 합하면 31 + 65 = 96이다.
- 산술적 복원. 합계는 온전하고 그 위의 목록이 손상된 경우, 빠진 수량이 도출된다. HT 11a에서 4, HT 100에서 4, HT 122a에서 9, HT 27a에서 13. 합계 5개는 어떤 범위로도 맞출 수 없으며, 이는 서판 실물만이 판정할 수 있다.
- 디지털 텍스트에 대한 정정. 디지털 텍스트는 HT 34의 KI-RO를 37로 적지만, Younger와 GORILA는 7이 지워진 30으로 적는다.
서판들 사이에서. 같은 항목 단어가 서로 다른 서판에 우연이 허용하는 것보다 훨씬 자주 되풀이된다. 기록 네 쌍이 이름을 세 개 이상 공유하며, 기댓값은 0.1이다. 세 가지 발견이 뒤따른다.
- A-KA-RU와 A-DU는 거래 범주이다. 다섯 남자(DA-ME, DI-DE-RU, KU-NI-SU, MI-NU-TE, SA-RU)가 HT 86과 HT 95에서 곡물을 받으며, 표제 A-KA-RU와 A-DU 아래로 나뉜다. HT 86a에서 그들은 각각 20을 받는다. HT 95b에서는 다섯 명 모두 A-DU 아래 각각 10으로, 정확히 절반이다. 두 단어가 같은 사람들에게 적용되므로, 둘은 사람도 장소도 아니다.
- PA3는 납부된 부분을 표시한다. HT 9는 앞면에 포도주 장부를 적고(합계 31¾) 뒷면에 PA3 아래 같은 이름들을 되풀이한다(합계 24). 뒷면에 공유된 수량은 모두 앞면의 것과 같거나 작다. 5¾ → 3, 10 → 8, 4 → 4, 2 → 2, 2½ → 2, 2½ → 2. HT 34도 같은 모양이다. 100, PA3 70, KI-RO 30. 이는 Younger의 제안을 뒷받침하며, 이제 두 서판에서 그렇다.
- KI-RO 목록은 개인을 센다. KI-RO 부분(HT 88, 94b, 117a)의 모든 이름에는 다른 곳에서 같은 이름에 무엇이 붙든 정확히 1이 붙는다. KU-PA3-NU는 HT 1에서 109를, SA-RU는 곡물 20을 지닌다.
이것들은 기능이지 번역이 아니다.
유적지 간에는 양상이 뒤집힌다. 둘 이상의 유적지에 나오는 항목 단어는 10개뿐이며, 우연이라면 33개가 기대된다(p = 0.0005). 각 기록고에는 고유한 이름들이 있다. 이동하는 몇 안 되는 단어는 대부분 행정 용어이다. A-DU는 하기아 트리아다와 Tylissos에, DA-RE는 하기아 트리아다, Palaikastro, 하니아에 나온다. 이는 DA-RE 역시 사람이 아니라 용어임을 시사한다.
04 분수 기호, 그리고 HT 34
선형 문자 A는 분수를 특수 기호로 적으며, 관례적으로 J, E, F, K, L2, B, D, H, A와 그 밖의 드문 몇 개로 부른다. 이 기호들의 값은 그 자체로 작은 암호 문제이다. 값을 깔끔하게 고정해 주는 서판은 하나뿐이다. HT 104에서 45 J + 20 J + 29 = 95이므로 J = ½이다. 가장 큰 연구인 Corazza, Ferrara, Montecchi, Tamburini, Valério(2021)는 J ½, E ¼, F ⅛, H 1/16, A 1/24, B ⅕, D ⅙, K 1/10, L2 1/20을 제안한다. 그들은 제약 탐색과 최적성으로 이 값들에 도달했다.
복합 분수는 큰 것부터 적는다. 이 프로젝트는 그 논문을 읽기 전에 코퍼스에서 한 항목 안에 있는 분수 기호 연쇄 296개를 모두 모아, 각 쌍이 적힌 순서를 기록했다. 그다음 발표된 값들을 그 쌍들에 비추어 채점했다. 예전 값(B = ⅓)은 KH 9에서 실패한다. 2021년 값은 확실한 사례 하나에서 실패한다.
- HT 34, 3행에는 2 H K로 적힌 수량이 있다. 세 자료가 이 순서에 일치한다. GORILA 도면, lineara.xyz 텍스트, SigLA이다. 큰 것부터 적는다면 H가 K보다 커야 한다. 2021년 논문은 H에 1/16 이하만 허용하며(최적해 28개가 1/16에서 1/84까지를 준다), K는 1/10이다.
- 그 체계 안에서는 H의 어떤 값으로도 해결되지 않는다. 다른 값들은 논문의 수치로 고정하고, 하나의 값에는 하나의 표기가 있다는 논문 자체의 규칙을 적용한다. H를 K 위에 놓을 유형론적으로 확인된 값은 ⅓, ⅖, 3/20, 3/10뿐인데, 각각은 이미 확인된 복합 표기(D D, B B, K L2, E L2)로 적힌다.
- 두 번째, 더 약한 긴장. Younger는 HT 34의 마지막 줄들을 앞선 항목을 정산하는 것으로 읽으며, PU F가 A로 적힌 항목을 정산한다고 본다. 그렇게 읽으면 F(⅛)는 최대 A여야 하는데, A는 1/24이다.
저자들 스스로 최적성으로는 H와 A가 정해지지 않았다고 말하며, 이 두 값은 구조적 근거로 골랐다. HT 34는 이 두 값에 대한 반례이지 대안 체계가 아니다. 순서 쌍 29개로는 체계를 세우기에 증거가 너무 빈약하다. 2021년 논문을 인용한 18편 중 어느 것도 값을 수정하지 않는다. 연구팀 자신의 후속 서술인 Corazza의 Computational methods for undeciphered scripts(2024)는 “A = 1/24?, H = 1/16?”을 여전히 잠정적이라고 표시한 채 되풀이하며, HT 34는 논하지 않는다. 온라인으로 접근할 수 있는 자료가 보여 주는 한, 이 모순은 이전에 제기된 적이 없다. Salgarella의 2025년 책은 비공개 접근이라 확인하지 못했다. 이 점을 자신 있게 새롭다고 말하기 전에 남은 것은 그 한 가지뿐이다. 각 분수 쌍에 물품을 표시해 보아도 발표된 값은 구제되지 않는다. 세 예외는 서로 다른 세 물품에 속하며, HT 34의 쌍은 코퍼스에서 H와 K를 둘 다 지닌 유일한 쌍이다.
새로운 증거가 오고 있다. 2024년 크노소스에서 발견된 상아 손잡이 KN Zg 58에는 서로 다른 분수 기호 여섯 개가 한 줄로 적혀 있다. 발굴자들은 이 순서가 발표된 모든 제안과 다르게 값을 배열한다고 말하지만(Kanta, Nakassis, Palaima, Perna 2025), 최종 간행본을 위해 이를 유보해 두고 있다. 그 순서와 HT 34 3행의 좋은 사진(이라클리온 박물관, HM 22)이 있으면 이 문제는 해결될 것이다. HT 34 논증을 정리한 두 쪽짜리 노트의 초안은 다음에 있다. targets/lineara/note_HT34/.
05 헌주 문구
크레타 각지의 산정 성소에서 나온 봉헌 용기에는 되풀이되는 단어 연쇄가 새겨져 있다. 7개 유적지의 비문 14개에 걸쳐, 그 자리들의 순서는 78쌍 중 77쌍에서 유지된다.
A-TA-I-*301-WA-JA · [장소 단어] · JA-SA-SA-RA-ME · U-NA-KA-NA-SI · I-PI-NA-MA · SI-RU-TE · TA-NA-…-U-TI-NU
유일한 역전은 IO Za 6에 있다. 변이는 JA-, A- 또는 무(無)인 접두사에 있으며, 이 접두사는 자리를 옮겨 다닌다.
- 장소 단어는 Iouktas에서는 JA-DI-KI-TU이지만 Palaikastro에서는 A-DI-KI-TE이다.
- JA-SA-SA-RA-ME는 A-SA-SA-RA-ME, SA-SA-RA-ME와 번갈아 나온다.
- PK Za 8에는 JA-SA-U-NA-KA-NA-SI가 있다.
A-DI-KI-TE는 후대 딕테의 제우스 숭배의 중심지인 Palaikastro에서 적혔다. 이는 발표된 판독 “딕테”와 맞지만, 맥락일 뿐 증명은 아니다. 자리 순서와 접두사는 보이는 한도 내에서 이 문구의 문법이다. 단어들이 무엇을 뜻하는지는 알 수 없다. JA-SA-SA-RA-ME는 보통 신의 이름으로 여겨지며, 증거가 미치는 것은 거기까지다. 이 측정은 Davis(2014) 등이 기술한 바를 확인해 준다.
06 서판이 아마도 말하는 것: 근거 있는 추측
이 페이지의 다른 모든 것은 측정된 것이다. 이 절은 해석이다. 측정된 결과가 뒷받침하는 가장 그럴듯한 그림을 제시하고, 각 부분이 무엇에 근거하는지 밝힌다. 여기서 번역되는 단어는 하나도 없다. 추측하는 것은 항목들이 무엇을 위한 것이었는가이다.
기록고는 무엇이었나. 대부분의 서판은 하기아 트리아다에서 나오며, 기원전 1450년경 건물이 불타면서 결코 구울 생각이 없었던 점토가 구워졌기 때문에 살아남았다. 굽지 않은 서판은 실무 기록으로, 현재의 회계 기간 동안 보관되었다가 문질러 지워지거나 버려졌다. 이 서판들은 아마 화재 전 마지막 몇 달을 다룰 것이다. 역사가 아니라 진행 중인 업무다. 수량은 작아서 한 단위에서 수백까지이다. 각 유적지에는 고유한 이름들이 있고(두 유적지에 나오는 항목 단어는 10개뿐이며, 우연이라면 33개가 기대된다), 각자 고유한 규모로 곡물과 포도주를 잰다. 가장 그럴듯한 배경은 크레타 전체를 관할하는 하나의 관청이 아니라, 자기 구역을 운영하는 지역 중심지이다.
들어오고 나가는 물품. 물품은 청동기 시대 에게해 경제의 주요 물자이다. 가장 많은 양의 곡물, 그다음 포도주, 기름 기호에 붙은 음절로 구분되는 여러 종류의 기름, 올리브와 무화과. 방동사니도 있는데, 선형 문자 B 기록에서 향유에 쓰는 향기로운 식물이다. 대부분의 항목은 단어 하나, 아마도 사람이나 작업조 우두머리를, 수량과 짝짓는다. 일부는 아마 피부양자와 노동자에게 준 배급일 것이다. 다른 일부는 아마 지역 가구들이 내야 할 공납일 것이다. 서판에서 주석이 붙은 단어 중 물품이 어느 방향으로 움직였는지 표시하는 것은 없으므로, 방향은 역할이 분명한 몇몇 용어에서 추론한다.
채무와 납부. 가장 분명한 용어들은 의무에 관한 것이다. KU-RO는 합계이고 KI-RO는 아직 갚지 않은 부족분이다. PA3는 아마 실제로 납부된 부분을 표시할 것이다. HT 34에서는 100이 납부 대상이었고, 70이 들어왔으며, 30이 미납이다. KI-RO는 아마 필로스의 선형 문자 B o-pe-ro, 곧 “빚진, 모자란”처럼 기능하여, 납부되지 않은 물품에도 나타나지 않은 사람에게도 쓰였을 것이다. KI-RO 부분의 모든 이름에는 다른 곳에서 같은 이름에 무엇이 붙든 정확히 1이 붙는다. 이는 작은 채무의 목록보다 결원자 목록에 더 잘 맞는다.
쉬운 말로 다시 풀어 본 두 서판. 이것들은 의역이다. 숫자와 용어 KU-RO, KI-RO, PA3는 서판에 있는 그대로이며, 사람들의 역할은 추측이다.
HT 88. 장부 A-DU: 남자, 스무 명. RE-ZA에게 여섯, KI-KI-NA에게 일곱. 부족: KU-PA3-PA3, KA-JU, KU-PA3-NU, PA-JA-RE, SA-MA-RO, DA-TA-RE, 각 한 명. 부족 합계: 여섯.
아마 노역 명부일 것이다. 스무 명의 징발 중 일부는 두 작업조 우두머리를 통해 충당되었고, 이름이 적힌 여섯 명은 빠졌거나 아직 미충당이다.
HT 9. 앞면: 각 이름마다 포도주, 모두 31¾. 뒷면, PA3 아래: 같은 이름들에 같거나 더 작은 수량, 모두 24.
아마 징수 장부일 것이다. 각 사람이 내야 했던 포도주, 그다음 각자가 실제로 납부한 양.
장부의 종류. A-DU와 A-KA-RU는 같은 다섯 남자에게 적용되며, 이들은 HT 86에서 전자 아래 각각 곡물 20을, HT 95에서 A-DU 아래 각각 10을 받는다. 정확히 절반이다. 둘은 아마 두 종류의 배급이나 의무일 것이다. 정기 지급과 특별 지급, 또는 두 차례의 분할분이나 두 계절. 하기아 트리아다에서만 곡물 및 방동사니와 함께 쓰이는 SA-RA2는 또 하나의 거래 용어이다. 이전 학자들은 이를 아카드어 šarāku “할당하다”와 비교했다. 07절의 언어 검증에서는 셈어 신호가 발견되지 않았으므로, 이 비교는 뒷받침되지 않은 채로 남는다. 이름과 달리 유적지 사이를 이동하는 DA-RE도 아마 용어일 것이다.
영수증과 꼬리표. 원반형 봉인(roundel)과 소형 봉니(nodule)에는 인장 자국과 기호 한두 개가 있다. 가장 그럴듯한 해석은 영수증과 꼬리표이다. 원반형 봉인은 인장 소유자가 입회한 단일 거래를 기록하고, 소형 봉니는 꾸러미나 썩기 쉬운 재료에 쓴 문서를 봉했다. 그 기호들은 유적지마다 다르고 서판의 단독 기호와도 다르므로, 각 중심지는 고유한 지역 영수 체계를 유지했다.
봉헌물. 석제 용기에는 헌사로 보이는 것이 새겨져 있다. 아마 “[봉헌자]가 [성소]에서 [신]에게 이것을 바쳤다”이고, 그 뒤에 칭호나 청원이 붙을 것이다. 장소 자리는 성소에 따라 바뀌고(딕테, Iouktas) 나머지는 고정되어 있는데, 이것이 정형 문구가 행동하는 방식이다. JA-SA-SA-RA-ME는 보통 신의 이름으로 여겨지며, 일부는 이를 “나의 여주인”을 뜻하는 루위어 구절과 비교했다. 여기서의 검증은 그 비교도 뒷받침하지 않는다.
전체 그림. 가장 그럴듯한 그림은 자기 구역을 위한 재분배 경제를 운영한 중간 규모의 미노스 중심지이다. 그곳은 지역 가구와 생산자로부터 곡물, 포도주, 기름을 거두어들이고, 이름이 붙은 사람과 작업조에게 물품을 내어 주었으며, 아직 받지 못한 것을 꼼꼼히 추적했다. 서기들은 부문과 물품에 따라 일을 나누었다. 그 관행은 이웃 중심지들과 달랐으며, 장부와 나란히 같은 사회가 산 위의 성소에서 공식적인 봉헌을 했다. 미케네 그리스인들이 크노소스를 차지했을 때, 그들은 이 장부 관행의 상당 부분을 유지했다. 곡물을 맨 앞에, 무화과를 곡물 뒤에, 가장 큰 수량을 맨 앞에.
추측이 가장 약한 곳. 가장 약한 지점은 물품이 어느 방향으로 움직였는가, 그리고 이름이 붙은 사람들이 누구였는가이다. 관리인, 농부, 감독, 또는 피부양자. KU-PA3-NU는 HT 1에서 무언가 109단위를 다룬 실존 인물이지만, 그것이 지급인지 채무인지 보유 재고인지는 추론이다. 2개 언어 병기 텍스트가 있으면 이 추측들을 검증할 수 있고, 선형 문자 B에서 알려진 의미로 나타나는 선형 문자 A 용어가 있어도 마찬가지다.
07 제안된 언어들을 우연과 대조해 검증하기
미노스어는 셈어, 루위어, 후르리어, 에트루리아어 비슷한 언어 등으로 불려 왔으며, 대개 닮은꼴 단어를 근거로 했다. KU-RO “합계”를 셈어 kull “모두”와 나란히 놓는 식이다. 여기서의 검증은 제안된 친척 언어가 선형 문자 A와 관련될 수 없는 언어들보다 더 잘 맞는지를 묻는다.
방법. 각 어휘집의 단어를 선형 문자 B가 단어를 적는 방식으로 철자화한다. 개음절, 어말 자음 탈락, l = r, 유성음 무시. 이 규칙들은 어떤 결과도 보기 전에 고정했으며, Knossos를 ko-no-so로, Phaistos를 pa-i-to로 바꾼다. 기호 세 개 이상의 선형 문자 A 단어 유형 491개와의 정확한 일치를 센다. 각 언어는 또한 자기 단어들에 걸쳐 자기 음절을 뒤섞은 것과 대조해 점수를 매긴다.
| 어휘집 | 종류 | 어형 수 | 일치 | 자기 음절 귀무 모형 대비 비율 |
|---|---|---|---|---|
| 루위어(Melchert 1993) | 제안됨 | 540 | 1 | 0.5 |
| 후르리어(Laroche 1980) | 제안됨 | 294 | 1 | 1.1 |
| 아카드어 | 제안됨 | 336 | 3 | 2.1 |
| 우가리트어 | 제안됨 | 288 | 4 | 3.3 |
| 에트루리아어 | 제안됨 | 27 | 0 | 단어가 너무 적음 |
| 고대 그리스어 | 제안되지 않음 | 28,606 | 27 | 2.3 |
| 하와이어, 마오리어, 요루바어 | 대조군 | 1,106 / 1,484 / 2,447 | 4 / 4 / 7 | 2.1 / 1.4 / 2.1 |
실제 단어는 관련 없는 언어에서도 뒤섞은 귀무 모형을 이긴다. 따라서 중요한 것은 제안된 어족이 대조군보다 더 큰 차이로 이기느냐이다. 그런 어족은 없다.
- 셈어: 대조군의 1.7배에 대해 2.7배, p = 0.22(네 어족에 대해 보정하면 0.86).
- 루위어: 우연 이하.
- 에트루리아어: 공개 어휘집이 너무 작아 검증할 수 없다.
- 후르리어: Laroche의 Glossaire de la langue hourrite(1980)로 검증했으며, 기댓값 0.9건에 대해 1건 일치(p = 0.6). 어휘집의 ḫ를 어떻게 철자화하든 결과는 유지된다.
개별 일치는 대조군을 옆에 놓기 전까지는 증거처럼 보인다. E-KU-RU는 아카드어 eqlum “밭”이지만, 요루바어 eguru “사암”이기도 하다. A-KA-TA는 그리스어 akantha이자 요루바어 akata “표범”이다. 산술로 의미가 정해지는 세 단어(KU-RO, KI-RO, PO-TO-KU-RO)에 대해, 어떤 후보 언어도 철자가 같고 의미가 맞는 단어를 내놓지 못하는 반면, 대조군은 의미가 틀린 닮은꼴을 내놓는다(요루바어 kuro, 하와이어 kilo).
문제는 방법 자체이다. 답이 알려진 유일한 사례인 그리스어 대 선형 문자 B에 적용하면, 그리스어 단어 1,000개당 13건이 일치한다. 같은 선형 문자 B 목록에 대해 요루바어는 1,000개당 22건이다. 후보 어휘집들의 크기에서는, 그리스어와 선형 문자 B만큼 가까운 관계라도 정확한 일치가 1건이 채 나오지 않을 것이다. 단어 모양의 일치로는 미노스어의 친척 언어를 밝힐 수 없다. 그 방법으로는 그리스어가 선형 문자 B의 언어라는 것조차 밝힐 수 없었다. 그 위에 세운 해독들은 어느 쪽으로도 증거가 되지 못한다.
에테오크레타어, 그럴듯한 후손. Praisos와 Dreros에서 나온 비문 다섯 개(기원전 7–3세기)는 그리스 문자로 비그리스어 언어를 기록하고 있으며, 흔히 미노스어의 후손으로 여겨진다. 그 소리는 알려져 있지만 대부분 단어 구분이 없으므로, 둘 다 선형 문자 B 방식으로 철자화한 뒤 텍스트 안에서 선형 문자 A 단어를 찾았다. 기호 세 개 이상의 선형 문자 A 단어는 하나도 나오지 않는다. 같은 크기의 하와이어, 마오리어, 요루바어 무작위 단어 목록은 그런 적중을 한두 건에서 세 건 낸다. 이 설계는 민감도가 거의 없다. 같은 길이의 그리스어에서 선형 문자 B 단어도 두세 번밖에 나오지 않는다. 따라서 이 결과는 미노스어와 에테오크레타어가 가깝게 동일하다는 가설을 약하게 불리하게 할 뿐이며, 먼 관계는 검증할 수 없다.
선그리스어 기층. 그리스어는 그 이전에 쓰이던 언어들에서 많은 단어를 간직했으며, Wiktionary는 그중 약 1,600개를 표시한다. 같은 길이의 일반 그리스어 단어와 비교하면, 이들은 선형 문자 A와 약간 더 자주 일치한다. 2.6건에 대해 6건이며, 그중에는 A-KA-TA 옆의 ákantha “가시 식물”, KI-DA-RO 옆의 kídalon “양파”가 있다. 공유되는 지명 하나인 파이스토스를 빼면 초과분은 사라진다(p = 0.10). 선형 문자 A 단어들은 목록 속의 인명이지 식물이나 용기가 아니다. 음절 분포로 보면 선그리스어는 일반 그리스어보다 선형 문자 A에 더 가깝지 않다.
크레타 상형문자, 더 이른 크레타 문자. 그 기호군(Younger의 어휘집, 365개 군)에 CHIC가 기호 모양에 따라 부여한 값을 주었다. 그렇게 완전히 읽을 수 있는 군은 20개뿐이며, 이들은 우연 이상으로 선형 문자 A와 일치하지 않는다(2.2건에 대해 3건). Younger의 더 완전한 값 격자는 일치를 낸다(11건에 대해 17건). 그러나 그 격자는 부분적으로 상형문자 기호군을 선형 문자 A 단어에 맞추어 만든 것이므로, 초과분은 아무것도 증명하지 않는다. 두 문자 사이의 어휘 연속성을 보이려면 기호의 값이 독립적으로 고정되어야 한다.
이 프로젝트가 할 수 있는 모든 비교를 이제 같은 규칙과 대조군 아래에서 수행했다. 제안된 네 어족, 그럴듯한 후손, 알려진 접촉 어휘. 어느 것도 언어를 밝혀 주지 않는다.
08 단어 구조
이전 단계에서 lineara.xyz 텍스트를 SigLA와 대조했다. 기호 하나가 덧붙는 차이만 있는 단어 쌍이 두 가지 무작위 모형의 예측보다 많았다(약 23과 26에 대해 42, 보정 p ≈ 0.01). PA-RA-NE / A-PA-RA-NE, DA-KU-SE-NE / DA-KU-SE-NE-TI가 그 예이다. 따라서 선형 문자 A 단어에는 순서가 있는 구조, 즉 접사나 합성어가 있다. 접두사보다 접미사를 선호하는 경향은 검증을 통과하지 못한다. A-가 표제를 표시한다는 생각은 ZA 10a에서 실패하는데, 거기서 TA-NA-TE와 A-TA-NA-TE는 둘 다 평범한 항목이다. 이것들은 미래의 어떤 해독에도 적용되는 제약이지 의미가 아니다.
Alice Kober는 한 어간이 서로 다른 문법적 자리에서 서로 다른 어미를 취하는 것을 나란히 놓아 선형 문자 B의 굴절을 찾아냈다. 여기서의 같은 검증은 어간을 공유하는 단어 무리 안에서 어미가 단어의 위치(표제, 목록 항목, 문구, 봉인)를 예측하는지 묻는다. 우연 이상으로는 예측하지 못한다(p = 0.20, 49개 무리). 어두 A-/JA-는 표제 쪽으로 기울어, A-KA-RU, A-PA-RA-NE, A-RI-JA가 항목 속 맨 형태와 대비되지만, 유의하지는 않다(p = 0.07, 12개 무리). 확인 사례가 아홉 개를 넘는 무리는 없으며, Kober의 방법은 선형 문자 A가 제공하는 것보다 어간당 훨씬 많은 사례를 필요로 한다.
09 이것이 더하는 것과 더하지 않는 것
- 발표된 분수 값에 대한 반례. HT 34는 그 체계 자체의 규칙 아래에서 H = 1/16과 A = 1/24에 모순된다. 온라인으로 접근할 수 있는 문헌 중 이를 논하는 것은 없다(04절).
- 언어 제안에 대한 보정된 검증. 셈어, 루위어, 후르리어 등은 하와이어나 요루바어보다 나을 것이 없으며, 에테오크레타어도 선그리스어 기층도 믿을 만한 연관을 보이지 않는다. 양성 대조군은 닮은꼴 맞추기로는 이 규모에서 언어를 밝힐 수 없음을 보여 준다(07절).
- 크노소스의 미노스 이름들. 선형 문자 B로 살아남은 선형 문자 A 단어는 이름이며, 우연보다 유의하게 많고, 모두 크노소스의 것이다. 그중에는 TA-NA-TI, KI-DA-RO, DA-I-PI-TA, I-TA-JA가 있다. 이를 넘어, 크노소스 인명 전체가 형태상 미노스적인 반면 필로스 이름은 그렇지 않다(02절).
- 서판 간 회계 기능. A-KA-RU와 A-DU는 같은 사람들에 걸친 범주이다. PA3는 납부된 부분을 표시하며, KI-RO 목록은 사람을 한 명씩 센다(03절).
- 디지털 텍스트에 대한 정정: HT 34의 KI-RO는 37이 아니라 30이다. 제3자의 SigLA 디코더에서 한 필드의 이름이 잘못 붙어 있었다. 그 필드는 경계 상태가 아니라 기호 위치와 단어 색인을 담고 있다. 두 디지털 판본을 단어별로 비교하여 편집자들을 위해 불일치 44건을 정리했다(
targets/lineara/ERRATA.md). 그중에는 체계적인 JA/PA3 혼동과, 여기서의 결과에 영향을 주는 SigLA의 판독 세 개가 있다. SU-KI-RA-TA, PA-RI-NE, DA-ZA. - 재현, 이제 코퍼스 전체에 걸쳐 측정됨: 선형 문자 B 음가의 이월(이전에 Packard, 그리고 Steele과 Meissner가 주장함); KU-RO, KI-RO, PO-TO-KU-RO; 지명; 이름 목록; 문구 순서. 언어를 모르고도 읽을 수 있는 코퍼스의 비율(토큰의 41.8%)은 여기서 측정한 것이며, 이에 대한 이전의 측정은 찾지 못했다. 새로운 판독은 없다.
- 언어 자체에 대해서는 아무것도 없다. 새로운 의미가 주어진 단어는 없으며, 뒷받침되는 어족도 없다.
10 남은 문제
- 소리로만 읽히는 토큰 2,164개의 의미(이름, 거래 용어, 문구 단어). 막혀 있음: 언어가 밝혀지지 않았고 2개 언어 병기 텍스트가 없다.
- 미확인 기호와 합자 632개(*301, *304, *308, QA2+…, MI+JA+…). 선형 문자 B 대응이 없고 이를 고정해 줄 맥락도 없다.
- 분수 기호 H와 A, 그리고 드문 L, W, X, Y, DD. 확인 사례가 너무 적다.
- 손상된 항목과 합계. 복원안은 다음에 제시되어 있다.
targets/lineara/reading/restorations.json. - 봉인에 있는 단일 기호 표시 631개. 유물 하나에 기호 하나, 통사 없음.
- 어떤 범위로도 맞지 않는 합계 5개: HT 13, HT 25b, HT 102, HT 122b, PH(?) 31a. 서기와 전사 중 어느 쪽이 틀렸는지는 서판을 조사해야만 알 수 있다.
- 더 완전한 에트루리아어 검증. 더 큰 공개 어휘집을 기다린다.
- Salgarella, Writing in Bronze Age Crete(2025). 비공개 접근이다. 도서관 소장본이 있으면 HT 34가 거기서 논의되는지 확인할 수 있다.
- Anetaki 홀(KN Zg 57–58), 약 119개 기호, 가장 긴 선형 문자 A 텍스트. 아직 출판된 전사가 없다(Kanta, 근간).
- HT 34 3행의 사진. 이라클리온 박물관만이 제공할 수 있다.
이것들을 넘어서는 진전에는 새로운 자료가 필요하다. 2개 언어 병기 텍스트, 또는 훨씬 더 큰 코퍼스.
11 출처
- L. Godart, J.-P. Olivier, Recueil des inscriptions en linéaire A(GORILA), 전5권, 파리 1976–85.
- R. Hogan, Linear A Explorer(lineara.xyz), 커밋 43fe7cf, J. Younger의 주석과 G. Douros의 표 포함; 그리고 Linear B Explorer(linearb.xyz), 커밋 84e0b00.
- E. Salgarella, S. Castellan, SigLA: the signs of Linear A, CC BY-NC-SA 4.0.
- M. Corazza, S. Ferrara, B. Montecchi, F. Tamburini, M. Valério, “The mathematical values of fraction signs in the Linear A script”, Journal of Archaeological Science 125(2021), 105214; M. Corazza, Computational methods for undeciphered scripts(볼로냐 2024).
- E. Salgarella, “Linear A”, Oxford Classical Dictionary(2022), 그리고 Writing in Bronze Age Crete(2025).
- P. M. Steele, Exploring Writing Systems and Practices in the Bronze Age Aegean(2023).
- B. Davis, Minoan Stone Vessels with Linear A Inscriptions(Aegaeum 36, 2014).
- J. Chadwick, M. Ventris, Documents in Mycenaean Greek, 제2판(1973), tiripode 어휘집(MIT 라이선스)에 수록된 용어집 범주.
- J. Luo, Y. Cao, R. Barzilay, “Neural decipherment via minimum-cost flow”(2019): 02절에서 사용한 선형 문자 B 단어 목록.
- A. Kanta, D. Nakassis, T. G. Palaima, M. Perna, “An archaeological and epigraphical overview of some inscriptions found in the Cult Center of the city of Knossos (Anetaki plot)”, Ariadne(2025) 27–43, doi.
- DAMOS, Database of Mycenaean at Oslo(damos.hf.uio.no), CC BY-NC-SA 4.0; J. Younger, 크레타 상형문자 어휘집과 기호 격자(보관된 페이지, 2007–2012), J.-P. Olivier, L. Godart, Corpus Hieroglyphicarum Inscriptionum Cretae(1996)에 따름.
- R. A. Brown, 에테오크레타어 비문(Dreros 1–2, Praisos 1–3)의 전사, 그의 에테오크레타어 페이지에서 보관본; Y. Duhoux, L’Étéocrétois: les textes, la langue(암스테르담 1982).
- 선그리스어 목록: Wiktionary(Kaikki 경유)에서 선그리스어 기원으로 표시된 고대 그리스어 항목, 대부분 R. Beekes와 E. J. Furnée에 따름.
- E. Laroche, Glossaire de la langue hourrite(파리 1980); Internet Archive의 OCR 텍스트, 계수에만 사용.
- H. C. Melchert, Cuneiform Luvian Lexicon(1993). 아카드어, 우가리트어, 에트루리아어, 고대 그리스어 및 대조군 어휘집은 Kaikki를 통해 Wiktionary에서 가져옴.
스크립트, 결과, 노트는 다음에 있다. targets/lineara/. 판독 스크립트는 targets/lineara/reading/build_reading.py, 그리고 targets/lineara/FRACTIONS_REPORT.md 에 전체 분수 분석이, targets/lineara/LEADS_REPORT.md 에 언어 및 이름 검증이 있다.