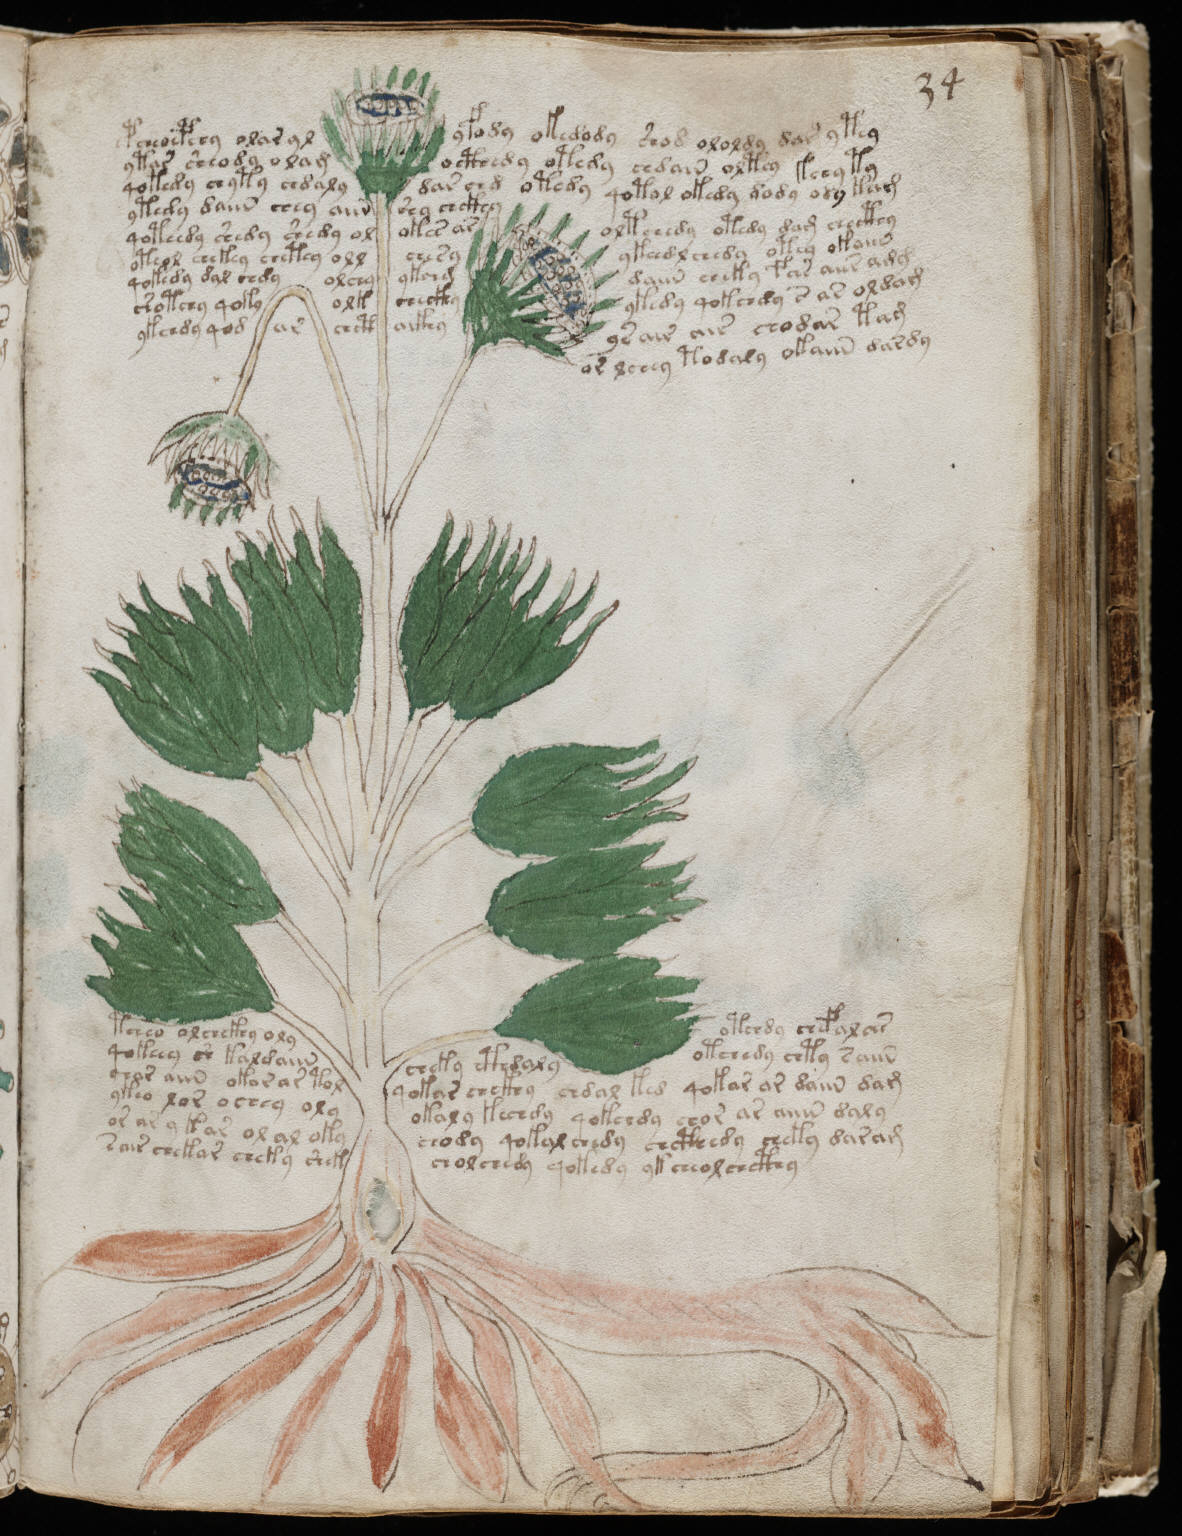
확정 Beinecke MS 408은 15세기 초의 진품 코덱스다. 양피지의 방사성 탄소 연대는 1404–1438년이고, 철-몰식자 잉크, 당대의 안료, 다섯 명의 필경사 필체가 있으며, 1600년경 프라하에서부터 소장 이력이 이어진다(09절). 현대의 위조는 배제된다.
배제 평범한 단어 분절을 따르는 유럽 언어 열한 개 중 어느 것의 평문도, 일대일 치환도, 글자 전치도, 아브자드식 표기도, 허자를 채워 넣은 표기도 아니다(03, 04, 05절). 조건부 문자 엔트로피는 원본 EVA에서 자연어 하한보다 최소 1.0비트, 서로 독립적인 글리프 분절 세 가지에서 최소 0.4비트 낮다.
유효 평문 단위 하나가 경직된 두세 글리프 묶음이 되는 장황 부호화 또는 슬롯 템플릿 부호화 대, 복사 후 수정 방식으로 슬롯을 보존하며 만드는 무의미 생성(06절과 08절). 보이니치 텍스트를 언어와 구별 짓는 모든 통계를 각 부류의 어떤 구성원이 재현한다. 판단*: 대략 반반, 약 45:50이며, 나머지는 암호화되지 않은 이국적 언어에 둔다.
01 질문과 방법
이것은 해독이 아니다. 질문은 텍스트가 무의미한가, 암호화되었는가, 언어인가, 그리고 공개 데이터로 한 세션 안에 그 질문을 어디까지 밀어붙일 수 있는가였다. 가설이나 증거 부류마다 하나씩, 다섯 차례의 문헌 조사가 내놓은 것은 SOURCES.md이다. 여섯 가지 계산 시험 a1 to a6은 ZL 전사를 자연어 코퍼스 및 구현한 날조 생성기와 대조해 돌렸다. 별도의 에이전트가 모든 시험을 적대적으로 다시 돌려(v_a1 to v_a6) 몇 가지를 정정했다. 인용한 수치는 정정된 것이다. 에이전트들을 돌리기 전에 작성한 기준 스크립트 두 개가 a1과 a2의 핵심 수치를 재현한다. 공백 없는 원본 EVA에서 h2 2.32비트, Zipf 기울기 −1.04, 인접 반복 0.81%.
(S)는 이번 세션에서 이름 붙은 스크립트로 계산한 수치를, (L)은 출처와 연도를 밝혀 문헌에서 인용한 수치를 표시한다. 판단에는 별표를 붙인다.
데이터 (S). ZL3b-n, Zandbergen–Landini EVA 전사(voynich.nu, 2025년 5월 13일), 단락 텍스트만: 읽지 못한 글리프나 확장 EVA 글리프가 있는 단어를 빼고 토큰 34,116개, Currier A가 약 10,750개, B가 약 22,900개, 단어 유형 7,236개. RF1b-er, IT2a, GC2a (v101), CD2a (Currier)로 교차 확인했다. 불확실한 공백 2,463개는 구분으로 다루었으며, 이를 붙여도 실질적으로 달라지는 것은 없다(v_a2). 언어 대조군은 Gutenberg 단행본들과 OCR로 처리한 16세기 이탈리아어 코퍼스다. 엔트로피는 플러그인 추정치이며, Miller–Madow 보정은 h2를 최대 0.007 움직인다.
02 가장 강한 반론부터
모든 문자 통계는 전사를 전제로 하며, EVA 공백이 평문 단위를 표시한다는 것도 전제한다. e, s, m마다 다시 분절한 라틴어는 보이니치 텍스트의 슬롯 경직성 쪽으로 60%만큼 다가가고, 모음으로 끝나는 음절로 자른 라틴어는 같은 길이에서 보이니치 텍스트보다 더 경직적이다(S: v_a3). 따라서 배제가 적용되는 범위는 현대 철자로 쓴 언어 열한 개의, 단어 경계를 보존하는 부호화다. 규칙 기반 재분절, 또는 경직된 자음-모음 음절을 가진 언어를 음절 단위로 쓴 것은 시험하지 않았다.
둘째, h1, h2와 그 비율에서 동시에 원본 EVA와 일치하는 장황 암호 대조군은 라틴어의 단어 엔트로피를 지니면서도 단어가 2.3배나 길다. 기호 11.52개 대 5.07개다(S: v_a1). 이는 라틴어 단어 전체를 글자 수준에서 장황하게 암호화했다는 가설을 반박한다. 두 점 모두 판정의 범위를 좁힌다. 어느 쪽도 판정을 뒤집지는 않는다.
03 문자 수준
가장 확고한 결과는 조건부 문자 엔트로피 h2, 즉 앞 글리프가 주어졌을 때 한 글리프의 불확실성이다. Bennett(1976)는 보이니치 텍스트를 2.22비트로, 유럽 언어들을 3.01–3.37비트로 보았다(L). Lindemann & Bowern(2021)은 그것이 Wikipedia 코퍼스의 250개 언어 모두보다 낮다는 것을 발견했다(L). 이 격차는 글리프 병합과 Currier 및 v101 알파벳에서도 살아남는다. 모든 행 (S), 공백 없음, a1, v_a1, v_a5.
| 텍스트 | h1 | h2 | h1−h2 | h2/h1 | 평균 단어 길이 |
|---|---|---|---|---|---|
| ZL 원본 EVA, Currier A | 3.832 | 2.353 | 1.479 | 0.614 | 4.98 |
| ZL 원본 EVA, Currier B | 3.859 | 2.182 | 1.677 | 0.565 | 5.12 |
| ZL 원본 EVA, 전체 | 3.865 | 2.311 | 1.554 | 0.598 | 5.07 |
| ZL 병합(benches, i/e 묶음, aiin, qo) | 4.039 | 2.870 | 1.170 | 0.710 | 3.7–3.9 |
| GC v101 (기호 68개) | 4.144 | 2.893 | 1.25 | 0.698 | 3.7–4.0 |
| Currier CD2a (기호 35개) | 3.857 | 2.660 | 1.197 | 0.690 | |
| 라틴어, 『아이네이스』 | 4.025 | 3.510 | 0.515 | 0.872 | 5.77 |
| 독일어 (발음 구별 기호 통합 시 3.335) | 4.160 | 3.391 | 0.769 | 0.815 | 4.88 |
| 언어 11개의 범위 (통합 시 하한 3.32) | 3.94–4.52 | 3.32–3.88 | 0.49–0.77 | 0.82–0.88 | 4.2–6.6 |
| 라틴어, 모음 제거 | 3.659 | 3.515 | 0.144 | 0.961 | 3.11 |
| 라틴어의 장황 암호, 글자마다 기호 2–3개, 기호 24개 | 3.901 | 2.325 | 1.576 | 0.596 | 11.52 |
| 장황 암호, 글자 8개는 단일 기호로 유지 | 4.102 | 2.916 | 1.186 | 0.711 | 7.64 |
원본 EVA는 2.18–2.35비트, ZL 병합, v101, Currier는 2.66–2.89비트를 낸다. 언어 열한 개의 하한은 발음 구별 기호를 통합했을 때 3.32다. 라틴어를 어떻게 전치해도 최소 3.44가 나온다. 모음을 지우면 라틴어는 3.52, h2/h1은 0.961이 되는데, 아브자드라면 나와야 할 방향과 반대다.
잉여성은 어디에 있는가. 단어 안에 있다. 단어 내부 h2는 원본에서 1.92–2.13비트인데 언어들은 2.94–3.41비트다. 글리프와 단어 내 위치 사이의 상호 정보량은 ZL, Currier, v101에 걸쳐 0.69–0.73비트인데 언어들은 0.17–0.27비트다. 글리프의 21–31%가 단어 내 한 위치에 고정되어 있는데, 글자는 0–8%다(S: a5, v_a5).
쌍 병합. 빈번한 글리프 쌍을 탐욕적으로 병합하면 약 40번 병합한 뒤에야 h1−h2 격차가 닫힌다. 따라서 50–60개의 단위 유형에서 뽑은 두세 글리프 단위의 부호화는 문자 통계와 양립하고, 평범한 문자 암호는 양립하지 않는다(S: a5). 탐욕적 병합은 하나의 휴리스틱을 시험할 뿐, 장황 부류 전체를 시험하는 것은 아니다(S: v_a5).
정보량. 단어 흐름은 425,468비트, 토큰당 12.47비트를 담고 있으며, 이는 같은 모델에서 같은 길이의 라틴어 산문 텍스트의 0.82배다(S: a5, v_a5).
04 단어 수준
단어 수준에서 보이니치 텍스트는 Landini(2001)와 Reddy & Knight(2011)가 보고한 대로 언어처럼 보인다(L). 표 (S), a2와 v_a2, 토큰 34,116개.
| 코퍼스 | Zipf 기울기, 순위 1–1000 | 유형 중 단발어 % | Heaps 베타 | 최빈 단어 비율 |
|---|---|---|---|---|
| 보이니치 전체 | −1.040 | 69.7 | 0.710 | 2.25% |
| 보이니치 A / B | −0.994 / −1.068 | 72.2 / 68.6 | 0.743 / 0.679 | 4.27% / 2.13% |
| 라틴어 (『아이네이스』) | −0.820 | 67.0 | 0.749 | 4.9% |
| 독일어 | −1.045 | 65.1 | 0.779 | 3.46% |
| 우리말 풀이 | −1.056 | 55.1 | 0.675 | 4.68% |
단어 유형 엔트로피는 9.8–10.3비트로, 라틴어 산문은 10.3–10.8비트, 이탈리아어, 프랑스어, 독일어는 9.4–9.8비트다(S: v_a1). 합친 텍스트의 최빈 단어 비율이 낮은 것은 A+B 혼합 효과다(S: v_a2). 단행본 표본과 비교하면 단발어 비율은 어느 언어보다도 높다(S: v_a5). 이 중 어느 것도 판별력이 없다. Zipf와 단발어는 사람이 지어낸 횡설수설(Gaskell & Bowern 2022), 생성기(Rugg & Taylor 2016; Timm & Schinner 2020), 라틴어에서 만든 수작업 암호(Greshko 2025)로도 재현된다(L).
단어 길이
병합 EVA 단어 길이(S: a2, v_a2):
| 코퍼스 | 평균 | 분산 | (길이−1)의 분산 / 평균 |
|---|---|---|---|
| 보이니치 전체 (원본 EVA 5.07 / 3.73 / 0.92) | 4.11 | 2.48 | 0.80 |
| 보이니치 A | 3.93 | 2.89 | 0.99 |
| 보이니치 B | 4.20 | 2.27 | 0.71 |
| 『아이네이스』 단독 / 『고백록』 단독 | 4.97 / | 1.04 / 1.74 | |
| 이탈리아어 / 독일어 / 영어 / 덴마크어 | 4.53 / 4.99 / 4.23 / 4.67 | 6.52 / 7.04 / 5.41 / 7.40 | 1.85 / 1.77 / 1.67 / 2.02 |
유명한 과소 분산, 이른바 “이항 분포를 따르는 단어 길이”는 Currier B의 특성이다. B의 분산 대 평균은 0.71, A는 0.99, 단일 텍스트 라틴어 운문은 1.04이므로, Currier A는 라틴어 운문과 맞으며 a2의 이항 적합 대비는 탐색 상한이 만든 인공물이었다. B와 합친 텍스트는 현대 산문의 1.67–2.02에서 멀리 떨어져 있다.
05 단어 문법과 반복
Tiltman(1951), Stolfi(2000), Zattera(2022)는 보이니치 단어 내부의 경직된 위치 문법을 기술했다(L). 여기서는 단일 최적 글리프 순서를 위반하는 글리프 쌍의 비율로, 길이를 맞추어 측정했다. 뒤섞기 귀무 분포는 0.49를 준다. 모든 행 (S): a3, a2, v_a2.
| 통계량 | 보이니치 | 라틴어 | 이탈리아어 | 독일어 | 우리말 풀이 |
|---|---|---|---|---|---|
| 최적 글리프 순서 대비 쌍 순서 위반, 길이 맞춤 (뒤섞기 귀무 분포 0.49) | 0.160 (v101 0.140) | 0.363 | 0.318 | 0.278 | 0.308 |
| 인접한 동일 토큰, % 및 관측:뒤섞기 | 0.907 / 2.5 | 0.047 / 0.1 | 0.047 / 0.1 | 0.157 / 0.3 | 0.137 / 0.2 |
| 줄 첫머리의 첫 글리프 효과, Cramér의 V, 단락 첫 줄 제외 | 0.277 | 임의로 줄을 나눈 산문 0.02–0.03; 6보격 시 0.148 | |||
보이니치 텍스트는 시험한 어떤 언어보다 1.7–2.3배 더 경직적이다. 아무 가정 없이 데이터에서 도출한 글리프 순서, 즉 q, 그다음 p f sh, 그다음 ch, 그다음 o t k, 그다음 e ee, 그다음 d s a, 그다음 l r y, 그다음 g n iin m은 Stolfi와 Zandbergen의 배치를 블라인드로 복원한 것이다(S: a3).
Currier(1976)가 말했듯이 줄 내 위치가 중요하다(L). 줄 첫머리 효과는 6보격 운문을 넘어서며, 임의로 줄을 나눈 산문보다 한 자릿수 크다. a2가 보고한 줄 끝 효과는 끝의 m과 g 이형자를 제거하면 V 0.07–0.16으로 무너진다(S: v_a2).
06 자기 인용과 생성기 비교 대결
Timm(2014, 2016)은 비슷한 단어들이 페이지 위에 모여 있으며, 이는 앞선 단어를 베껴 수정한 흔적이라고 주장했다. Timm & Schinner(2020)는 그렇게 하는 알고리즘을 공개했다(L). 이 시험은 각 토큰에 대해 같은 페이지에서 편집 거리 1 이내에 있는 가장 가까운 앞선 토큰을 찾으며, 모든 코퍼스를 똑같은 페이지 및 줄 골격에 부어 넣는다. Rugg식 생성기 두 개와 다시 구현한 autocopist를 같은 코드로 돌렸다. 모든 행 (S), a4와 v_a4.
| 코퍼스 | 중앙값 거리 | 10토큰 이내 | 페이지 내 뒤섞기 | 전역 뒤섞기 | 긴 토큰(5 이상) 10 이내 |
|---|---|---|---|---|---|
| 보이니치 ZL | 14 | 0.269 | 0.238 | 0.167 | 0.225 |
| 라틴어 (『아이네이스』) | 41 | 0.035 | 0.034 | 0.030 | 0.006 |
| 영어 (이탈리아어, 독일어도 비슷함) | 17 | 0.176 | 0.177 | 0.164 | 0.019 |
| 덴마크어 (운문) | 15 | 0.196 | 0.172 | 0.138 | 0.035 |
| Autocopist (Timm–Schinner 재구현) | 13 | 0.329 | 0.275 | 0.079 | 0.257 |
| Rugg 그릴 | 36 | 0.067 | 0.249 | 0.066 | 0.033 |
| Rugg 정렬 표 | 34 | 0.329 | 0.162 | 0.112 | 0.341 |
| 보이니치 텍스트로 학습한 3차 문자 마르코프 모델 | 19 | 0.194 | 0.194 | 0.194 | 0.119 |
순차 초과분, 즉 실제 값에서 페이지 내 뒤섞기 값을 뺀 것은 베끼기 순서를 측정한다. 보이니치 +0.031, 덴마크어 운문 +0.024, autocopist +0.054, 산문은 약 0. 페이지 어휘 초과분, 즉 실제 값에서 전역 뒤섞기 값을 뺀 것은 보이니치 +0.102, 언어들은 최대 +0.058, autocopist +0.250이다. 글리프 다섯 개 이상의 토큰에서는 언어 기준선이 0.035 이하로 무너지는 반면 보이니치 텍스트는 0.225를 유지하지만, 아무것도 베끼지 않는 3차 문자 마르코프 모델도 0.119에 이른다. 긴 토큰 밀도의 약 절반은 베끼기가 아니라 단어 내부 구조에서 나온다(S: v_a4).
비교 대결
| 텍스트 | 유형 | h2 원본 | h2 병합 | Zipf 기울기 | 단발어 % | 인접 반복 | 쌍 위반 |
|---|---|---|---|---|---|---|---|
| 보이니치 ZL | 7,236 | 2.311 | 2.646 | −1.040 | 69.7 | 0.0082 | 0.160 |
| Autocopist, 시드 두 개 | 11,660 / 11,330 | 2.709 / 2.723 | 3.274 / 3.005 | −0.825 / −0.859 | 72.2 / 71.1 | 0.0013 / 0.0018 | 자유 편집 0.41–0.46 |
| Rugg 그릴 / 정렬 표 | 3,747 / 1,757 | 2.798 / 2.629 | 3.176 / 2.912 | −0.429 / −0.622 | 5.7 / 13.9 | 0.0003 / 0.0893 | 적합시킨 표 0.122 |
모든 열에서 들어맞는 생성기는 없다. autocopist는 토큰 기준으로 실제 보이니치 단어 유형을 37%밖에 내지 못하고, qo로 시작하는 단어는 15%가 아니라 2%이며, h2는 0.4–0.6비트 너무 높다. 국소성과 페이지 어휘를 과잉 생산하는데, 필사본 자체의 순차 초과분은 덴마크어 운문 정도에 불과하다. 이것은 편차를 문서화한 재구현이지 Timm의 참조 프로그램이 아니다. 그릴들은 Zipf와 단발어에서 대놓고 실패한다. 슬롯 경직성을 재현하는 유일한 표는 그 열들을 보이니치 텍스트에서 읽어 온 것이다. 충분조건일 뿐이다(S: v_a3).
07 Currier A와 B
Currier(1976)는 필사본에서 두 개의 통계적 언어를 발견했다(L). 둘을 가르는 것은 다음과 같다(S: a6, v_a6).
| 통계량 | A | B |
|---|---|---|
| -edy로 끝나는 / ed를 포함하는 토큰 | 0.20% / 0.29% | 17.34% / 20.84% |
| cho를 포함하는 / qo-로 시작하는 / -ol로 끝나는 | 16.1 / 10.0 / 14.5% | 2.7 / 17.7 / 7.1% |
| ch 다음의 글리프: e / o | 24.5 / 46.1% | 60.1 / 10.1% |
| 토큰 천 개당 daiin | 42.5 | 13.0 |
197엽에 대한 비지도 군집화는 Currier의 레이블을 95.4–99.5%로 복원한다. -edy 임계값 하나로 leave-one-out 기준 99.5%의 정확도로 둘을 가를 수 있다. A는 뾰족한 봉우리로 114엽 중 112엽이 2% 미만이고, B는 3%에서 42%까지의 연속체다. IT2a에서도 마찬가지다. Parisel의 2026년 프리프린트도 독립적으로 같은 단일 스위치 서술에 도달한다(L).
필경사가 언어를 결정한다. IVTFF 헤더에 있는 Davis(2020)의 필체 다섯 가지를 쓰면, H(언어 | 필체)는 0.09비트이고 줄의 98.2%를 필체만으로 예측할 수 있다. 섞여 있는 유일한 칸은 별 부분의 필체 3이다. 언어를 정하는 것은 주제가 아니라 필경사다.
어휘 공유, 보정한 값. 크기를 맞춘 A 대 B는 Jaccard 0.147, 상위 100개 중첩 0.95인데, A의 두 절반은 0.207과 1.00, 영어 소설 두 편은 0.172와 0.91, 덴마크어 대 노르웨이어는 0.116과 0.67이다. 단어 끝 패턴이 0.2%에서 17%로 옮겨 가는 일은 한 언어의 책들 사이에서는 유례가 없지만 언어들 사이에서는 있다. 프랑스어 대 이탈리아어에서 끝의 -o가 0.19%에서 17.5%로 간다(S: v_a6).
부분별 단어. 부분 특유의 어휘가 존재한다. 토큰당 평균 카이제곱이 0.654로, 뒤섞은 것은 0.121, 이탈리아어는 0.40이며, 한 필경사와 한 언어 안에서도 지속된다. 그러나 부분별 단어들은 qokain, qol, qokeedy, okeol 같은 같은 하위 단어 계열에 속하며, 내용 어휘를 닮은 어떤 것에도 속하지 않는다(S: v_a6).
08 가설의 현황
배제
- 시험한 언어 열한 개의 평문 또는 단일 문자 치환: h2 격차가 원본에서 최소 1.0비트, 병합에서 최소 0.4비트(S: a1, v_a1; L: Bennett 1976, Zandbergen, Lindemann & Bowern 2021).
- 치환에 모음 제거나 관례적 약어를 더한 것(S: a1, a5; L: Lindemann & Bowern 2021).
- 그릴 재배열을 포함한, 실제 평문의 글자 수준 전치(S: v_a5; L: Parisel 2026).
- 비즈네르형 다표식 암호(L: D’Imperio 1978, Stolfi 2000).
- 잉여성의 원천으로서의 단일 글리프 허자(S: a5).
- 이름이 알려진 해독들: Cheshire 2019(검토자들이 반박함), 해독으로 읽힌 Hauer & Kondrak 2016(저자들 스스로의 단서), Bax 2014, Gibbs 2017, Ardic, Gladyseva 2023, Schechter 2025, 그리고 2025–2026년의 LLM 보조 판독들. 재현 가능한 키가 없고, 블라인드 적용을 통과한 것은 하나도 없다(L).
- 현대의 위조(L: 방사성 탄소, 잉크, 소장 이력).
가능성 낮음*
- 암호화되지 않은 이국적 언어: 공개된 h2 중 가장 가까운 것은 하와이어의 2.77이며(L), 슬롯 문법에는 유례가 없다.
- 메커니즘으로서의 Rugg의 표와 그릴: 카르다노 그릴은 1550년경의 것인데 양피지는 1404–1438년이고, f와 p의 특수한 역할은 표에서 생겨날 수 없으며(L: Zandbergen 2021), 이번 세션의 그릴들은 Zipf와 단발어에서 실패한다(S: a4).
- 여기서 구현한 자유 편집 자기 인용: 국소성과 어휘를 과잉 생산하고 문자 잉여성은 과소 생산한다(S: a4, v_a4; 06절).
- Dee와 Kelly의 글로솔랄리아(방언)(L: Daruka 2020). 양피지 연대와 충돌한다.
유효
- (a) 짧은 단위의 장황 암호 또는 슬롯 템플릿 암호, 노멘클레이터, 또는 의미를 지닌 인공어. 03, 05, 07절과 양립하며, 여러 핵심 통계를 재현하는, 손으로 실행 가능한 15세기 설계와도 양립한다(L: Greshko 2025, Naibbe 암호; Bowern & Gaskell 2022). 단어 길이 제약(장황 대조군은 기호 7.6–11.5개를 낸다; S: v_a1), 0에 가까운 토큰 간 예측 가능성(L: Rozanova & Temerev 2026, 프리프린트), 줄 첫머리 효과(S: v_a2)도 충족해야 한다.
- (b) 슬롯을 보존하는 복사 후 수정 생성(L: Timm & Schinner 2020, 2023; Timm 2026). 측정한 모든 것과 양립하지만, 슬롯 문법은 그 모델의 산물이 아니라 입력이며(S: a3), 페이지, 부분, 필경사 구조에 맞서 필사본 길이로 돌려 본 구현은 아직 없다(L: 세 차례의 조사 모두).
- (c) 단어가 아닌 분절 아래의 실제 언어. 시험하지 않음(S: v_a3).
09 물리적 증거가 더해 주는 것
모두 (L). 4엽에 대한 방사성 탄소 연대: 1404–1438년(Hodgins, University of Arizona, 2009). 전체에 걸쳐 철-몰식자 잉크와 당대의 안료(McCrone 2009; Yale 2014). 필체 다섯 가지로, 그중 셋이 227쪽 중 188쪽을 썼으며, 하나의 문자 체계를 공유한다(Davis 2020). 로망스어 방언의 달 이름과 f116v의 독일 필체 메모는 이것이 수십 년 안에 독일어권 및 프랑스어/오크어권 사람들의 손을 거쳤음을 보여 준다. 10엽의 다중 분광 이미지(2014년 촬영, 2024년 공개)는 f1r에서 지워진 알파벳 연습과 Tepenecz의 장서표를 복원했지만, 새로운 보이니치 텍스트는 나오지 않았다. 소장 이력은 1600년경 프라하에서 Baresch(1639), Marci(1665), Kircher를 거쳐 1912년까지 이어진다.
그 귀결은 양쪽에 똑같이 적용된다. 무의미 텍스트 설명은 이것이 1420년대에 새 송아지 가죽 위에서, 200쪽이 넘는 분량에 걸쳐 하나의 슬롯 문법과 하나의 A/B 스위치를 일관되게 유지한 여러 필경사의 협업으로 만들어졌어야 한다는 것인데, 그 비용은 어떤 통계도 다루지 않는다. 암호 설명은 왜 주제가 아니라 필경사가 언어를 정하는지 설명해야 한다(07절).
10 나머지를 결판낼 수 있는 것
- 필사본 길이에서 사전 등록한 생성기 비교 대결: 자기 인용, 표와 그릴, Naibbe로 암호화한 라틴어, 사람이 지어낸 횡설수설을 하나의 시험 묶음으로 평가한다. 여기에는 Montemurro–Zanette의 장거리 핵심어 봉우리(L: 2013), 주제×삽화×필경사 공동 군집화, 인접 페이지 유사도, A/B 분리 가능성, f와 p 규칙, 토큰 예측 가능성이 포함된다. 스크립트 a1–a6은 TSV 형식의 어떤 텍스트에도 쓸 수 있는 부분적인 시험 묶음이다.
- 필사본 길이의 사람이 지어낸 횡설수설을 삽화와 부분을 갖추어 몇 주에 걸쳐 쓰는 것. Gaskell & Bowern(2022)이 미결 시험으로 지목한 것이다(L).
- 삽화와 텍스트 사이의 상호 정보량을 필체, 첩, 인접성을 통제한 상태로 측정하는 것.
- 확실한 공백만으로 다시 토큰화하기, 그리고 같은 통계를 라틴어와 이탈리아어의 음절 분절에 적용해 02절에서 남은 빈틈을 메우는 것.
- 주장된 키가 있다면: 제3자가 A 5엽과 B 5엽에 블라인드로 적용하고, 글리프를 뒤섞은 대조군을 둔다.
11 확인한 것, 확인하지 않은 것, 검증해야 할 것
확인한 것. a1–a6의 모든 핵심 수치는 독립적인 재구현 v_a1–v_a6으로 재현했으며, 여기에는 Levenshtein 코드, 엔트로피 공식, 추정량 편향, 코퍼스 내용, Gutenberg 상용 문구가 포함된다. ZL, RF1b, IT2a, GC2a, CD2a에 걸친 강건성. 적용한 정정: 단행본 표본; 라틴어 단어 엔트로피는 운문이 아니라 산문에서; 통합 하한 3.32; 경직성 비율 1.7–2.3; Currier B의 특성으로서의 과소 분산; m/g 이형자로서의 줄 끝 효과; leave-one-out 99.5%의 A/B 규칙.
확인하지 않은 것. 유료인 Cryptologia 전문(Rugg 2004, Schinner 2007, Timm & Schinner 2020과 2023, Daruka 2020, Greshko 2025)은 초록과 2차 요약으로 파악했다. 고차 엔트로피와 필체별 엔트로피, A 대 B의 유의성 검정, 부트스트랩 구간은 계산하지 않았다. 문헌의 고수준 통계(Montemurro–Zanette 봉우리, 주제 모델, 인접 페이지 유사도)는 하나도 다시 계산하지 않았다. Davis의 필체 배정은 IVTFF 헤더에서 가져왔다. 방사성 탄소, 잉크, 필체, 1639년 편지 이외의 물리적 증거, 즉 잉크 층위, 안료 순서, 첩 순서는 검토하지 않았다.
인용하기 전에 사용자가 검증해야 할 것. 코퍼스 선택(Gutenberg 단행본; 라틴어가 약 8% 섞인 OCR 이탈리아어 코퍼스; 운문 대 산문 라틴어), 글리프 병합 목록, 기호 24개 장황 대조군의 설계, 불확실한 공백을 구분으로 다룬 것, 그리고 배제, 가능성 낮음, 유효라는 레이블. 두 수치가 여러 형태로 나온다. 병합 h2는 엔트로피 표에서 2.870, 비교 대결 표에서 2.646이다. 인접 반복률은 경직성 표에서 0.907%, 비교 대결 표에서 0.0082, 기준선에서 0.81%다. 노트는 이들을 조정하지 않았다. 서로 다른 병합 목록과 토큰 필터가 원인일 가능성이 크며*, 이는 results/ 에 있는 스크립트별 JSON으로 확인할 수 있을 것이다. 모든 출력은 검토 전까지 검증되지 않은 상태다.
12 파일과 재현
모든 것은 다음에 있다. targets/voynich/. parse_ivtff.py 는 IVTFF를 TSV로 변환한다. data/ZL3b-n.words.tsv 는 파싱한 주 전사다. 원본 파일은 voynich.nu/data에서 브라우저 헤더를 붙여 받는다. 서버가 평범한 curl 요청을 거부하기 때문이다. baseline.py 및 baseline2.py 는 독립적인 기준 스크립트다. 시험: a1_charstats.py, a2_wordstats.py, a3_wordgrammar.py 및 a3_supplement.py, a4_selfcitation.py, a5_cipher.py, a6_structure.py; 재실행 v_a1.py to v_a6.py. results/ 에는 스크립트별 JSON과 Markdown, 생성기 표본이 있다. NOTES.md 는 이 페이지가 요약한 판정 문서이고, SOURCES.md 는 다섯 차례의 문헌 조사다.