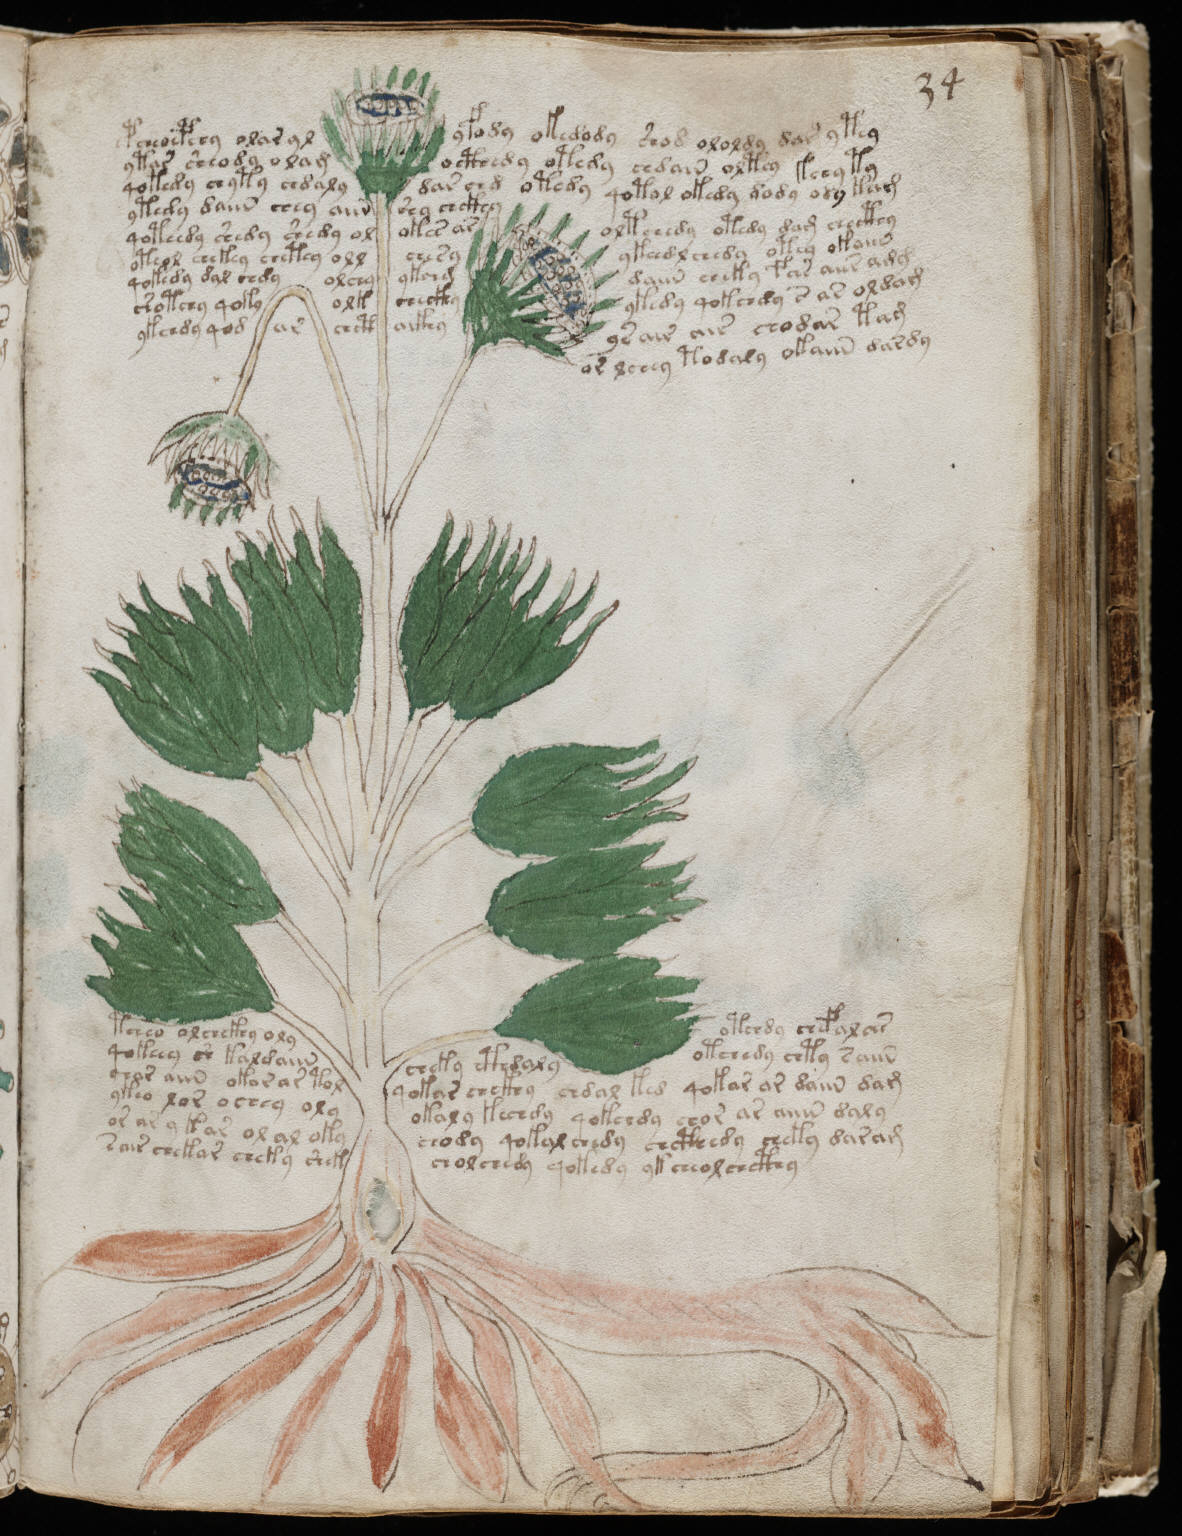
確定 Beinecke MS 408 は15世紀初めの本物の写本である。羊皮紙の放射性炭素年代は1404–1438年、没食子インク、当時の顔料、5人の書き手、1600年頃のプラハに遡る来歴(第09節)。近代の偽作は除外される。
除外 通常の語の区切りを保った、11のヨーロッパ言語いずれかの平文、一対一換字、文字の転置、子音文字表記、冗字を詰め込んだ表記ではない(第03、04、05節)。条件付き文字エントロピーは、生の EVA で自然言語の下限より少なくとも1.0ビット低く、3つの独立した字形分割のもとでも少なくとも0.4ビット低い。
存続 平文の1単位が硬直した2字形または3字形の群になる冗長な、あるいはスロット型テンプレートによる符号化と、コピーと修正によるスロット保存型の無意味な生成との対立(第06、08節)。ヴォイニッチ文字を言語から分けるすべての統計量は、それぞれの類のいずれかの成員によって再現される。判断*:ほぼ互角で約45対50、残りは暗号化されていない珍しい言語。
01 問いと方法
これは解読ではない。問いは、テキストが無意味か、暗号化されているか、言語か、そして公開データで1回のセッションのうちにそれをどこまで詰められるかだった。仮説または証拠の類ごとに1回ずつ、計5回の文献調査を行い、その成果が SOURCES.mdである。6つの計算による検定 a1 to a6を、ZL 転写に対して、自然言語のコーパスおよび実装したでっちあげ生成器と比較しながら走らせた。別のエージェントがすべての検定を反証の立場から再実行し(v_a1 to v_a6)、いくつかを訂正した。引用する数値は訂正後のものである。エージェントを走らせる前に書いた2つの基準スクリプトが、a1 と a2 の主要な結果を再現する。空白なしの生の EVA で h2 は2.32ビット、Zipf の傾きは −1.04、隣接する反復は0.81%である。
(S) は、このセッションで名前を挙げたスクリプトによって計算した数値を示す。(L) は文献から引用した数値で、出典と年を付ける。判断にはアスタリスクを付ける。
データ (S)。 ZL3b-n、Zandbergen–Landini による EVA 転写(voynich.nu、2025年5月13日)、段落のテキストのみ:未読字形または拡張 EVA 字形を含む語を除いた後で34,116トークン、Currier A に約10,750、B に約22,900、語の種類は7,236。RF1b-er、IT2a、GC2a(v101)、CD2a(Currier)で照合した。2,463の不確かな空白は区切りとして扱った。それらを結合しても実質的には何も変わらない(v_a2)。言語の対照は Gutenberg の単一の書物と、OCR にかけた16世紀イタリア語のコーパスである。エントロピーは単純推定量による。Miller–Madow 補正で h2 が動くのは最大0.007である。
02 最も強い反論を先に
すべての文字統計は転写を前提とし、EVA の空白が平文の単位を示すことを前提としている。ラテン語を e、s、m の後ごとに分割し直すと、ヴォイニッチ文字のスロットの硬直性へ60%近づき、母音で終わる音節に切ったラテン語は、同じ長さでヴォイニッチ文字より硬直的になる(S: v_a3)。したがって除外が及ぶのは、現代の正書法による11言語の、語の境界を保つ符号化である。規則に基づく再分割や、硬直した子音+母音の音節をもつ言語を音節文字で書いたものは検定していない。
第二に、h1、h2、その比のすべてで生の EVA に一致する冗長暗号の対照は、ラテン語の語のエントロピーを保ちながら、2.3倍長すぎる語を生み出す。11.52記号対5.07記号である(S: v_a1)。これは、ラテン語の語全体に対する文字レベルの冗長暗号を否定する。どちらの点も判定を狭めるが、覆すものではない。
03 文字レベル
最も確かな結果は条件付き文字エントロピー h2、すなわち直前の字形が分かっているときの字形の不確かさである。Bennett(1976年)はヴォイニッチ文字を2.22ビットとし、ヨーロッパ言語の3.01から3.37と対比した(L)。Lindemann & Bowern(2021年)は、Wikipedia コーパスの250言語すべてより低いことを見いだした(L)。この差は、字形の統合や Currier と v101 のアルファベットでも残る。すべての行は (S)、空白なし、a1、v_a1、v_a5。
| テキスト | h1 | h2 | h1−h2 | h2/h1 | 平均語長 |
|---|---|---|---|---|---|
| ZL 生の EVA、Currier A | 3.832 | 2.353 | 1.479 | 0.614 | 4.98 |
| ZL 生の EVA、Currier B | 3.859 | 2.182 | 1.677 | 0.565 | 5.12 |
| ZL 生の EVA、全体 | 3.865 | 2.311 | 1.554 | 0.598 | 5.07 |
| ZL 統合(ベンチ、i/e 群、aiin、qo) | 4.039 | 2.870 | 1.170 | 0.710 | 3.7–3.9 |
| GC v101(68記号) | 4.144 | 2.893 | 1.25 | 0.698 | 3.7–4.0 |
| Currier CD2a(35記号) | 3.857 | 2.660 | 1.197 | 0.690 | |
| ラテン語、『アエネーイス』 | 4.025 | 3.510 | 0.515 | 0.872 | 5.77 |
| ドイツ語(ダイアクリティカルマークを畳み込むと3.335) | 4.160 | 3.391 | 0.769 | 0.815 | 4.88 |
| 11言語の範囲(畳み込み後の下限3.32) | 3.94–4.52 | 3.32–3.88 | 0.49–0.77 | 0.82–0.88 | 4.2–6.6 |
| ラテン語、母音を除去 | 3.659 | 3.515 | 0.144 | 0.961 | 3.11 |
| ラテン語の冗長暗号、各文字を2–3記号に、24記号 | 3.901 | 2.325 | 1.576 | 0.596 | 11.52 |
| 冗長暗号、8文字は単独のまま | 4.102 | 2.916 | 1.186 | 0.711 | 7.64 |
生の EVA は2.18から2.35ビット、ZL 統合、v101、Currier は2.66から2.89ビットである。11言語の下限は、ダイアクリティカルマークを畳み込んで3.32である。ラテン語をどう転置しても少なくとも3.44になる。母音を削除するとラテン語は3.52、h2/h1 は0.961となり、子音文字表記としては逆方向である。
冗長性のありか。 語の内部である。語内の h2 は、生のデータで1.92から2.13ビット、言語では2.94から3.41である。字形と語内の位置の相互情報量は、ZL、Currier、v101 を通じて0.69から0.73ビット、言語では0.17から0.27である。字形の21%から31%が語内の1つの位置に固定されているのに対し、文字では0%から8%である(S: a5, v_a5)。
組の統合。 頻出する字形の組を貪欲法で統合していくと、h1−h2 の差が埋まるのは約40回の統合の後である。したがって、50から60種類の単位からなる2–3字形の単位による符号化は文字統計と両立し、単純な文字暗号は両立しない(S: a5)。貪欲法による統合は1つの発見的手法を検定するにすぎず、冗長暗号の類全体を検定するものではない(S: v_a5)。
情報量。 語の流れは425,468ビット、1トークンあたり12.47ビットを運び、これは同じモデルのもとで同じ長さのラテン語散文の0.82倍である(S: a5, v_a5)。
04 語レベル
語レベルでは、Landini(2001年)や Reddy & Knight(2011年)が報告したように、ヴォイニッチ文字は言語のように見える(L)。表は (S)、a2 と v_a2、34,116トークン。
| コーパス | Zipf の傾き、順位1–1000 | 種類中のハパックスの% | Heaps の beta | 最頻語の比率 |
|---|---|---|---|---|
| ヴォイニッチ全体 | −1.040 | 69.7 | 0.710 | 2.25% |
| ヴォイニッチ A / B | −0.994 / −1.068 | 72.2 / 68.6 | 0.743 / 0.679 | 4.27% / 2.13% |
| ラテン語(『アエネーイス』) | −0.820 | 67.0 | 0.749 | 4.9% |
| ドイツ語 | −1.045 | 65.1 | 0.779 | 3.46% |
| 日本語 | −1.056 | 55.1 | 0.675 | 4.68% |
語の種類のエントロピーは9.8から10.3ビットで、ラテン語散文は10.3から10.8、イタリア語、フランス語、ドイツ語は9.4から9.8である(S: v_a1)。全体をまとめたときの最頻語の比率の低さは A と B の混合による効果である(S: v_a2)。単一の書物の標本と比べると、ハパックスの割合はどの言語よりも高い(S: v_a5)。これらはどれも識別力をもたない。Zipf とハパックスは、人間のでたらめ書き(Gaskell & Bowern 2022)、生成器(Rugg & Taylor 2016; Timm & Schinner 2020)、ラテン語からの手作業の暗号(Greshko 2025)によって再現される(L)。
語長
統合した EVA の語長(S: a2, v_a2):
| コーパス | 平均 | 分散 | (長さ−1)の分散/平均 |
|---|---|---|---|
| ヴォイニッチ全体(生の EVA 5.07 / 3.73 / 0.92) | 4.11 | 2.48 | 0.80 |
| ヴォイニッチ A | 3.93 | 2.89 | 0.99 |
| ヴォイニッチ B | 4.20 | 2.27 | 0.71 |
| 『アエネーイス』のみ / 『告白』のみ | 4.97 / | 1.04 / 1.74 | |
| イタリア語 / ドイツ語 / 英語 / デンマーク語 | 4.53 / 4.99 / 4.23 / 4.67 | 6.52 / 7.04 / 5.41 / 7.40 | 1.85 / 1.77 / 1.67 / 2.02 |
有名な過小分散、「二項分布的な語長」は Currier B の性質である。B の分散対平均比は0.71、A は0.99、単一テキストのラテン語韻文は1.04である。したがって Currier A はラテン語韻文に一致し、a2 における二項分布への当てはめの対比は、探索の上限による人為的な結果だった。B とまとめたテキストは、現代散文の1.67から2.02からは遠く離れたままである。
05 語の文法と反復
Tiltman(1951年)、Stolfi(2000年)、Zattera(2022年)は、ヴォイニッチ文字の語の内部に硬直した位置の文法があることを記述した(L)。ここでは、単一の最良の字形順序に違反する字形の組の割合として、長さをそろえて測定した。シャッフルによる帰無値は0.49である。すべての行は (S):a3、a2、v_a2。
| 統計量 | ヴォイニッチ | ラテン語 | イタリア語 | ドイツ語 | 日本語 |
|---|---|---|---|---|---|
| 最良の字形順序に対する組の順序違反、長さをそろえたもの(シャッフルによる帰無値0.49) | 0.160 (v101 0.140) | 0.363 | 0.318 | 0.278 | 0.308 |
| 隣接する同一トークン、%と観測値:シャッフル値の比 | 0.907 / 2.5 | 0.047 / 0.1 | 0.047 / 0.1 | 0.157 / 0.3 | 0.137 / 0.2 |
| 行頭の最初の字形の効果、Cramér の V、段落の最初の行は除外 | 0.277 | 擬似的に行分けした散文 0.02–0.03、六脚韻 0.148 | |||
ヴォイニッチ文字は、検定したどの言語よりも1.7から2.3倍硬直的である。前提なしにデータから導いた字形の順序、q、次に p f sh、次に ch、次に o t k、次に e ee、次に d s a、次に l r y、次に g n iin m は、Stolfi と Zandbergen の配置を盲目的に復元したものである(S: a3)。
Currier(1976年)が述べたとおり、行内の位置は重要である(L)。行頭の効果は六脚韻の韻文を上回り、擬似的に行分けした散文より1桁大きい。a2 が報告した行末の効果は、末尾の m と g の異体字を取り除くと V 0.07 から 0.16 に崩れる(S: v_a2)。
06 自己引用と生成器の比較試験
Timm(2014年、2016年)は、似た語がページ上でかたまって現れること、つまり前に書いた語を写して修正した痕跡があることを論じ、Timm & Schinner(2020年)はそれを行うアルゴリズムを公表した(L)。この検定では、各トークンについて、同じページ上で編集距離1以内にある最も近い前のトークンを探す。すべてのコーパスを同一のページと行の骨組みに流し込んで行う。Rugg 型の生成器2つと再実装した自動写字器(autocopist)を同じコードで走らせた。すべての行は (S)、a4 と v_a4。
| コーパス | 距離の中央値 | 10トークン以内 | ページ内シャッフル | 全体シャッフル | 長いトークン(5以上)が10以内 |
|---|---|---|---|---|---|
| ヴォイニッチ ZL | 14 | 0.269 | 0.238 | 0.167 | 0.225 |
| ラテン語(『アエネーイス』) | 41 | 0.035 | 0.034 | 0.030 | 0.006 |
| 英語(イタリア語、ドイツ語も同様) | 17 | 0.176 | 0.177 | 0.164 | 0.019 |
| デンマーク語(韻文) | 15 | 0.196 | 0.172 | 0.138 | 0.035 |
| 自動写字器(Timm–Schinner の再実装) | 13 | 0.329 | 0.275 | 0.079 | 0.257 |
| Rugg のグリル | 36 | 0.067 | 0.249 | 0.066 | 0.033 |
| Rugg の並べ替え表 | 34 | 0.329 | 0.162 | 0.112 | 0.341 |
| ヴォイニッチ文字で学習した3次の文字マルコフモデル | 19 | 0.194 | 0.194 | 0.194 | 0.119 |
逐次的な超過分、すなわち実データからページ内シャッフルを引いた値は、写しの順序を測る:ヴォイニッチ +0.031、デンマーク語韻文 +0.024、自動写字器 +0.054、散文はほぼ0。ページ語彙の超過分、すなわち実データから全体シャッフルを引いた値は、ヴォイニッチ +0.102、言語は最大 +0.058、自動写字器 +0.250。5字形以上のトークンについては、言語の基準値は0.035以下に崩れるのに対し、ヴォイニッチ文字は0.225にとどまる。しかし何も写さない3次の文字マルコフモデルが0.119に達する。長いトークンの密度の約半分は語内部の構造によるもので、写しによるものではない(S: v_a4)。
比較試験
| テキスト | 種類 | h2 生 | h2 統合 | Zipf の傾き | ハパックス % | 隣接反復 | 組の違反 |
|---|---|---|---|---|---|---|---|
| ヴォイニッチ ZL | 7,236 | 2.311 | 2.646 | −1.040 | 69.7 | 0.0082 | 0.160 |
| 自動写字器、2つの初期値 | 11,660 / 11,330 | 2.709 / 2.723 | 3.274 / 3.005 | −0.825 / −0.859 | 72.2 / 71.1 | 0.0013 / 0.0018 | 自由編集 0.41–0.46 |
| Rugg のグリル / 並べ替え表 | 3,747 / 1,757 | 2.798 / 2.629 | 3.176 / 2.912 | −0.429 / −0.622 | 5.7 / 13.9 | 0.0003 / 0.0893 | 当てはめた表 0.122 |
すべての列で一致する生成器はない。自動写字器は、トークン単位で実際のヴォイニッチの語の種類を37%しか生み出さず、qo で始まる語は15%に対して2%、h2 は0.4から0.6ビット高すぎる。局所性とページ語彙を過剰に生み出すが、写本自身の逐次的な超過分はデンマーク語韻文程度の大きさしかない。これは逸脱点を文書化した再実装であり、Timm の参照プログラムではない。グリルは Zipf とハパックスで完全に失敗する。スロットの硬直性を再現する唯一の表は、その列をヴォイニッチ文字から読み取ったものであり、十分条件を示すにすぎない(S: v_a3)。
07 Currier A と B
Currier(1976年)は写本の中に2つの統計的な言語を見いだした(L)。両者を分けるもの(S: a6, v_a6):
| 統計量 | A | B |
|---|---|---|
| -edy で終わるトークン / ed を含むトークン | 0.20% / 0.29% | 17.34% / 20.84% |
| cho を含む / qo- で始まる / -ol で終わる | 16.1 / 10.0 / 14.5% | 2.7 / 17.7 / 7.1% |
| ch の後の字形:e / o | 24.5 / 46.1% | 60.1 / 10.1% |
| 1000トークンあたりの daiin | 42.5 | 13.0 |
197丁の教師なしクラスタリングは、Currier のラベルを95.4%から99.5%の精度で復元する。-edy の単一のしきい値で、一個抜き交差検証で99.5%の精度で両者を分けられる。A は鋭い山で、114丁中112丁が2%未満、B は3%から42%までの連続体である。IT2a でも同じである。Parisel の2026年のプレプリントは、独立に同じ単一スイッチによる記述に達している(L)。
書き手が言語を決める。 IVTFF のヘッダーにある Davis(2020年)の5人の書き手を使うと、H(言語 | 書き手) は0.09ビットで、行の98.2%が書き手だけから予測される。混在する唯一の区画は星のセクションの書き手3である。言語を決めるのは主題ではなく書き手である。
語彙の共有、較正済み。 大きさをそろえた A と B の比較では Jaccard 係数0.147、上位100語の重なり0.95である。A の2つの半分では0.207と1.00、英語の小説2冊では0.172と0.91、デンマーク語とノルウェー語では0.116と0.67である。語末のパターンが0.2%から17%に移るという現象は、同じ言語の書物どうしには類例がないが、言語間にはある。フランス語対イタリア語の語末 -o は0.19%から17.5%である(S: v_a6)。
セクションの語。 セクション固有の語彙は存在する。トークンあたりのカイ二乗の平均は0.654で、シャッフルでは0.121、イタリア語では0.40であり、1人の書き手、1つの言語の中でも持続する。しかしセクションの語は、qokain、qol、qokeedy、okeol といった同じ部分語の族に属しており、内容語彙に似たものには属していない(S: v_a6)。
08 仮説の現状
除外
- 検定した11言語の平文または単一アルファベット換字:h2 の差は生で少なくとも1.0ビット、統合後で少なくとも0.4ビット(S: a1, v_a1; L: Bennett 1976, Zandbergen, Lindemann & Bowern 2021)。
- 換字に母音除去または慣用の略記を加えたもの(S: a1, a5; L: Lindemann & Bowern 2021)。
- 実際の平文の文字レベルの転置。グリルによる並べ替えを含む(S: v_a5; L: Parisel 2026)。
- ヴィジュネル型の多表式暗号(L: D’Imperio 1978, Stolfi 2000)。
- 冗長性の原因としての単一字形の冗字(S: a5)。
- 名前の挙がった解読:Cheshire 2019(査読者によって反駁された)、解読として読まれた Hauer & Kondrak 2016(著者自身の但し書きがある)、Bax 2014、Gibbs 2017、Ardic、Gladyseva 2023、Schechter 2025、そして2025–2026年の LLM の助けを借りた読み。再現可能な鍵はなく、盲目的な適用に耐えたものはない(L)。
- 近代の偽作(L:放射性炭素、インク、来歴)。
不利*
- 暗号化されていない珍しい言語:公表されている最も近い h2 はハワイ語の2.77であり(L)、スロットの文法には類例がない。
- 仕組みとしての Rugg の表とグリル:カルダノ・グリルは1550年頃のもので、羊皮紙の1404–1438年より新しい。f と p の特別な役割は表からは生じえず(L: Zandbergen 2021)、このセッションのグリルは Zipf とハパックスで失敗する(S: a4)。
- ここで実装した自由編集型の自己引用:局所性と語彙を過剰に生み出し、文字の冗長性を過少に生み出す(S: a4, v_a4; 第06節)。
- ディーとケリーの異言(L: Daruka 2020)。羊皮紙の年代と矛盾する。
存続
- (a) 短い単位の冗長暗号またはスロット型テンプレート暗号、ノーメンクレーター、あるいは意味をもつ人工言語。第03、05、07節と両立し、主要な統計量のいくつかを再現する、手作業で実行可能な15世紀の設計とも両立する(L: Greshko 2025、Naibbe 暗号; Bowern & Gaskell 2022)。さらに語長の制約(冗長暗号の対照は7.6から11.5記号を与える; S: v_a1)、トークン間の予測可能性がほぼゼロであること(L: Rozanova & Temerev 2026、プレプリント)、行頭の効果(S: v_a2)も満たさなければならない。
- (b) スロットを保存するコピーと修正による生成(L: Timm & Schinner 2020, 2023; Timm 2026)。測定したすべてと両立するが、スロットの文法はそのモデルの入力であって産物ではなく(S: a3)、ページ、セクション、書き手の構造に対して写本の長さで走らせた実装はまだない(L:3回の調査すべて)。
- (c) 語ではない分割のもとにある実在の言語。未検定(S: v_a3)。
09 物理的証拠が加えるもの
すべて (L)。4丁の放射性炭素年代:1404–1438年(Hodgins、アリゾナ大学、2009年)。全体を通じて没食子インクと当時の顔料(McCrone 2009; Yale 2014)。5人の書き手がおり、そのうち3人が227ページ中188ページを書いており、1つの書記体系を共有している(Davis 2020)。ロマンス語方言の月名と、f116v にあるドイツ人の筆跡の書き込みから、数十年のうちにドイツ語話者とフランス語/オック語話者の手元にあったことが分かる。10丁のマルチスペクトル画像(2014年撮影、2024年公開)は、f1r の消されたアルファベットの試し書きと Tepenecz の蔵書票を復元したが、新しいヴォイニッチ文字は復元しなかった。来歴は1600年頃のプラハから Baresch(1639年)、Marci(1665年)、キルヒャーを経て1912年に至る。
帰結は対称的である。無意味なテキスト説は、1420年代に新しい子牛皮紙の上で、複数の書き手が協力し、200ページ以上にわたって1つのスロット文法と1つの A/B スイッチを一貫させて作ったものでなければならない。その手間にはどんな統計も答えていない。暗号説は、なぜ主題ではなく書き手が言語を決めるのかを説明しなければならない(第07節)。
10 残りを決着させるには
- 写本の長さでの、事前登録した生成器の比較試験:自己引用、表とグリル、Naibbe 暗号化したラテン語、人間のでたらめ書きを、1つの検定群のもとで比べる。そこには Montemurro–Zanette の長距離キーワードのピーク(L: 2013)、主題と挿絵と書き手の同時クラスタリング、隣接ページの類似度、A/B の分離可能性、f と p の規則、トークンの予測可能性を含める。スクリプト a1 から a6 は、TSV 形式の任意のテキストに対する部分的な検定群である。
- 写本の長さの人間のでたらめ書きを、挿絵とセクションを付けて数週間かけて書くこと。Gaskell & Bowern(2022年)が名指しした未実施の検定である(L)。
- 挿絵とテキストの相互情報量を、書き手、折丁、隣接性の影響を除いて測ること。
- 確実な空白のみでの再トークン化、そしてラテン語とイタリア語の音節分割に対する同じ統計。第02節で残った隙間を埋めるためである。
- 主張されたどの鍵についても:第三者が A の5丁と B の5丁に盲目的に適用し、字形をシャッフルした対照実験と比較すること。
11 確認済み、未確認、要検証
確認済み。 a1 から a6 の主要な数値はすべて、独立した再実装 v_a1 から v_a6 によって再現された。Levenshtein のコード、エントロピーの式、推定量の偏り、コーパスの内容、Gutenberg の定型文も含む。ZL、RF1b、IT2a、GC2a、CD2a にわたる頑健性。適用した訂正:単一の書物の標本。ラテン語の語のエントロピーは韻文ではなく散文から。畳み込み後の下限3.32。硬直性の比は1.7から2.3。過小分散は Currier B の性質。行末の効果は m/g の異体字。A/B の規則は一個抜きで99.5%。
未確認。 有料の Cryptologia の全文(Rugg 2004、Schinner 2007、Timm & Schinner 2020 と 2023、Daruka 2020、Greshko 2025)は、要旨と二次的な要約から特徴をつかんだ。高次のエントロピーや書き手ごとのエントロピー、A 対 B の有意性検定、ブートストラップ区間は計算していない。より高いレベルの文献上の統計量(Montemurro–Zanette のピーク、トピックモデル、隣接ページの類似度)は再計算していない。Davis の書き手の割り当ては IVTFF のヘッダーから採った。放射性炭素、インク、書き手、1639年の書簡以外の物理的証拠、たとえばインクの層、顔料の順序、折丁の順序は調べていない。
引用する前に利用者が検証すべきこと。 コーパスの選択(Gutenberg の単一の書物、ラテン語を約8%含む OCR のイタリア語コーパス、韻文と散文のラテン語)、字形の統合リスト、24記号の冗長暗号の対照の設計、不確かな空白を区切りとして扱ったこと、そして除外、不利、存続というラベル。2つの数値が複数の形で現れる。統合後の h2 はエントロピーの表では2.870、比較試験の表では2.646である。隣接反復率は硬直性の表では0.907%、比較試験の表では0.0082、基準では0.81%である。ノートはこれらを整合させていない。統合リストとトークンのフィルタの違いが原因である可能性が高く*、それは次の場所にあるスクリプトごとの JSON で確認できるだろう: results/ 。すべての出力は、レビューを経るまで検証されていない。
12 ファイルと再現
すべては次の場所にある: targets/voynich/. parse_ivtff.py は IVTFF を TSV に変換する。 data/ZL3b-n.words.tsv は解析済みの主転写である。生のファイルは voynich.nu/data からブラウザのヘッダーを付けて取得した。サーバーは素の curl を拒否する。 baseline.py と baseline2.py は独立した基準である。検定: a1_charstats.py, a2_wordstats.py, a3_wordgrammar.py と a3_supplement.py, a4_selfcitation.py, a5_cipher.py, a6_structure.py。再実行: v_a1.py to v_a6.py. results/ にはスクリプトごとの JSON と Markdown、および生成器の標本がある。 NOTES.md はこのページが要約した裁定である。 SOURCES.md は5回の文献調査である。