01 档案
JACAR B03050731500 是外务省关于反袁起义的一卷档案(1.6.1.75-1_015,胶卷1-0955,第0244–0302帧)。附函为電送第一九八〇号,密码,由外务大臣石井于1916年5月25日下午4时35分发给驻肇庆领事 Ōta,用日文明文说明了附件是什么:
黄興ヨリ林虎李根源宛電報依頼アリタルニ付同人ニ伝達アリタシ 内容ハ先日来電ノ挨拶ナリ(以下支那側暗号)
“黄兴请求向林虎、李根源发一份电报,请转交他们。内容是对日前来电的答复。(以下为中方密码。)”
要紧的是三帧:0246,印在帝国政府电报局转发电报用纸上的电报;0247,标题为電稿,是草书写的中文译文;0248,一名书记员在外务省用纸上把译文改排成日语语序的版本,附有他自己的注释。
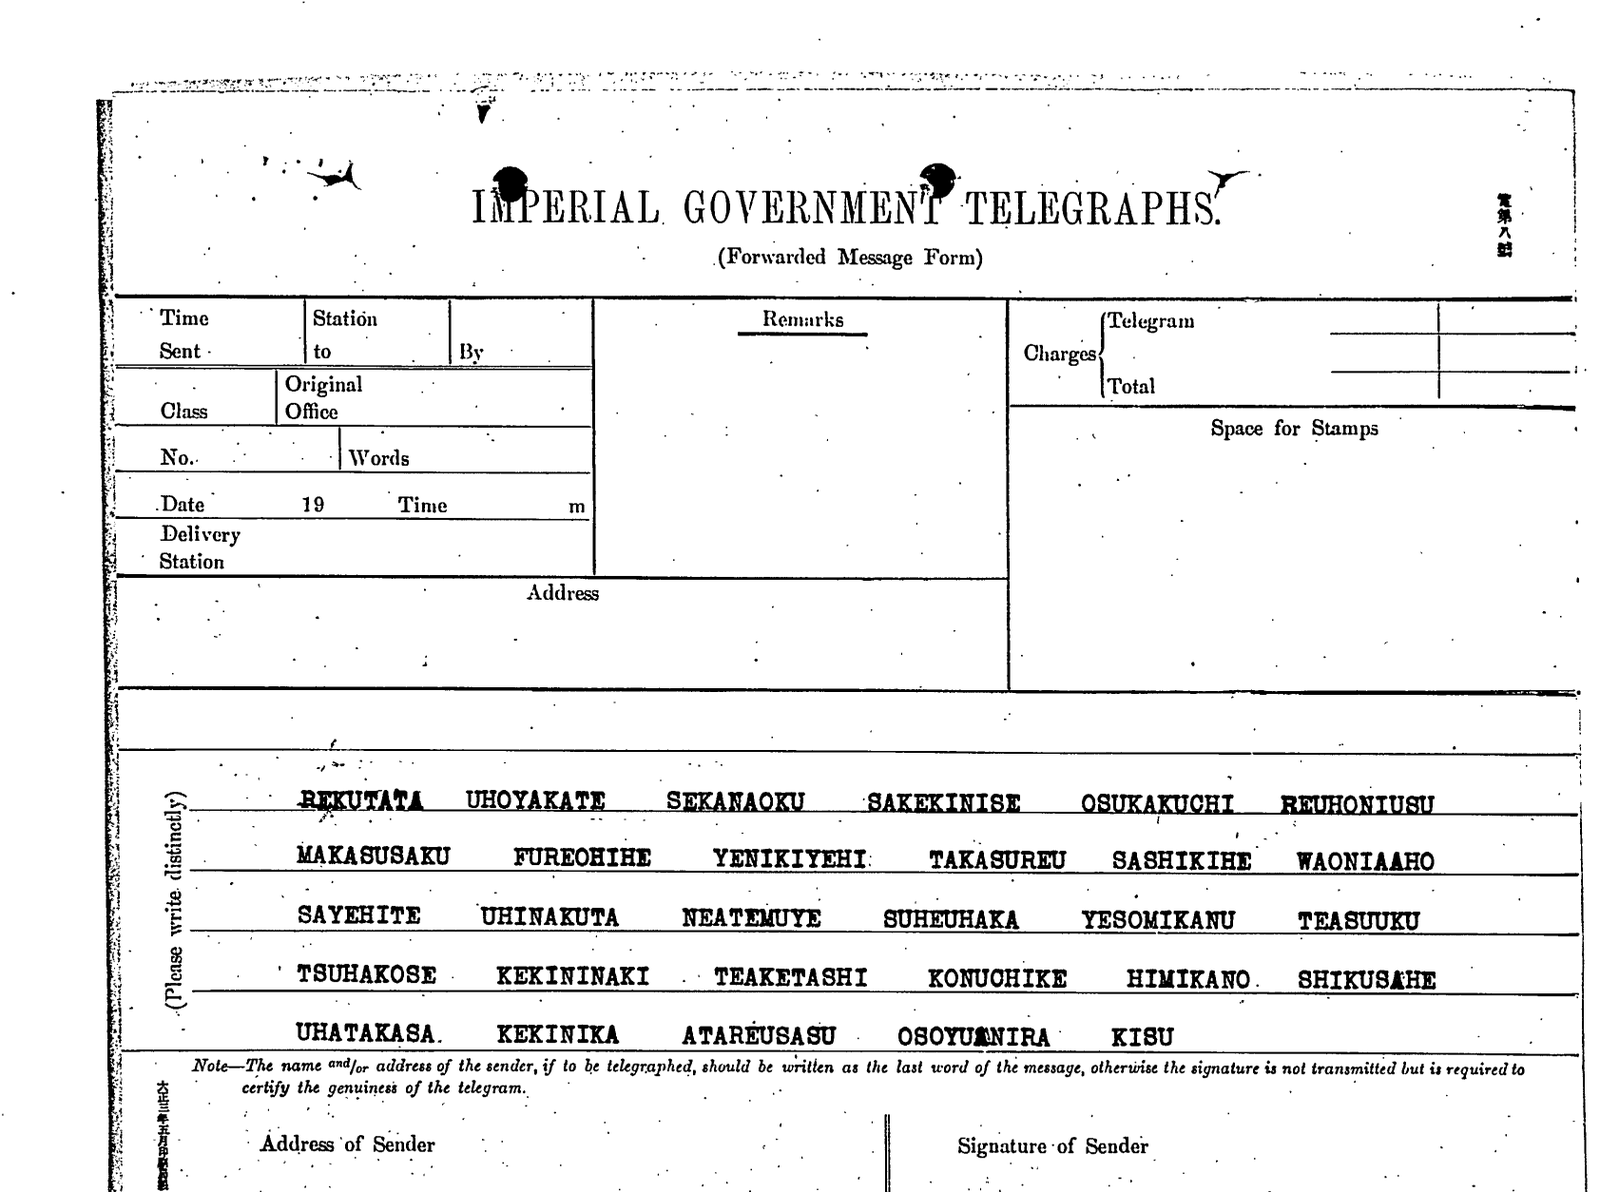
REKUTATA  UHOYAKATE  SEKANAOKU  SAKEKINISE  OSUKAKUCHI  REUHONIUSU
MAKASUSAKU  FUREOHIHE  YENIKIYEHI  TAKASUREU  SASHIKIHE  WAONIAAHO
SAYEHITE  UHINAKUTA  NEATEMUYE  SUHEUHAKA  YESOMIKANU  TEASUUKU
TSUHAKOSE  KEKININAKI  TEAKETASHI  KONUOHIKE  HIMIKANO  SHIKUSAHE
UHATAKASA  KEKINIKA  ATAREUSASU  OSOYUANIRA  KISU
按假名读,这是139个音节,其中36个各不相同。完全没有浊音假名(没有ga、za、da、ba),这在电报通信中很正常,因为浊音符号根本不传送。这些音节是日语的(SHI、CHI、TSU,以及旧式的 YE 和 WA),而不是六周前发给孙中山的汕头电报所用压缩码中的辅音-元音字母。
02 外务省的译文
第0247帧是译文:标题電稿,下面四列,分别为12、11、12和11个字,共四十六个字的电文。第0248帧是为日本读者重新排列的同一文本,它是两帧中更有用的一帧,因为书记员在没有把握的地方加了注释。
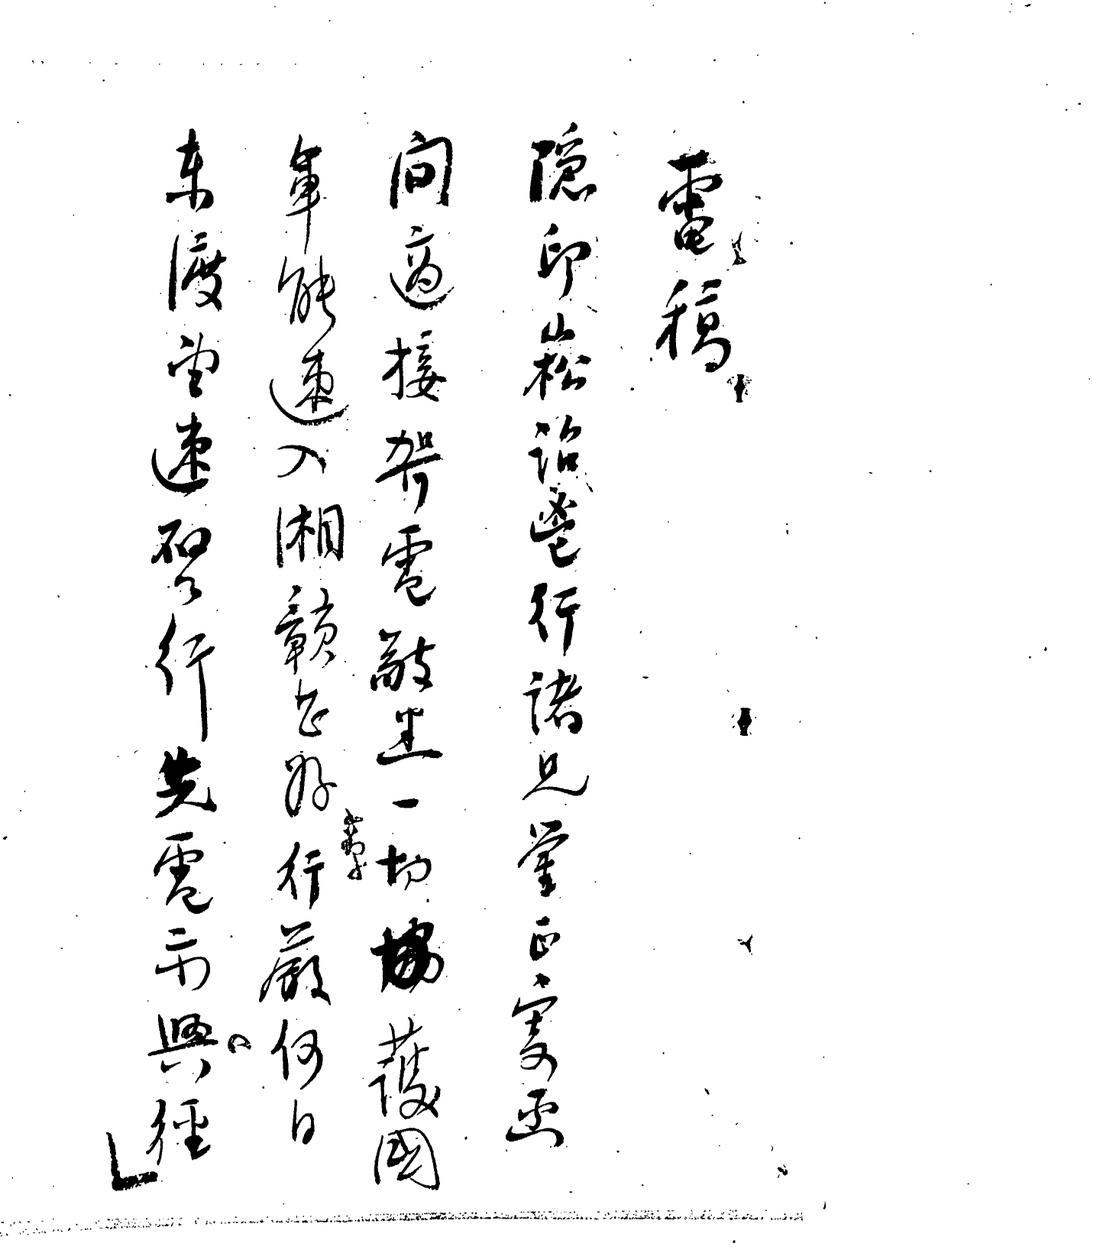
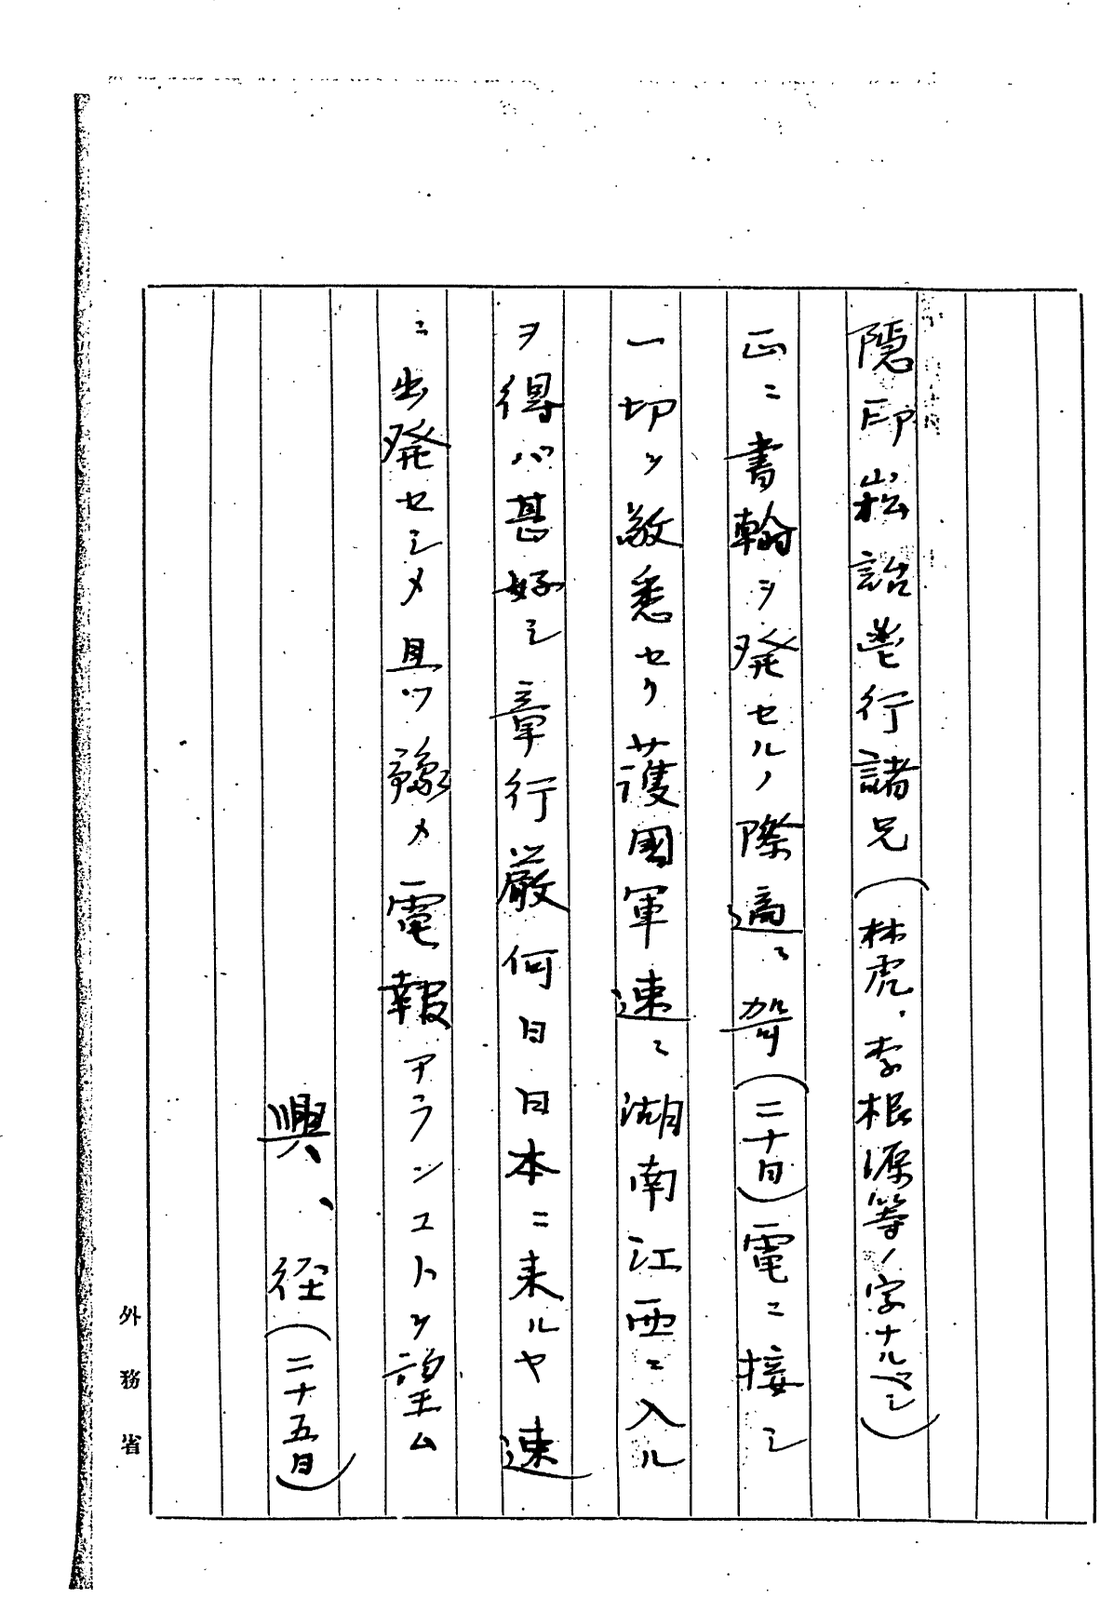
隱印崧蕘邕行諸兄鑒:正發書翰之際,適接哿電,敬悉一切。護國軍能速入湘贛甚好。章行嚴何日東渡?速令出發,並望預電。興 徑
“致 Yin、Yin、Song、Yao、Yongxing 诸兄:正要发信,适接二十日来电,一切敬悉。护国军若能迅速进入湖南、江西,甚好。章行严何日东渡日本?望令其即刻启程,并请预先电告。——兴,二十五日。”
大部分身份的确认都来自书记员的注释。在开头那一串名字旁,他写了林虎・李根源等ノ字ナラン,即“大概是林虎、李根源等人的字”;他也是在猜,而其中一个肯定是蔡锷的字松坡。他把湘贛注为湖南江西,即湖南和江西;把東渡注为日本ニ来ル,即来日本。章行嚴就是章士钊,黄兴的亲密同志。有两个字是日期,用的是中文电报中表示日期的韵目代日:哿 = 20日,徑 = 25日。署名的最后一个字徑,与附函上的发电日期完全吻合。这一吻合是证明这份译文属于这份电报的最好的单项检验。
更正,第二轮。上面的连贯文本是书记员根据第0248帧所作的意译(50字)。在500 dpi 下检视第0247帧上的草书,共46字:隱印崧誥邕行諸兄鑒正發書 · 間適接哿電敬悉一切護國 · 軍能速入湘贛甚好[章]行嚴何日 · 東渡望速啓行先電示興徑,其中章是行间补写的。这一字数与46个假名三元组恰好吻合;见第03节。
草书中有几个字形仍不确定,这里是综合两帧给出的。各列字数为 2 + 12 + 11 + 12 + 11;Tomokiyo 的笔记给出了同样的数字,却把它们加成68,实际相加是48。
03 方案
四十六个字对应138个可用假名,就是每个字三个假名,末尾多出一个假名。这确定了比率。问题在于每个假名的哪一部分在起作用,而五十音图的形状回答了这个问题:它是一张十个辅音行乘五个元音的网格。
如果辅音行承载一个数字,而元音可以自由选择,那么明文中重复出现的字,会重复为同一组行的三元组,但不一定重复为同一组假名的三元组。这是一个可检验的预言,而计数结果毫不含糊。在46组中:
| 读解 | 观察到的重复 | 随机预期 | 置换检验 |
|---|---|---|---|
| 辅音行 | 7 | 1.03 | p = 0.006 |
| 元音 | 8 | 8.28 | p = 0.70 |
| 字面假名 | 1 | — | — |
辅音行重复了七次,而随机预期只有一次。元音重复了八次,随机预期也是八次:在这种分组下,元音不承载任何信息。而表面的假名,也就是截获者实际看到的东西,在四十六组中只重复了一次。机制在这些重复的组本身中清晰可见,同一个字被拼成两种不同的样子:
S K N → SE-KA-NA 和 SHI-KO-NU
R — H → RE-U-HO 和 RE-O-HI
T — H → TA-U-HO 和 TE-U-HI
S K H → SA-KU-FU 和 SHI-KI-HE
那是最初的分析,而这些帧纠正了它。重新获取并在500 dpi 下检视后,第0247帧在标题之后有四列,分别为12、11、12和11个字,共46个,正是假名三元组的数目:
隱印崧誥邕行諸兄鑒正發書 · 間適接哿電敬悉一切護國 · 軍能速入湘贛甚好[章]行嚴何日 · 東渡望速啓行先電示興徑
上面早先那段50字的明文依据的是书记员在第0248帧上的日文意译;草书原文有46个字,章是行间补写的。这段明文中,行重复三次(位置6、32、41),速重复两次(26、39),電重复两次(17、43)。在上面的分组下,这几对中只有一对吻合。去掉第106位的一个假名,即第36个字开头 OHIKE 中的 O,从那里起的每个三元组都移动一位:行三次都成了 KE-KI-NI,速两次都是 HE-U-HA,電两次都是 RE-U-SA,末尾多出的 SU 则补全了最后一个字。归档的电报多了一个假名,而这种代码是确定性的:同一个字总是同样的三个假名,元音也不例外。
因此,表中的七次辅音行碰撞并不是同一个字用不同元音写出。移位之后,它们是若干对不同的字(印/護、誥/日、鑒/間、書/敬、國/嚴、甚/何、諸/示),共享同一组行三元组,只在元音上不同。元音承载信息。最初分析中保留下来的,是比率,即每字三个假名,以及假名所在的行与其代码值相关这一事实;行碰撞超出随机预期的部分,正是这种相关性从外部看上去的样子。在50个假名的音节表上,三个假名可以寻址125,000个条目,远多于任何私人代码本;最自然的解释仍然是一种三位数代码,每一位数字写成一组假名中的一个,只是这些组并不是行。
对此做过一次检验,结果失败。如果这些行是一本按字典顺序编排的代码本的数字,那么十个行的某种置换,应能使42个不同字的代码号按标准电码顺序单调排列。在全部3,628,800种置换中,最好的 Spearman rho 是0.524;对明文做十二次随机打乱后进行同样的搜索,得到的零假设分布均值为0.468,最大值为0.614。没有信号。
04 仍未解决的部分
- 假名到数字的对照表。行并不是数字,而46个字不足以确定36个假名到十个值的分配。
- 这份电报所确定的42个条目(字到假名三元组)之外的代码本内容。
同一代码的第二份电报可以解决这两个问题。这一份解决的是方案、明文,以及那个掩盖了重复的传输错误。
05 来源
- JACAR(Japan Center for Asian Historical Records,亚洲历史资料中心),Ref. B03050731500,袁世凱帝制計画一件(極秘)/反袁動乱及各地状況 第十五巻,日本外务省外交史料馆,1.6.1.75-1_015,第0244–0302帧。
- S. Tomokiyo,“Chinese Cryptography: 1871–1945”和“Unsolved Historical Ciphers”;以及他的博客文章“Chinese Coded Telegram (1916) from Huang Xing”,其中报告了归档的译文和初步分析。
- 用仓库中的
targets/sunyatsen/huang.py可复现这些统计;密文就在脚本里,无需任何数据文件。