一览语言未破解 · 不懂语言也有41.8%的记号能读出意义
- 文本
- 约1,400件来自克里特和爱琴海地区的米诺斯铭文,约公元前1800–1450年:账目泥板、封泥,以及刻在石器上的祭品铭文。工作语料库共有1,722条记录。
- 藏地
- 大部分藏于伊拉克利翁考古博物馆。校勘本为 GORILA(Godart 和 Olivier,1976–85年)。这里使用的数字文本是 Robert Hogan 的 lineara.xyz 和 SigLA 数据库。
- 文字
- 约90个音节符号,是线形文字B的前身,另有表示物品的表意符号、数字和分数符号。它记录的是一种未知语言。它不是密码:没有人想隐藏什么。
- 研究经过
- 先检验线形文字B的音值能否沿用,并与随机零假设比较。然后为每个记号指定一种功能,用分数重新核对全部35个合计,并在各遗址之间对齐奠酒套语。
- 内容
- 按人名和地名开列的人员、谷物、葡萄酒、油、橄榄和无花果清单,附有总数和亏欠数。可识别出三个地名:Phaistos、Sybrita 和 Setoija。供奉器皿上还有一个固定的献辞程式。
- 新发现
- 三项发现,详见第09节。泥板 HT 34 与两个分数符号的已发表数值相矛盾。被提出的闪米特语和卢维语亲属,与线形文字A的吻合程度并不比夏威夷语或约鲁巴语更好。在线形文字B中再次出现的线形文字A词语都是名字,而且全部出现在克诺索斯。
- 最佳推测
- 一个地区中心的日常账目:向具名的个人和工作队征收、发放的基本物资,并记录短缺(第06节,解释)。
- 尚未解决
- 语言本身,以及新发现、尚未正式刊布转录的克诺索斯权杖。所有不是数字、物品、总数或地名的词的含义,占词符的40.5%。未识别的符号,以及分数符号 H 和 A。
01 线形文字A是什么,“读懂”它可能意味着什么
线形文字A是米诺斯克里特的文字。迈锡尼希腊人把它改造成线形文字B,后者在1952年由 Michael Ventris 破译。那次破译之所以成功,是因为线形文字B记录的原来是希腊语,一种已知的语言。线形文字A与线形文字B共用大部分符号,所以其音值可以沿用过来。结果是能读出声,却无法翻译:它背后的语言没有已知的亲属,也没有任何文本用一种已知语言给出相同的词。
所以这不是密码问题,本项目衡量完整结果的常用标准(95%的文本读得通)无论用什么方法都达不到。能做的事更窄,但可以检验:
- 检验沿用过来的音值是否真实;
- 读出所有含义不依赖于语言的内容,即数字、分数、物品象形符号和记账术语;
- 核对算术;
- 描述剩余部分的结构。
本页报告在整个语料上完成这四步的结果,每一步都有一项量度。
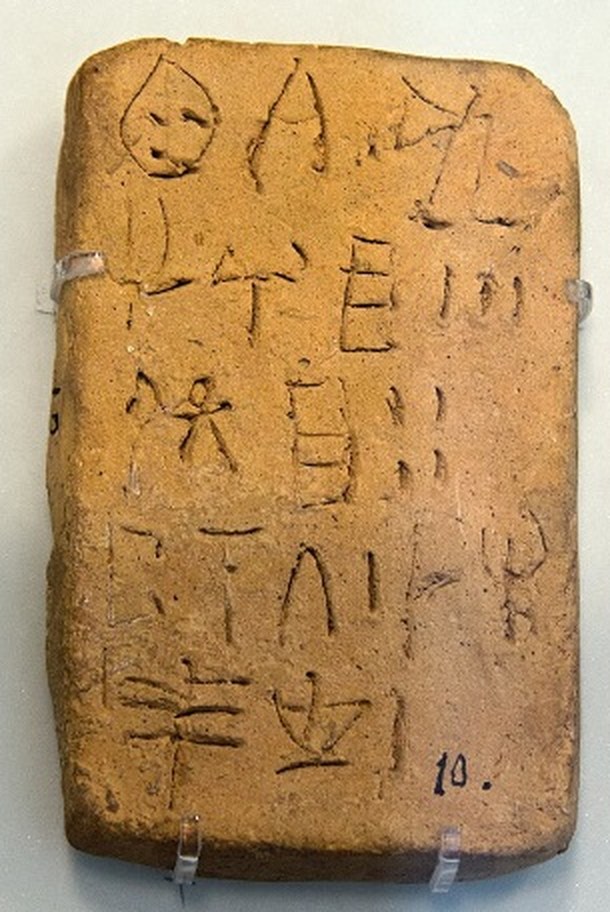
02 音值可以沿用,米诺斯人名在克诺索斯留存下来
如果线形文字B的音值只是贴在线形文字A上的随意标签,那么线形文字A的词与线形文字B的词只会偶然吻合。检验取线形文字A全部491个三符号及以上的词型,与919个有希腊语同源词的线形文字B词(含地名;NeuroDecipher 词表,Luo et al. 2019)比较,统计完全吻合的数量。然后在频率相近的线形文字A符号之间打乱音值,重复2,000次,再数一遍吻合数。
| 线形文字A | 线形文字B / 希腊语 | 在线形文字A中的出处 |
|---|---|---|
| PA-I-TO | pa-i-to,Phaistos | HT 97a, HT 120 |
| SU-KI-RI-TA | su-ki-ri-ta,Sybrita | PH Wa 32 |
| SE-TO-I-JA | se-to-i-ja,Setoija | PR Za 1 |
| A-RU-RA | ἄρουρα,耕地(?) | HT 11a |
| I-JA-TE | i-ja-te,医生(?) | PH Zb 4 |
| DA-MA-TE | da-ma-te,得墨忒耳(?) | KY Za 2 |
真实吻合6个,随机平均为0.49;2,000次打乱中只有1次达到6个(p ≈ 0.001)。音值确实可以沿用。把检验放宽到词干相同、仅末符号不同的词,得到35个吻合,期望值25.4(p 0.09):毫无意义。六个吻合中有三个是克里特岛上的地名,任何语言都会共用。491个词中只有三个普通词吻合,所以线形文字A不是希腊语,这也是公认的看法。
辅音行是真实的。对音值的第二项检验完全不需要已知词。线形文字B归入同一辅音行的符号(NA、NE、NI、NU;RA、RE、RI、RO、RU),在线形文字A词中的上下文比不同行的符号更相似(p = 0.0005),效应大小与线形文字B本身相当。把辅音和谐和词首元音排除在比较之外,结论依然成立;在 Haghia Triada 和其他遗址分别检验也成立。Q、N、R 三行的聚合最清楚。唯一不聚合的是 Z 行(ZA、ZU),它在线形文字B中也是最不确定的一组,所以米诺斯语音值最可能在这里有所不同。同样的方法能从上下文复原被隐藏符号的元音(42%,随机为20%),却复原不了辅音,因此暂时还不能为未读符号赋值。一种在线形文字B中能复原27%辅音的最近邻方法,在线形文字A中只得到随机水平:辅音行信号平均而言是真实的,但在这个语料上太弱,无法定位任何单个符号。
关于元音的一条线索。在线形文字B中,同一行的 e 符号与 i 符号(TE 和 TI、KE 和 KI)在上下文中明显不同,o 符号与 u 符号也是如此。在线形文字A中它们却偏向相反的方向,两种文字之间的差异很显著(e/i 为 p = 0.003,o/u 为 0.014)。这符合一种 e 和 o 处于边缘地位的米诺斯元音系统,o 符号的稀少本来就暗示了这一点。这是一项探索性比较,而且线形文字B中的部分对比来自希腊语的格词尾。后来在新数据上的检验发现,这些元音是稀少,而不是可以互换(见人名一节)。
克诺索斯的米诺斯人名。用同样的检验对照整个线形文字B词汇:取自 linearb.xyz 语料的4,164个词型,每个都按 Chadwick 和 Ventris 词汇表标有类别。结果是13个吻合,期望值2.8(p 0.0005),并且按类型干净地分成两类:
- 名字,全在克里特。凡是与线形文字B名字吻合的线形文字A词,对应的都是只见于克里特、出自克诺索斯的词。地名有 PA-I-TO、SU-KI-RI-TA 和 SE-TO-I-JA。人名有 DA-I-PI-TA(Zakros)、I-TA-JA(HT 28a)和 KI-DA-RO(HT 47a、HT 117a)。线形文字B名字中有一半(51.3%)只见于克里特,所以六个全中的偶然概率为 p = 0.018。
- 另有两个克诺索斯词在线形文字A清单中表现得像名字。TA-NA-TI 出现在四块泥板上,包括上面展示的 HT 7a 人员清单;PA-RA-NE 出现在 HT 115 上。
- 普通词,在大陆。只见于大陆的线形文字B词是 Pylos 的希腊语普通词,如 ma-te-re“母亲”和 i-ja-te“医生”。它们是第07节所量度的那种偶然的形似。
线形文字B记录中留存下来的米诺斯词汇是名字,而且只在克诺索斯。独立查询奥斯陆的数据库 DAMOS 得到同样的结果:13个吻合中的12个,以及同样的克诺索斯与大陆之分。它还显示这些名字在两种文字中起着同样的作用,都是个人名单中的条目。TA-NA-TI 在 HT 7a 人员清单中与1并列,在克诺索斯则出现为“ta-na-ti, DA 1”(KN Uf 311)。同样,I-TA-JA 出现为“i-ta-ja MUL 1”,即一名女子(KN Ap 769),PA-RA-NE 出现为“pa-ra-ne 1”(KN Vc 7616)。需要提醒一点:SigLA 把 Phaistos 陶片 PH Wa 32 读作 SU-KI-RA-TA,而不是 SU-KI-RI-TA,所以 Sybrita 这一吻合取决于 GORILA 对其中一个符号的读法。
完全吻合之外。克诺索斯人名的整体在形态上是米诺斯式的。逐音节比较,637个只见于克诺索斯的线形文字B人名,比339个只见于 Pylos 的人名更接近358个线形文字A清单人名(全部、首音节和末音节均为 p = 0.0002)。去掉完全共有的名字后结果依然成立,对 Haghia Triada、Zakros 和 Khania 的线形文字A人名分别检验也成立。普通词汇在克诺索斯和 Pylos 之间没有这种差异,所以这是名字的特征,而不是克诺索斯拼写的特征。名字最具米诺斯形态的克诺索斯书吏,也最常使用没有公认音值的线形文字B符号(23名书吏之间 rho = 0.48)。第二个迹象指向同一方向。线形文字A很少用 o 音节(不到3%),而在词内部,克诺索斯人名用 o 音节比 Pylos 人名少(12%对17%)。e 也一样:线形文字A很少用 e 音节(10%),克诺索斯人名用得比 Pylos 人名少(16%对26%,p = 0.0005),而普通词汇中没有这种差距。克诺索斯的米诺斯人名同时带有线形文字A的两种元音短缺,克里特地名也是如此:去掉希腊语词尾后,只见于克诺索斯的地名有21%的音节用 e 或 o,Pylos 为42%(p = 0.0005)。在线形文字A本身中,e 和 o 大多出现在词尾(NE、ME 和 TE 三次中有两次在词末),仿佛米诺斯语主要在后缀中使用它们。它们还取决于辅音:e 和 o 跟在 Q、R、T、S 之后远比跟在 P 或 J 之后常见,从不跟在 W 或 Z 之后,这种依赖比线形文字B强四倍。综合来看,舌冠辅音(T、D、N、R、S、Z)之后有22.5%的音节接 e 或 o,其余辅音为12.4%,即便在词内部也如此。这条规则对 e 单独成立,在 Haghia Triada 以外和清单人名中也成立,而且起作用的是同一音节的辅音,而不是下一个音节的。去掉最强的符号(RE)后它依然成立,在只出现一次的词中和首音节中也成立,所以它不是少数几个词或词尾造成的。不过逐个辅音来看,它比“齿音”要窄:e 和 o 在 Q 之后最常见(一半的情况),其次是 R(37%)和 T(28%),然后是 S 和 N,而 D 一直偏低,W 和 Z 从不接它们。实际上,米诺斯语的 e 和 o 主要出现在 R 和 T 之后,在那些位置上其他音节用的是 i 和 u。在 R 和 T 之后,线形文字A把音节分布在全部五个元音上;在其他辅音之后,它用的范围更窄,接近三个元音(a、i、u)。线形文字B没有这种差异。逐个辅音来看,T、R、S、N 和唇软腭音 Q 接 e 和 o,而 K、P、M、J 和 W 避开它们。按线形文字A的拼写,米诺斯语的词也都是由简单的辅音加元音音节串成的:两个元音符号从不相连,以纯元音符号结尾的词很少(4%,线形文字B为10%),QA、QE 和 QI 多在词首(57–62%,线形文字B为28%)。相邻音节也倾向于共用一个辅音(TA-TI、KU-KA),比线形文字B更多,在每个遗址和清单人名中都是如此。所有这些在两种转录上都成立,而 Q 和词末元音的习惯在克诺索斯人名中也再次出现。元音模式在 SigLA 的转录上得到重复,在 Zakros 也成立,但在 Khania 不成立,Khania 在符号和合体字上也自成一格。这条规则在宗教献辞和泥板中都成立。它在每个有足够词量的遗址都成立(Haghia Triada、Khania、克诺索斯、Palaikastro、Phaistos、Zakros),在 SigLA 的独立转录和 lineara.xyz 上都成立,辅音行也是如此。有一条线索认为希腊书吏把以 -u 结尾的米诺斯名字改成了 -os(DI-DE-RU 与 di-de-ro),单独检验时没有站住:以 -u 结尾的线形文字A词,找到以 -o 结尾的克诺索斯人名的频率,并不比以 -a 结尾的词高。宗教词以 -TE 结尾的频率是行政词的两倍(A-DI-KI-TE、I-DA-MA-TE,对应山名 Dikte 和 Ida)。在线形文字A之外,希腊语中的前希腊底层词也有同样的特征,其词干中的 e 和 o 比普通希腊语词少(p = 0.0005),而埃特奥克里特语也很少用 o。不过前希腊词并没有舌冠模式,也没有线形文字A的辅音特征,所以相似之处只在元音短缺。而 e 和 o 短缺在世界语言中很常见,因此它能描述米诺斯语,却无法确定它的语系。不过这些拼写中 e 与 i、o 与 u 的互换并不比随机更多,所以证据表明的是米诺斯语的 e 和 o 很少见,而不是与 i 和 u 合并了。
这条元音规则有多罕见。我们把这条规则与104种欧亚语言(NorthEuraLex,Dellert et al. 2020)作比较,每种语言都按线形文字B拼写希腊语的规则重新拼写:辅音并入线形文字A的各行,辅音丛拆开,词末辅音去掉。104种语言中,没有一种把 e 和 o 与前面辅音的关联绑得像线形文字A那么紧(T、R、S、N、Q 对 K、P、M、J、W 的对数优势比为1.22)。最接近的是高加索的拉克语(0.99),而只计 R 和 T 时,拉克语超过了线形文字A。把每种语言都削减到线形文字A的样本量,或换用第二种拼写规则,结果依然成立。所以这条规则虽然极端,却能在自然语言中找到,不必是书吏的习惯;线形文字B对希腊语的拼写并不会产生它。这项比较不指向任何语系或地区:线形文字A最接近的特征分布很分散(拉克语、爱沙尼亚语、曼西语、埃文基语、满语),接近程度也与离克里特的距离无关。这个方法很粗糙:按线形文字B的方式拼写希腊语时,它把现代希腊语只排在104种中的第五位。
这种痕迹不只在名字里。克诺索斯线形文字B整体的音节使用频率比 Pylos 更接近线形文字A。含有无公认音值的线形文字B符号(*18、*47、*56 等)的词,在克诺索斯大约多三倍。线形文字A的宗教词(不只是名字)也更像克诺索斯人名而非 Pylos 人名,去掉奠酒程式中的词后依然如此。对50个假设同时检验作校正后,以上每一项都依然成立。人名的结果还能做样本外预测:一个从未见过克诺索斯人名的模型,在未参与训练的 Pylos 人名上检验,仍能把克诺索斯人名挑出来判为更具米诺斯特征(AUC 0.59,p = 0.0025),而对两地的普通词则区分不开。这与线形文字A词的来源无关。只用 Haghia Triada 以外遗址的名字训练的模型表现一样好(AUC 0.61),只用宗教词、完全不用名字训练的模型也是如此(AUC 0.60)。用无公认音值符号拼写的词,在其他音节上也呈米诺斯形态。
对比的对象不只是 Pylos。按去掉词尾的词干打分,并使用一个从未见过 Pylos 人名的模型,克诺索斯人名也比底比斯、迈锡尼和梯林斯的46个人名更具米诺斯特征(AUC 0.63,p = 0.0025),而只见于克诺索斯的人名又比同样见于大陆的克诺索斯人名更具米诺斯特征。有一点局限:克诺索斯最早的档案,即 Room of Chariot Tablets,并没有比后来的堆积含有更多米诺斯人名;如果说有差别,反而更少。
许多克诺索斯词看起来像米诺斯词干加希腊语词尾。只见于克诺索斯的词是“一个线形文字A词再加一个音节”的频率是 Pylos 词的两倍多(7.8%对3.4%)。在人名中,加上的音节是典型的希腊语词尾,例如线形文字A的 A-DA-RA 对应 a-da-ra-ro。米诺斯信号在这些词干里,而不在词尾:克诺索斯人名以 -o 结尾的频率其实比 Pylos 人名更高。有两点提醒。这些词干是普通的线形文字A词,并不特别是线形文字A的名字。与底比斯、迈锡尼和梯林斯相比,克诺索斯的超出量很小且不显著(7.8%对6.4%),所以对比的一部分源于 Pylos 偏低。
03 读账目
一个脚本(targets/lineara/reading/build_reading.py)为语料中5,339个词符(不计分隔符和残损标记)各赋予一个类别。释义只保留有明确依据的:
- 物品象形符号:GORILA 的标注(谷物、葡萄酒、油、橄榄、无花果、人、山羊、莎草),依据是同一符号在线形文字B中的含义。
- 分数值:采用 Corazza et al. 2021,第04节有异议的两个除外。
- KU-RO:“总数”,本文作了检验。
- PO-TO-KU-RO:“总计”。
- KI-RO:“亏欠”。它作为清单的标题,再由 KU-RO 汇总(HT 88、94b、117a)。在 HT 34 上它跟在一次减法之后:100 − 70 = 30。
| 类别 | 符号单元 | 分享 |
|---|---|---|
| 读出意思:数字、分数、物品、KU-RO / PO-TO-KU-RO / KI-RO、三个地名 | 2,232 | 41.8% |
| 只读出读音、仅知功能:清单条目、标题、程式用词、封印标记 | 2,164 | 40.5% |
| 未读出:未识别的符号和合体字(*301、*308……)、含有这类符号的词、有争议或未定值的分数 | 943 | 17.7% |
若按符号而非词符计,有32.1%读出了意思。HT 88 展示了在这个层次上的读法是什么样子:
A-DU[标题],VIR+KA[人]20:RE-ZA 6,KI-KI-NA 7。KI-RO[亏欠]:KU-PA3-PA3 1,KA-JU 1,KU-PA3-NU 1,PA-JA-RE 1,SA-MA-RO 1,DA-TA-RE 1。KU-RO[总数]6。
像这样的条目有66条,都是短词配上少量人数,被标为可能的人名。一个在多块泥板上作为条目反复出现的词,有18%的情况出自同一书吏之手,随机只有4%,所以书吏各自掌管自己的人员或部门。书吏还在物品和交易术语(SA-RA2、KA-PA、A-DU)上各有专攻,所以 Haghia Triada 档案是按书吏和事项分工的。每位书吏还有自己的清单风格(清单长度、是否加总数、同一物品下数量的大小);记有多种物品的泥板按固定顺序开列,谷物在先、葡萄酒在后,不同书吏遵循同一顺序。无花果在其中也有位置。线形文字A没有单独的无花果符号:它用音节 NI 写无花果,后来线形文字B就把这个符号用作无花果的表意符。NI 条目像其他计量物品一样带分数(45%,人员为6%),排在谷物、莎草和油之后、葡萄酒之前,与谷物同时出现的频率高于随机。线形文字B沿袭了这些习惯。它的无花果表意符,也就是同一个 NI 符号,在全部37块同时记录两者的线形文字B泥板上都跟在谷物之后,带次级单位的频率也与线形文字A中 NI 带分数的频率相当(44%对45%)。线形文字B同样把谷物列在最前,把最大的数量放在第一位,物品清单按从大到小排列。葡萄酒殿后是它唯一没有保留的线形文字A习惯。另一个差别在记法上:线形文字A清单只在开头写一次物品符号,其余默认(38%的条目带有它)。线形文字B在物品清单中几乎每一行都重复表意符(克诺索斯82%,Pylos 86%,没有实质差别);克诺索斯人员清单的比例较低,原因在于它的妇女儿童泥板,那里女孩和男孩两行写的是各自的词而不是 MUL,还在于两份长名单(书手102和105),十几个名字只写一两次 VIR,正是线形文字A的写法。线形文字B泥板同样把谷物放在最前,但谷物之后的顺序与线形文字A不一致。写出总数是 Haghia Triada 的习惯:那里18%的泥板以 KU-RO 结尾,Phaistos 和 Zakros 为3%,其他地方没有。同一批人在同一种物品的泥板上反复出现。附在物品符号上的音节有地区差别:Haghia Triada 和 Tylissos 共用一套油的合体字(OLE+U、OLE+KI、OLE+MI),而 Khania 写 OLE+TA,Zakros 写 GRA+PA。Tylissos 共用 Haghia Triada 的油合体字,却不共用它的任何词,所以两地的联系在于记法。一些未读符号也是地方性的(*411、*409 和 *311 只见于 Khania),同一物品的典型数量也因遗址而异:谷物条目在 Haghia Triada 数量大,在 Khania 和 Zakros 数量小,葡萄酒条目则相反。人数在各遗址之间没有差别,所以更可能的解释是各遗址计量谷物和葡萄酒的单位不同。有两组泥板重复了整组条目,HT 86 与 HT 95,ZA 4 与 ZA 15:这是写了两遍的清单。三个反复出现的词可以确定功能,但不知含义:
- SA-RA2:一个只在 Haghia Triada 使用的交易术语,与谷物和莎草连用,见于20条记录。
- A-DU 和 KA-PA:标题术语。
每条记录的完整读法(reading/edition.txt,由 targets/lineara/reading/build_reading.py生成)没有放进公开仓库,因为它所依据的数字文本没有许可协议。可应要求提供。
总数。全部35个 KU-RO 和 PO-TO-KU-RO 总数都用精确分数重新核对过。对每个总数,在几种范围内对条目求和:从泥板开头算起、从最后一条横线算起、在 KI-RO 标题之后、跨物件的两面,以及按物品分别求和。
- 十个对得上。HT 123a 的橄榄总数,只有把其橄榄条目与泥板上其他物品分开求和才对得上:31 + 31½ + 16 + 15 = 93½。下图重演了这块泥板。
- 其余的对不上,原因是残损,或是早已为人所知的笔误。HT 9a 差¾,HT 13 差½,HT 94a 和 HT 119 差1。HT 122 的总计是97,而两面相加为 31 + 65 = 96。
- 用算术复原。凡总数完好而其上清单残损的,缺失的数量可以推出:HT 11a 为4,HT 100 为4,HT 122a 为9,HT 27a 为13。有五个总数在任何范围内都对不上,只能由泥板本身来裁决。
- 对数字文本的一处订正。数字文本把 HT 34 的 KI-RO 记作37,而 Younger 和 GORILA 记作30,7已被抹去。
跨泥板。同样的条目词在不同泥板上反复出现的频率远超随机。有四对记录共用三个或以上的名字,期望值为0.1。由此得出三项发现:
- A-KA-RU 和 A-DU 是交易类别。五个人(DA-ME、DI-DE-RU、KU-NI-SU、MI-NU-TE、SA-RU)在 HT 86 和 HT 95 上领取谷物,分列在 A-KA-RU 和 A-DU 两个标题下。在 HT 86a 上他们每人得20。在 HT 95b 上,五人全都列在 A-DU 下,每人10,恰好一半。这两个词用于同一批人,所以它们既不是人名也不是地名。
- PA3 标记已交付的部分。HT 9 正面是一份葡萄酒账目(总数31¾),背面在 PA3 之下重复了同样的名字(总数24)。背面每个共有的数量都等于或小于正面的数量:5¾ → 3,10 → 8,4 → 4,2 → 2,2½ → 2,2½ → 2。HT 34 也是同样的格局:100,PA3 70,KI-RO 30。这支持了 Younger 的推测,现在有两块泥板为证。
- KI-RO 清单计的是个人。KI-RO 部分(HT 88、94b、117a)中的每个名字都恰好带1,不管同一个名字在别处带多少:KU-PA3-NU 在 HT 1 上有109,SA-RU 有20份谷物。
这些是功能,不是翻译。
跨遗址看,情况正好相反。只有10个条目词出现在不止一个遗址,随机期望为33(p = 0.0005)。每个档案都有自己的一套名字。少数跨遗址出现的词大多是行政用语:A-DU 见于 Haghia Triada 和 Tylissos,DA-RE 见于 Haghia Triada、Palaikastro 和 Khania。这表明 DA-RE 也是一个术语而非人名。
04 分数符号与 HT 34
线形文字A用专门的符号书写分数,按惯例记作 J、E、F、K、L2、B、D、H、A 以及几个较少见的符号。它们的数值本身就是一个小小的密码问题。只有一块泥板能干净地确定一个值:HT 104,其中 45 J + 20 J + 29 = 95,所以 J = ½。规模最大的研究,Corazza、Ferrara、Montecchi、Tamburini 和 Valério(2021),提出 J ½、E ¼、F ⅛、H 1/16、A 1/24、B ⅕、D ⅙、K 1/10、L2 1/20。他们是通过约束搜索和最优性得出这些值的。
复合分数按从大到小书写。在读那篇论文之前,本项目收集了语料中每个条目内的所有分数符号序列,共296个,并记录了符号两两之间的书写顺序。然后用这些顺序对检验已发表的数值。较早的数值(B = ⅓)在 KH 9 上不成立。2021年的数值在一个确凿的例子上不成立:
- HT 34 第3行有一个写作 2 H K 的数量。三个来源对这个顺序意见一致:GORILA 摹本、lineara.xyz 文本和 SigLA。既然按从大到小书写,H 必须大于 K。2021年的论文只允许 H 取1/16或更小(其28个最佳解给出1/16到1/84),而 K 是1/10。
- 在那个体系内,H 取任何值都解决不了。其他值保持论文的数值,并采用论文自己的规则,即一个值只有一种记法。类型学上有据可查、能让 H 大于 K 的值只有⅓、⅖、3/20和3/10,而每一个都已由一个有据可查的复合写法表示(D D、B B、K L2、E L2)。
- 第二处较弱的矛盾。Younger 把 HT 34 的最后几行读作对前面各项的结算,其中 PU F 结算的是写作 A 的那一项。按这种读法,F(⅛)至多等于 A,而 A 是1/24。
作者们自己也说,最优性并没有确定 H 和 A,这两个值是根据结构上的理由选定的。HT 34 是这两个值的反例,而不是另一套体系:只有29个顺序对,证据太薄,撑不起一套体系。引用2021年论文的18篇著作中,没有一篇修订这些数值。该团队后来自己的论述,Corazza 的 Computational methods for undeciphered scripts(2024),重复了“A = 1/24?, H = 1/16?”,仍标为暂定,也没有讨论 HT 34。就网上能查到的资料而言,这个矛盾以前没有人提出过。Salgarella 2025年的书不开放获取,没有核查。要有把握地称这一点为新发现,只剩它这一项未查。把每个分数对按其物品分类,也挽救不了已发表的数值:三个例外分属三种不同的物品,而 HT 34 的那一对是语料中唯一同时含 H 和 K 的。
新证据即将到来。2024年在克诺索斯出土的象牙柄 KN Zg 58 上连续刻有六个不同的分数符号。发掘者说,这个序列给出的数值顺序与所有已发表的方案都不同(Kanta、Nakassis、Palaima 和 Perna 2025),但他们把它留到正式刊本中发表。这个序列,再加上一张 HT 34 第3行的清晰照片(Heraklion Museum,HM 22),就能解决这个问题。一份阐述 HT 34 论证的两页短文已起草,见 targets/lineara/note_HT34/.
05 奠酒程式
克里特各地山顶圣所出土的供奉器皿上,刻有一个反复出现的词序列。在来自7个遗址的14条铭文中,其各个槽位的顺序在78对中有77对保持不变:
A-TA-I-*301-WA-JA · [地名词] · JA-SA-SA-RA-ME · U-NA-KA-NA-SI · I-PI-NA-MA · SI-RU-TE · TA-NA-…-U-TI-NU
唯一的倒序出现在 IO Za 6 上。变化出在一个前缀上,它可以是 JA-、A- 或没有,并在槽位之间移动:
- 地名词在 Iouktas 是 JA-DI-KI-TU,在 Palaikastro 则是 A-DI-KI-TE;
- JA-SA-SA-RA-ME 与 A-SA-SA-RA-ME 和 SA-SA-RA-ME 交替出现;
- PK Za 8 写作 JA-SA-U-NA-KA-NA-SI。
A-DI-KI-TE 写在 Palaikastro,那里后来是狄克特宙斯崇拜的中心。这与已发表的读法“Dikte”相符,但这只是背景,不是证据。槽位顺序和前缀就是目前能看到的这个程式的语法。这些词是什么意思无人知晓:JA-SA-SA-RA-ME 通常被视为神名,而证据也就只能走到这一步。这次量度证实了 Davis(2014)等人的描述。
06 泥板大概在说什么:有根据的猜测
本页其余部分都是量度出来的。这一节是解释。它列出量度结果所支持的最可能的图景,并说明每一部分依据什么。这里不翻译任何词;所猜测的是这些条目的用途。
这个档案是什么。大多数泥板来自 Haghia Triada,它们之所以留存下来,是因为建筑在公元前1450年前后焚毁,把本不打算烧制的泥板烤硬了。未经烧制的泥板是日常工作记录,在当前的会计周期内保存,之后就被抹平或丢弃。它们大概涵盖了火灾前的最后几个月:是当时的事务,而不是历史。数量都不大,从个位数到几百。每个遗址都有自己的一套名字(只有10个条目词出现在两个遗址,随机期望为33),各自按自己的尺度计量谷物和葡萄酒。最可能的情形是一个管理自己辖区的地区中心,而不是一个覆盖全克里特的统一机构。
进出的物资。这些物资是青铜时代爱琴海经济的基本物资:数量最大的是谷物,其次是葡萄酒、按附于油符号的音节区分的几种油、橄榄和无花果。还有莎草,一种芳香植物,线形文字B记录中用它制作香油。大多数条目把一个词(大概是人名或工作队头领)与一个数量配对。有些可能是发给依附者和劳工的配给;另一些可能是当地家户应缴的份额。泥板上已有释义的词中,没有一个标明物资的流向,所以方向是从少数几个功能明确的术语推断出来的。
欠账与交付。最清楚的术语都与义务有关。KU-RO 是总数,KI-RO 是仍然欠着的短缺。PA3 大概标记实际交付的部分:在 HT 34 上,应交100,交来70,欠30。KI-RO 大概与 Pylos 线形文字B中的 o-pe-ro(“欠着、缺少”)作用相同,既用于未交付的物资,也用于没有到场的人。KI-RO 部分中的每个名字都恰好带1,不管同一个名字在别处带多少。这更像一份缺席者名单,而不是一份小额欠账清单。
用大白话复述两块泥板。以下是意译。数字和术语 KU-RO、KI-RO、PA3 照泥板原样;人物的角色是猜测。
HT 88。A-DU 账:人,二十。随 RE-ZA 六人,随 KI-KI-NA 七人。短缺:KU-PA3-PA3、KA-JU、KU-PA3-NU、PA-JA-RE、SA-MA-RO、DA-TA-RE,各一。短缺合计:六。
大概是一份劳役名册:征调二十人,部分通过两名队头提供,另有六名具名者缺席或仍欠着。
HT 9。正面:每个名字对应葡萄酒,共31¾。背面,在 PA3 之下:同样的名字,数量相同或更少,共24。
大概是一张征收单:先记每人应缴的葡萄酒,再记每人实际交付的数量。
账目的种类。A-DU 和 A-KA-RU 用于同样的五个人:他们在 HT 86 上于前者名下各领20份谷物,在 HT 95 上于 A-DU 名下各领10份,恰好一半。这两个词大概是两种配给或义务:一种常规发放和一种特别发放,或者两期分付、两个季节。SA-RA2 只在 Haghia Triada 与谷物和莎草连用,是另一个交易术语。早先的学者曾把它与阿卡德语 šarāku(“分配”)相比。第07节的语言检验没有发现任何闪米特语信号,所以这一比较仍缺乏支持。DA-RE 能像名字所不能的那样跨遗址出现,大概也是一个术语。
收据与标签。圆形泥饼和泥封上有一个印章印痕和一两个符号。可能的解读是收据和标签:圆形泥饼记录一笔由持印人见证的单次交易,泥封则用来封住包裹或写在易朽材料上的文书。它们的符号因遗址而异,也与泥板上的单个符号不同,所以每个中心都有自己的一套地方收据系统。
供奉品。石制器皿上刻着看似献辞的内容,也许是“[献者]在[圣所]将此献给[神祇]”,后面跟着称号或祈求。地名槽位随圣所而变(Dikte、Iouktas),其余部分保持不变,这正是程式的特征。JA-SA-SA-RA-ME 通常被视为神名,有人把它与一个意为“我的夫人”的卢维语短语相比。这里的检验同样不支持这一比较。
整体图景。最可能的图景是一个中等规模的米诺斯中心,为其辖区运作一套再分配经济。它向当地家户和生产者征收谷物、葡萄酒和油,向具名的个人和工作队发放物资,并仔细记录仍然欠着的部分。它的书吏按部门和物品分工。它的做法与邻近各中心不同;在记账之外,同一个社会还在山顶圣所举行正式的供奉。迈锡尼希腊人接管克诺索斯后,保留了这套记账法的许多做法:谷物居首、无花果紧随谷物、最大数量排在第一。
猜测最薄弱之处。最薄弱的地方是物资的流向,以及那些具名者是什么人:管事、农民、工头还是依附者。KU-PA3-NU 是一个真实的人,在 HT 1 上经手了109个单位的某种东西,但那是一笔支付、一笔欠账还是一份存货,只能推断。一份双语文本可以检验这些猜测,一个在线形文字B中以已知含义出现的线形文字A术语也可以。
07 用随机水平检验被提出的语言
米诺斯语曾被说成闪米特语、卢维语、胡里安语、类伊特鲁里亚语等等,通常依据的是形似的词:KU-RO“总数”对闪米特语的 kull“全部”,诸如此类。这里的检验要问的是:一种被提出的亲属语言,与线形文字A的吻合程度是否好于那些不可能与之有亲缘关系的语言。
方法。每部词典的词都按线形文字B拼写词的方式来拼:开音节、去掉词末辅音、l = r、不区分清浊。这些规则在看到任何结果之前就已定好,它们把 Knossos 变成 ko-no-so,把 Phaistos 变成 pa-i-to。统计与491个三符号及以上的线形文字A词型完全吻合的数量。每种语言还要与把其自身音节在词间打乱后的结果作比较。
| 词典 | 类别 | 词形数 | 吻合数 | 与自身音节零模型之比 |
|---|---|---|---|---|
| 卢维语(Melchert 1993) | 已被提出 | 540 | 1 | 0.5 |
| 胡里安语(Laroche 1980) | 已被提出 | 294 | 1 | 1.1 |
| 阿卡德语 | 已被提出 | 336 | 3 | 2.1 |
| 乌加里特语 | 已被提出 | 288 | 4 | 3.3 |
| 伊特鲁里亚语 | 已被提出 | 27 | 0 | 词太少 |
| 古希腊语 | 未被提出 | 28,606 | 27 | 2.3 |
| 夏威夷语、毛利语、约鲁巴语 | 对照 | 1,106 / 1,484 / 2,447 | 4 / 4 / 7 | 2.1 / 1.4 / 2.1 |
即便在无关的语言中,真实词也胜过打乱后的零模型,所以关键在于被提出的语系是否比对照语言胜出得更多。没有一个做到:
- 闪米特语:2.7倍,对照为1.7倍,p = 0.22(对四个语系作校正后为0.86)。
- 卢维语:低于随机水平。
- 伊特鲁里亚语:公开词典太小,无法检验。
- 胡里安语:用 Laroche 的 Glossaire de la langue hourrite(1980)检验,1个吻合,期望值0.9(p = 0.6)。无论词典中的 ḫ 怎么拼,结果都一样。
单个的吻合看起来像证据,直到把对照放在旁边。E-KU-RU 是阿卡德语 eqlum“田地”,也是约鲁巴语 eguru“砂岩”。A-KA-TA 是希腊语 akantha,也是约鲁巴语 akata“豹”。对于算术已确定含义的三个词(KU-RO、KI-RO、PO-TO-KU-RO),没有一种候选语言能提供拼写相同、含义相符的词,而对照语言倒能提供含义不对的形似词(约鲁巴语 kuro、夏威夷语 kilo)。
问题出在方法本身。把它用在答案已知的唯一例子上,即希腊语对线形文字B,每1,000个希腊语词得到13个吻合。约鲁巴语对同一份线形文字B词表,每1,000个词得到22个。以候选词典的规模,即便关系像希腊语与线形文字B那样密切,也只会产生不到一个完全吻合。词形吻合无法确定米诺斯语的亲属,甚至连希腊语是线形文字B的语言都确定不了。建立在其上的破译,无论正反都算不上证据。
埃特奥克里特语,可能的后裔。来自 Praisos 和 Dreros 的五篇铭文(公元前7–3世纪)用希腊字母记录了一种非希腊语言,人们常认为它是米诺斯语的后裔。它的读音是已知的,但大部分没有分词,所以在把两者都按线形文字B方式拼写之后,在文本内部搜索线形文字A词。没有一个三符号及以上的线形文字A词出现在其中。同等规模的夏威夷语、毛利语或约鲁巴语随机词表能产生一到三个这样的命中。这个设计几乎不灵敏:在同样长度的希腊语中,线形文字B词也只出现两三次。所以这个结果微弱地不支持米诺斯语与埃特奥克里特语非常接近,而对较远的关系则无法检验。
前希腊底层。希腊语保留了许多来自其之前所说语言的词,Wiktionary 标出了约1,600个。与同样长度的普通希腊语词相比,这些词与线形文字A吻合得略多:6对2.6,其中有 ákantha“荆棘植物”对 A-KA-TA,kídalon“洋葱”对 KI-DA-RO。去掉唯一共有的地名 Phaistos 后,超出部分就消失了(p = 0.10)。那些线形文字A词是清单中的人名,不是植物或器皿。按音节分布,前希腊语并不比普通希腊语更接近线形文字A。
克里特象形文字,更早的克里特文字。其符号组(Younger 的词表,365组)按 CHIC 依符号形状指定的音值来读。这样能完整读出的只有20组,它们与线形文字A的吻合并不多于随机(3对2.2)。Younger 更完整的音值表确实能产生吻合(17对11)。但那张表部分是靠把象形文字符号组与线形文字A词相匹配建立起来的,所以超出部分什么也证明不了。要证明两种文字之间词汇的连续性,需要独立确定符号的音值。
本项目能做的所有比较现在都已在同样的规则和对照下做过:四个被提出的语系、可能的后裔以及已知的接触词汇。没有一个能确定这种语言。
08 词的结构
此前这里做过一轮工作,把 lineara.xyz 文本与 SigLA 对勘。结果发现,只差一个附加符号的词对比两种随机化模型的预测更多(42对约23和26,校正后 p ≈ 0.01)。例子有 PA-RA-NE / A-PA-RA-NE 和 DA-KU-SE-NE / DA-KU-SE-NE-TI。所以线形文字A的词有有序的结构,即词缀或复合。检验后没有留下任何后缀多于前缀的倾向。认为 A- 标记标题的想法在 ZA 10a 上不成立,那里 TA-NA-TE 和 A-TA-NA-TE 都是普通条目。这些是对未来任何破译的约束,而不是含义。
Alice Kober 当年是通过把同一词干配不同词尾、在不同语法位置上排列起来,发现线形文字B的屈折变化的。这里用同样的检验来问:在共用一个词干的一族词中,词尾能否预测词的位置(标题、清单条目、程式、封印)。答案是不能,没有超出随机(p = 0.20,49个词族)。词首的 A-/JA- 偏向标题,如 A-KA-RU、A-PA-RA-NE 和 A-RI-JA 对应条目中的无前缀形式,但并不显著(p = 0.07,12个词族)。没有一个词族的出现次数超过九次,而 Kober 的方法需要每个词干有远多于线形文字A所能提供的实例。
09 本文增添了什么,没有增添什么
- 已发表分数值的一个反例。按该体系自己的规则,HT 34 与 H = 1/16 和 A = 1/24 相矛盾。网上能查到的文献中没有讨论过它(第04节)。
- 对各种语言假说的校准检验。闪米特语、卢维语、胡里安语等的表现并不比夏威夷语或约鲁巴语好,埃特奥克里特语和前希腊底层也都没有显示出可靠的联系。阳性对照表明,在这个规模上,形似匹配无法确定一种语言(第07节)。
- 克诺索斯的米诺斯人名。留存到线形文字B中的线形文字A词是名字,数量显著高于随机,而且全部来自克诺索斯,其中有 TA-NA-TI、KI-DA-RO、DA-I-PI-TA 和 I-TA-JA。此外,克诺索斯人名整体在形态上是米诺斯式的,而 Pylos 人名不是(第02节)。
- 跨泥板的记账功能。A-KA-RU 和 A-DU 是施于同一批人的类别。PA3 标记已交付的部分,KI-RO 清单按每人一计数(第03节)。
- 对数字文本的订正:HT 34 的 KI-RO 是30,不是37。一个第三方 SigLA 解码器中的某个字段标注有误;它存放的是符号位置和词序号,而不是边界状态。两个数字版本的逐词比较列出了44处分歧,供其编者参考(
targets/lineara/ERRATA.md)。其中有一种系统性的 JA/PA3 混淆,以及三处影响这里结果的读法:SigLA 中的 SU-KI-RA-TA、PA-RI-NE 和 DA-ZA。 - 重复验证,现在在整个语料上量度:线形文字B音值的沿用(此前 Packard 以及 Steele 和 Meissner 都论证过);KU-RO、KI-RO 和 PO-TO-KU-RO;地名;人名清单;程式顺序。不依赖语言就能读出的语料比例(词符的41.8%)是在这里量度的;没有找到此前对它的量度。其中没有新的读法。
- 关于语言本身,一无所获。没有给任何词赋予新含义,也没有任何语系得到支持。
10 仍未解决的问题
- 2,164个只能读出读音的词符的含义(人名、交易术语、程式用词)。受阻原因:语言未被识别,也不存在双语文本。
- 632个未识别的符号和合体字(*301、*304、*308、QA2+…、MI+JA+…)。它们在线形文字B中没有对应,也没有上下文能确定它们。
- 分数符号 H 和 A,以及罕见的 L、W、X、Y 和 DD。出现次数太少。
- 残损的条目和总数。复原方案见
targets/lineara/reading/restorations.json. - 封印上的631个单符号标记。每件物品一个符号,没有句法。
- 五个在任何范围内都对不上的总数:HT 13、HT 25b、HT 102、HT 122b 和 PH(?) 31a。只有检视泥板本身才能判断是书吏出错还是转录出错。
- 更完整的伊特鲁里亚语检验。有待更大的公开词典。
- Salgarella,Writing in Bronze Age Crete(2025)。不开放获取。借到一本馆藏就能确定其中是否讨论了 HT 34。
- Anetaki 权杖(KN Zg 57–58),约119个符号,最长的线形文字A文本。尚无已发表的转录(Kanta,即将出版)。
- 一张 HT 34 第3行的照片。只有 Heraklion Museum 能提供。
除此之外,要取得进展需要新材料:一份双语文本,或者大得多的语料。
11 资料来源
- L. Godart and J.-P. Olivier, Recueil des inscriptions en linéaire A (GORILA), 5 vols, Paris 1976–85.
- R. Hogan,Linear A Explorer(lineara.xyz),commit 43fe7cf,附 J. Younger 的注释和 G. Douros 的列表;以及 Linear B Explorer(linearb.xyz),commit 84e0b00。
- E. Salgarella and S. Castellan, SigLA: the signs of Linear A, CC BY-NC-SA 4.0.
- M. Corazza, S. Ferrara, B. Montecchi, F. Tamburini and M. Valério, “The mathematical values of fraction signs in the Linear A script”, Journal of Archaeological Science 125 (2021), 105214; M. Corazza, Computational methods for undeciphered scripts (Bologna 2024).
- E. Salgarella, “Linear A”, Oxford Classical Dictionary (2022), and Writing in Bronze Age Crete (2025).
- P. M. Steele, Exploring Writing Systems and Practices in the Bronze Age Aegean (2023).
- B. Davis, Minoan Stone Vessels with Linear A Inscriptions (Aegaeum 36, 2014).
- J. Chadwick and M. Ventris,Documents in Mycenaean Greek,第2版(1973),词汇表类别取自 tiripode 词典(MIT 许可)。
- J. Luo, Y. Cao and R. Barzilay,“Neural decipherment via minimum-cost flow”(2019):第02节所用的线形文字B词表。
- A. Kanta, D. Nakassis, T. G. Palaima and M. Perna, “An archaeological and epigraphical overview of some inscriptions found in the Cult Center of the city of Knossos (Anetaki plot)”, Ariadne (2025) 27–43, doi.
- DAMOS,Database of Mycenaean at Oslo(damos.hf.uio.no),CC BY-NC-SA 4.0;J. Younger,克里特象形文字词表和符号表(存档网页,2007–2012),依据 J.-P. Olivier and L. Godart,Corpus Hieroglyphicarum Inscriptionum Cretae(1996)。
- R. A. Brown,埃特奥克里特语铭文转录(Dreros 1–2、Praisos 1–3),存档自其埃特奥克里特语网页;Y. Duhoux,L’Étéocrétois: les textes, la langue(Amsterdam 1982)。
- 前希腊词表:Wiktionary 中源自前希腊语的古希腊语词条(经由 Kaikki),大多依据 R. Beekes 和 E. J. Furnée。
- E. Laroche,Glossaire de la langue hourrite(Paris 1980);Internet Archive 上的 OCR 文本,仅用于计数。
- H. C. Melchert,Cuneiform Luvian Lexicon(1993)。阿卡德语、乌加里特语、伊特鲁里亚语、古希腊语及对照语言词典来自 Wiktionary,经由 Kaikki。
脚本、结果和笔记见 targets/lineara/。读法脚本是 targets/lineara/reading/build_reading.py,而 targets/lineara/FRACTIONS_REPORT.md 给出完整的分数分析, targets/lineara/LEADS_REPORT.md 是语言和人名检验。